本节将详细介绍核心服务的实现,包括 PlanningService、SummarizationService、ReportingService 和 SearchService。这些服务是连接 Agent 和工具的桥梁,负责具体的业务逻辑。
14.5.1 任务规划服务
PlanningService负责调用研究规划 Agent,将研究主题分解为子任务。这是整个研究流程的第一步,也是最关键的一步。
(1)方案实现
它的核心职责是:
- 构建规划 Prompt:根据研究主题和当前日期构建 Prompt
- 调用规划 Agent:调用 TODO Planner Agent 生成子任务列表
- 解析 JSON 响应:从 Agent 的响应中提取 JSON 格式的子任务列表
- 验证子任务格式**:确保每个子任务包含必需的字段(title、intent、query)
import re
import json
from typing import List, Callable, Optional
from datetime import datetime

from hello_agents import HelloAgentsLLM
from hello_agents import ToolAwareSimpleAgent
from models import TodoItem, SummaryState
from prompts import todo_planner_instructions

class PlanningService:
    """任务规划服务"""

    def __init__(
        self,
        llm: HelloAgentsLLM,
        tool_call_listener: Optional[Callable] = None
    ):
        self._llm = llm
        self._tool_call_listener = tool_call_listener

        # 创建规划Agent
        self._agent = ToolAwareSimpleAgent(
            name="TODO Planner",
            system_prompt="你是一个研究规划专家,擅长将复杂的研究主题分解为清晰的子任务。",
            llm=llm,
            tool_call_listener=tool_call_listener
        )

    def plan_todo_list(self, state: SummaryState) -> List[TodoItem]:
        """规划TODO列表

        Args:
            state: 研究状态,包含研究主题

        Returns:
            子任务列表
        """
        # 构建Prompt
        prompt = todo_planner_instructions.format(
            current_date=self._get_current_date(),
            research_topic=state.research_topic,
        )

        # 调用Agent
        response = self._agent.run(prompt)

        # 解析JSON
        tasks_payload = self._extract_tasks(response)

        # 验证并创建TodoItem
        todo_items = []
        for idx, item in enumerate(tasks_payload, start=1):
            # 验证必需字段
            if not all(key in item for key in ["title", "intent", "query"]):
                raise ValueError(f"任务{idx}缺少必需字段")

            task = TodoItem(
                id=idx,
                title=item["title"],
                intent=item["intent"],
                query=item["query"],
            )
            todo_items.append(task)

        return todo_items

    def _get_current_date(self) -> str:
        """获取当前日期"""
        return datetime.now().strftime("%Y年%m月%d日")

    def _extract_tasks(self, response: str) -> List[dict]:
        """从Agent响应中提取JSON

        Agent的响应可能包含额外的文本,如:
        "好的,我将为您规划以下任务:\n[{...}, {...}]\n这些任务涵盖了..."

        我们需要提取其中的JSON部分。
        """
        # 方法1:使用正则表达式提取JSON数组
        json_match = re.search(r'\[.*\]', response, re.DOTALL)
        if json_match:
            json_str = json_match.group(0)
            try:
                return json.loads(json_str)
            except json.JSONDecodeError as e:
                raise ValueError(f"JSON解析失败:{e}")

        # 方法2:如果没有找到JSON数组,尝试直接解析整个响应
        try:
            return json.loads(response)
        except json.JSONDecodeError:
            raise ValueError("无法从响应中提取JSON")
(2)JSON 解析与验证
Agent 返回的 JSON 可能包含额外的文本或格式错误,我们需要 robust 的解析逻辑:
常见问题:
- 包含额外文本:Agent 可能在 JSON 前后添加说明文字
- 格式错误:JSON 可能缺少引号、逗号等
- 字段缺失:某些子任务可能缺少必需字段
解决方案:
- 使用正则表达式:提取 JSON 部分
- 多种解析策略:先尝试提取 JSON 数组,再尝试直接解析
- 字段验证:确保每个子任务包含必需字段
示例:
# Agent响应示例1:包含额外文本
response1 = """
好的,我将为您规划以下任务:

[
  {
    "title": "什么是多模态模型",
    "intent": "了解基础概念",
    "query": "multimodal model definition"
  },
  {
    "title": "最新的多模态模型",
    "intent": "了解技术现状",
    "query": "latest multimodal models 2024"
  }
]

这些任务涵盖了Datawhale组织的基本信息和核心项目。
"""

# 提取JSON
tasks1 = service._extract_tasks(response1)
# 结果:[{"title": "Datawhale的基本信息", ...}, ...]

# Agent响应示例2:纯JSON
response2 = """
[
  {"title": "Datawhale的基本信息", "intent": "了解组织定位", "query": "Datawhale organization introduction"},
  {"title": "Datawhale的主要项目", "intent": "了解核心内容", "query": "Datawhale projects tutorials 2024"}
]
"""

# 提取JSON
tasks2 = service._extract_tasks(response2)
# 结果:[{"title": "什么是多模态模型", ...}, ...]
(3)规划质量评估
一个好的规划应该满足以下标准:
- 覆盖全面:涵盖主题的所有重要方面
- 逻辑清晰:子任务之间有明确的逻辑关系
- 查询精准:搜索查询能够准确找到相关资料
- 数量适中:3-5 个子任务
我们可以添加一个评估方法:
def evaluate_plan(self, todo_items: List[TodoItem]) -> dict:
    """评估规划质量

    Returns:
        评估结果,包含分数和建议
    """
    score = 100
    suggestions = []

    # 检查数量
    if len(todo_items) < 3:
        score -= 20
        suggestions.append("子任务数量过少,可能遗漏重要信息")
    elif len(todo_items) > 5:
        score -= 10
        suggestions.append("子任务数量过多,可能存在冗余")

    # 检查查询质量
    for task in todo_items:
        if len(task.query.split()) < 2:
            score -= 10
            suggestions.append(f"任务「{task.title}」的查询过于简单")

    # 检查逻辑关系
    # (这里可以添加更复杂的逻辑检查)

    return {
        "score": score,
        "suggestions": suggestions
    }
14.5.2 总结服务
SummarizationService负责调用任务总结 Agent,总结搜索结果。这是研究流程的核心环节,决定了研究的质量。
它的职责是:
- 格式化搜索结果:将搜索结果格式化为易读的文本
- 构建总结 Prompt:根据任务信息和搜索结果构建 Prompt
- 调用总结 Agent:调用 Task Summarizer Agent 生成总结
- 提取来源引用:从总结中提取来源引用
核心代码:
from typing import List, Callable, Optional, Tuple

from hello_agents import HelloAgentsLLM
from hello_agents import ToolAwareSimpleAgent
from models import TodoItem
from prompts import task_summarizer_instructions

class SummarizationService:
    """总结服务"""

    def __init__(
        self,
        llm: HelloAgentsLLM,
        tool_call_listener: Optional[Callable] = None
    ):
        self._llm = llm
        self._tool_call_listener = tool_call_listener

        # 创建总结Agent
        self._agent = ToolAwareSimpleAgent(
            name="Task Summarizer",
            system_prompt="你是一个任务总结专家,擅长从搜索结果中提取关键信息。",
            llm=llm,
            tool_call_listener=tool_call_listener
        )

    def summarize_task(
        self,
        task: TodoItem,
        search_results: List[dict]
    ) -> Tuple[str, List[str]]:
        """总结任务

        Args:
            task: 任务信息
            search_results: 搜索结果列表

        Returns:
            (总结文本, 来源URL列表)
        """
        # 格式化搜索结果
        formatted_sources = self._format_sources(search_results)

        # 构建Prompt
        prompt = task_summarizer_instructions.format(
            task_title=task.title,
            task_intent=task.intent,
            task_query=task.query,
            search_results=formatted_sources,
        )

        # 调用Agent
        summary = self._agent.run(prompt)

        # 提取来源URL
        source_urls = [result["url"] for result in search_results]

        return summary, source_urls

    def _format_sources(self, search_results: List[dict]) -> str:
        """格式化搜索结果

        将搜索结果格式化为易读的文本,包含:
        - 序号
        - 标题

### 报告结构设计

最终报告应该包含以下部分,.......

## 参考文献

### 任务1:什么是多模态模型
- https://example.com/multimodal-model-definition
....

### 任务2:最新的多模态模型有哪些
- https://example.com/gpt4v
....
...
14.5.3 报告生成服务
ReportingService负责调用报告生成 Agent,整合所有子任务的总结。这是研究流程的最后一步,生成最终的研究报告。
它的职责是:
- 格式化子任务总结:将所有子任务的总结格式化为统一的格式
- 构建报告 Prompt:根据研究主题和子任务总结构建 Prompt
- 调用报告 Agent:调用 Report Writer Agent 生成最终报告
- 整理引用:将所有来源引用整理到参考文献部分
核心代码实现:
from typing import List, Callable, Optional, Tuple

from hello_agents import HelloAgentsLLM
from hello_agents import ToolAwareSimpleAgent
from models import TodoItem
from prompts import report_writer_instructions

class ReportingService:
    """报告生成服务"""

    def __init__(
        self,
        llm: HelloAgentsLLM,
        tool_call_listener: Optional[Callable] = None
    ):
        self._llm = llm
        self._tool_call_listener = tool_call_listener

        # 创建报告Agent
        self._agent = ToolAwareSimpleAgent(
            name="Report Writer",
            system_prompt="你是一个报告撰写专家,擅长整合信息并生成结构化的报告。",
            llm=llm,
            tool_call_listener=tool_call_listener
        )

    def generate_report(
        self,
        research_topic: str,
        task_summaries: List[Tuple[TodoItem, str, List[str]]]
    ) -> str:
        """生成最终报告

        Args:
            research_topic: 研究主题
            task_summaries: 子任务总结列表,每个元素是(任务, 总结, 来源URL列表)

        Returns:
            最终报告(Markdown格式)
        """
        # 格式化子任务总结
        formatted_summaries = self._format_summaries(task_summaries)

        # 构建Prompt
        prompt = report_writer_instructions.format(
            research_topic=research_topic,
            task_summaries=formatted_summaries,
        )

        # 调用Agent
        report = self._agent.run(prompt)

        return report

    def _format_summaries(
        self,
        task_summaries: List[Tuple[TodoItem, str, List[str]]]
    ) -> str:
        """格式化子任务总结

        将所有子任务的总结格式化为统一的格式,包含:
        - 任务序号
        - 任务标题
        - 任务意图
        - 总结内容
        - 来源URL
        """
        formatted = []
        for idx, (task, summary, source_urls) in enumerate(task_summaries, start=1):
            formatted.append(
                f"## 任务{idx}:{task.title}\n\n"
                f"**意图**:{task.intent}\n\n"
                f"{summary}\n\n"
                f"**来源**:\n"
            )
            for url in source_urls:
                formatted.append(f"- {url}\n")
            formatted.append("\n")

        return "".join(formatted)
14.5.4 搜索调度服务
SearchService负责调度搜索引擎,执行搜索并返回结果。这是连接 Agent 和 SearchTool 的桥梁。在这里我们没有采用往常一样的使得 simpleAgent 直接调用工具的形式,而是将 SearchTool 的执行结果通过中间层来返回给 Agent,这样会使得 Agent 更加专注处理得到的信息。
它的职责是:
- 调度搜索引擎:根据配置选择搜索引擎
- 执行搜索:调用 SearchTool 执行搜索
- 处理结果:去重、限制 Token、格式化
- 错误处理:处理搜索失败的情况
核心代码:
from typing import List, Optional
import logging

from hello_agents.tools import SearchTool
from config import Configuration

logger = logging.getLogger(__name__)

class SearchService:
    """搜索调度服务"""

    def __init__(self, config: Configuration):
        self.config = config

        # 创建SearchTool
        self.search_tool = SearchTool(backend="hybrid")

    def search(
        self,
        query: str,
        max_results: int = 5
    ) -> List[dict]:
        """执行搜索

        Args:
            query: 搜索查询
            max_results: 最大结果数量

        Returns:
            搜索结果列表
        """
        try:
            # 调用SearchTool
            raw_response = self.search_tool.run({
                "input": query,
                "backend": self.config.search_api.value,
                "mode": "structured",
                "max_results": max_results
            })

            # 提取结果
            results = raw_response.get("results", [])

            # 处理结果
            results = self._deduplicate_sources(results)
            results = self._limit_source_tokens(results)

            logger.info(f"搜索成功:{query},返回{len(results)}个结果")

            return results

        except Exception as e:
            logger.error(f"搜索失败:{query},错误:{e}")
            return []

    def _deduplicate_sources(self, sources: List[dict]) -> List[dict]:
        """去除重复的URL"""
        seen_urls = set()
        unique_sources = []

        for source in sources:
            url = source.get("url", "")
            if url and url not in seen_urls:
                seen_urls.add(url)
                unique_sources.append(source)

        return unique_sources

    def _limit_source_tokens(
        self,
        sources: List[dict],
        max_tokens_per_source: int = 2000
    ) -> List[dict]:
        """限制每个来源的Token数量"""
        limited_sources = []

        for source in sources:
            snippet = source.get("snippet", "")

            # 简单的Token估算:1个Token约等于4个字符
            max_chars = max_tokens_per_source * 4

            if len(snippet) > max_chars:
                snippet = snippet[:max_chars] + "..."

            limited_sources.append({
                **source,
                "snippet": snippet
            })

        return limited_sources
根据配置选择搜索引擎,如图 14.8 所示:
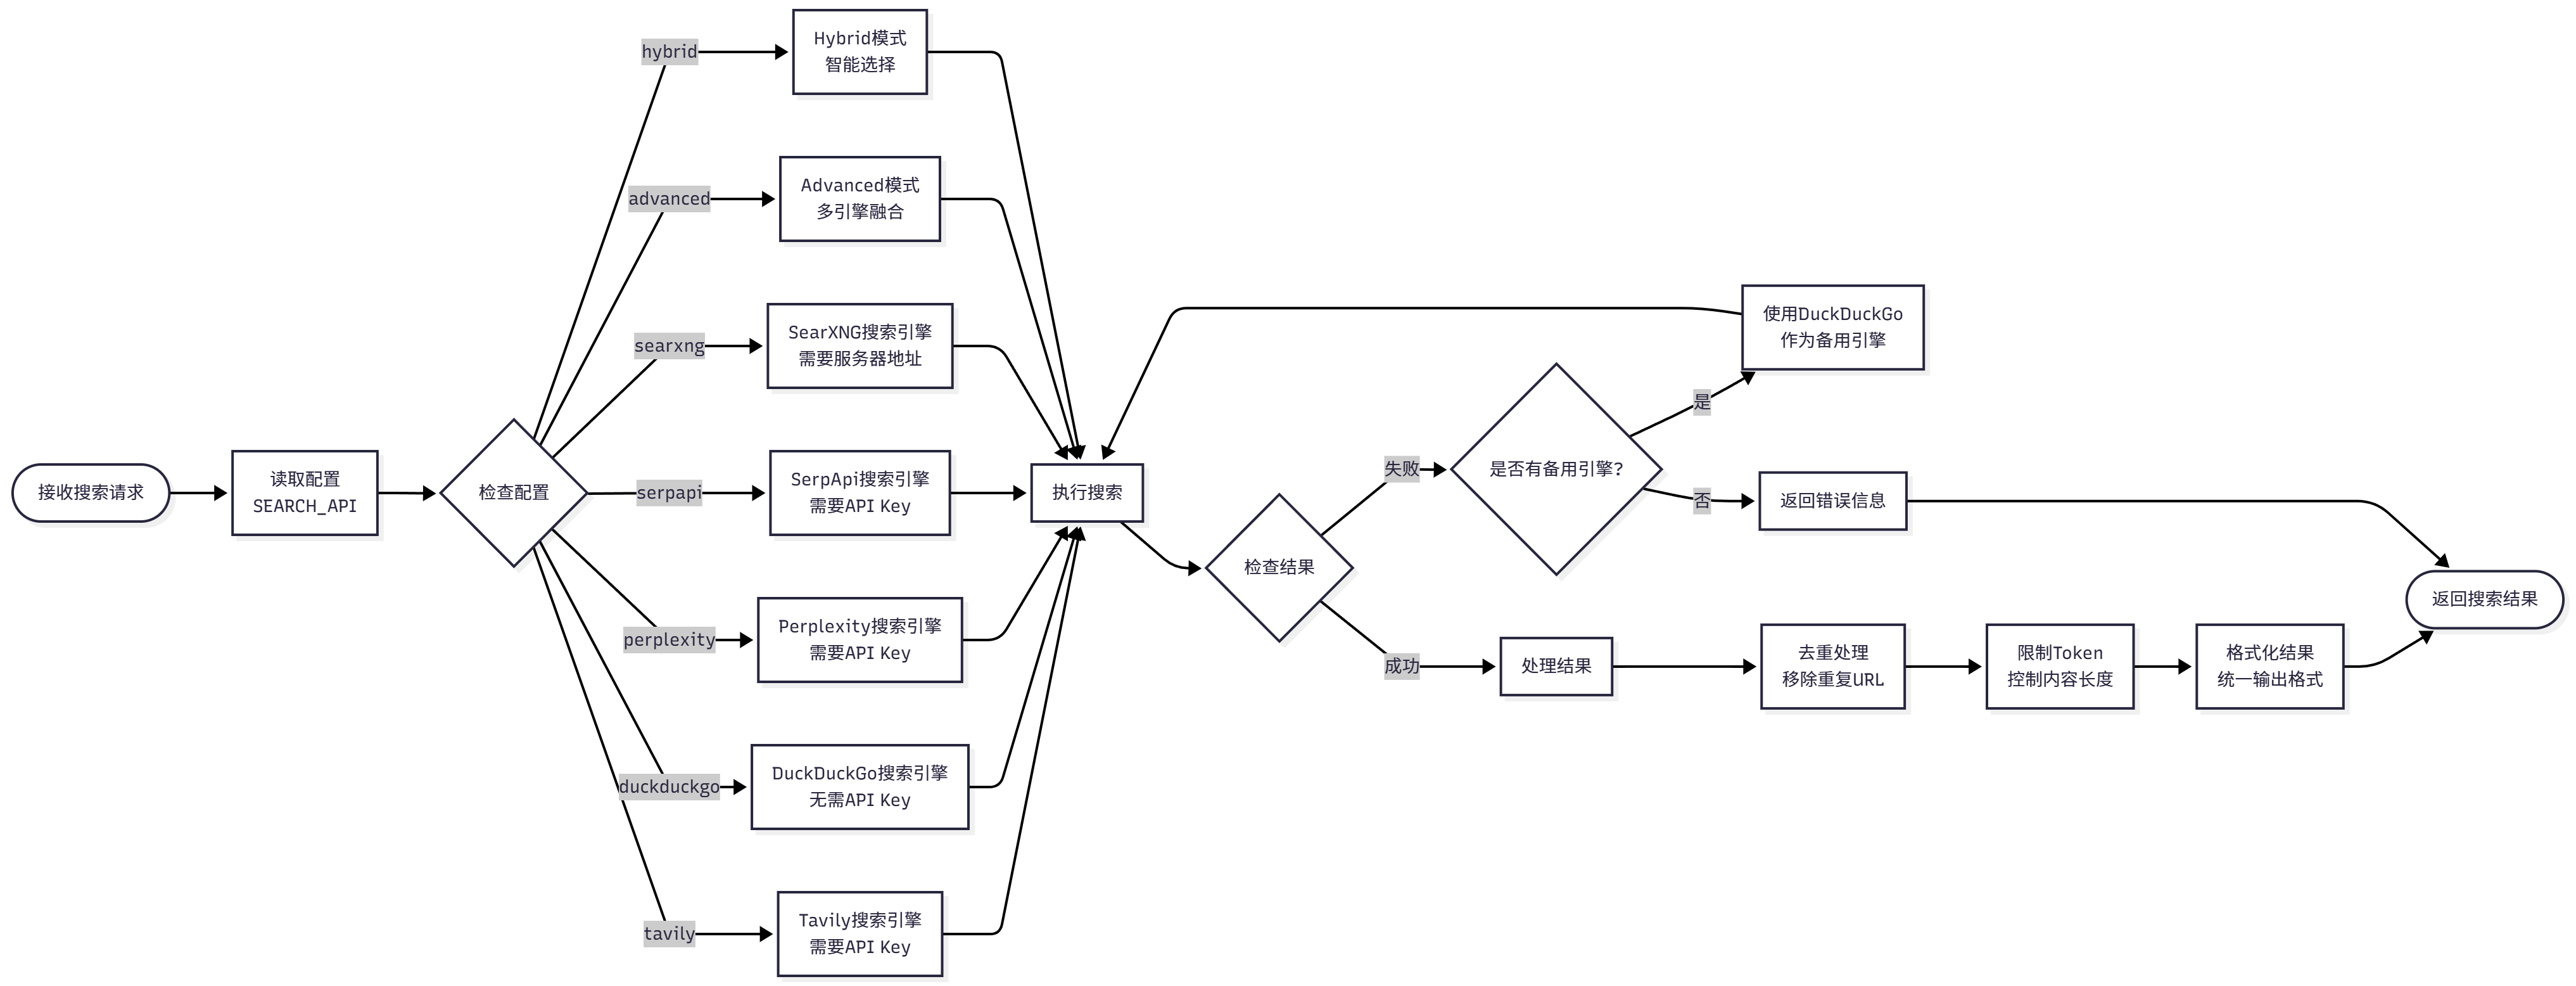
图 14.8 搜索引擎调度流程
**调度逻辑:
- 读取配置:从
.env文件读取SEARCH_API配置 - 选择引擎:根据配置选择搜索引擎(tavily、duckduckgo、perplexity 等)
- 执行搜索:调用 SearchTool 执行搜索
- 处理结果:去重、限制 Token、格式化
- 返回结果:返回处理后的搜索结果
为了提高效率和降低成本,我们可以添加搜索结果缓存:
import hashlib
import json
from pathlib import Path

class SearchService:
    def __init__(self, config: Configuration):
        self.config = config
        self.search_tool = SearchTool(backend="hybrid")

        # 缓存目录
        self.cache_dir = Path("./cache/search")
        self.cache_dir.mkdir(parents=True, exist_ok=True)

    def search(
        self,
        query: str,
        max_results: int = 5,
        use_cache: bool = True
    ) -> List[dict]:
        """执行搜索(带缓存)"""
        # 生成缓存键
        cache_key = self._generate_cache_key(query, max_results)
        cache_file = self.cache_dir / f"{cache_key}.json"

        # 尝试从缓存读取
        if use_cache and cache_file.exists():
            logger.info(f"从缓存读取搜索结果:{query}")
            with open(cache_file, "r", encoding="utf-8") as f:
                return json.load(f)

        # 执行搜索
        results = self._execute_search(query, max_results)

        # 保存到缓存
        if use_cache and results:
            with open(cache_file, "w", encoding="utf-8") as f:
                json.dump(results, f, ensure_ascii=False, indent=2)

        return results

    def _generate_cache_key(self, query: str, max_results: int) -> str:
        """生成缓存键"""
        # 使用查询和最大结果数生成MD5哈希
        content = f"{query}_{max_results}_{self.config.search_api.value}"
        return hashlib.md5(content.encode()).hexdigest()
通过四个核心服务(PlanningService、SummarizationService、ReportingService、SearchService),我们构建了一个完整的研究流程。这些服务各司其职,通过清晰的接口协作,实现了从研究主题到最终报告的自动化流程。