14.1.1 为什么需要深度研究助手
在信息爆炸的时代,我们每天都需要快速了解新的技术、概念或事件。传统的研究方式有几个痛点。首先是信息过载。搜索引擎返回成千上万的结果,你需要逐个点开链接,阅读大量内容,才能找到有用的信息。其次是缺少结构。即使找到了相关信息,这些信息往往是碎片化的,缺少系统性的组织。最后是重复劳动。每次研究新主题时,都需要重复"搜索→阅读→总结→整理"的过程。
这就是深度研究助手需要解决的问题。它不仅仅是一个搜索工具,而是一个能够自主规划、执行和总结的研究助手。
深度研究助手的核心价值:
- 节省时间:将 1-2 小时的研究工作压缩到 5-10 分钟
- 提高质量:系统化的研究流程,避免遗漏重要信息
- 可追溯:记录所有搜索结果和来源,方便验证和引用
- 可扩展:可以轻松添加新的搜索引擎、数据源和分析工具
14.1.2 技术架构概览
此次系统仍然采用经典的前后端分离架构,如图 14.1 所示。
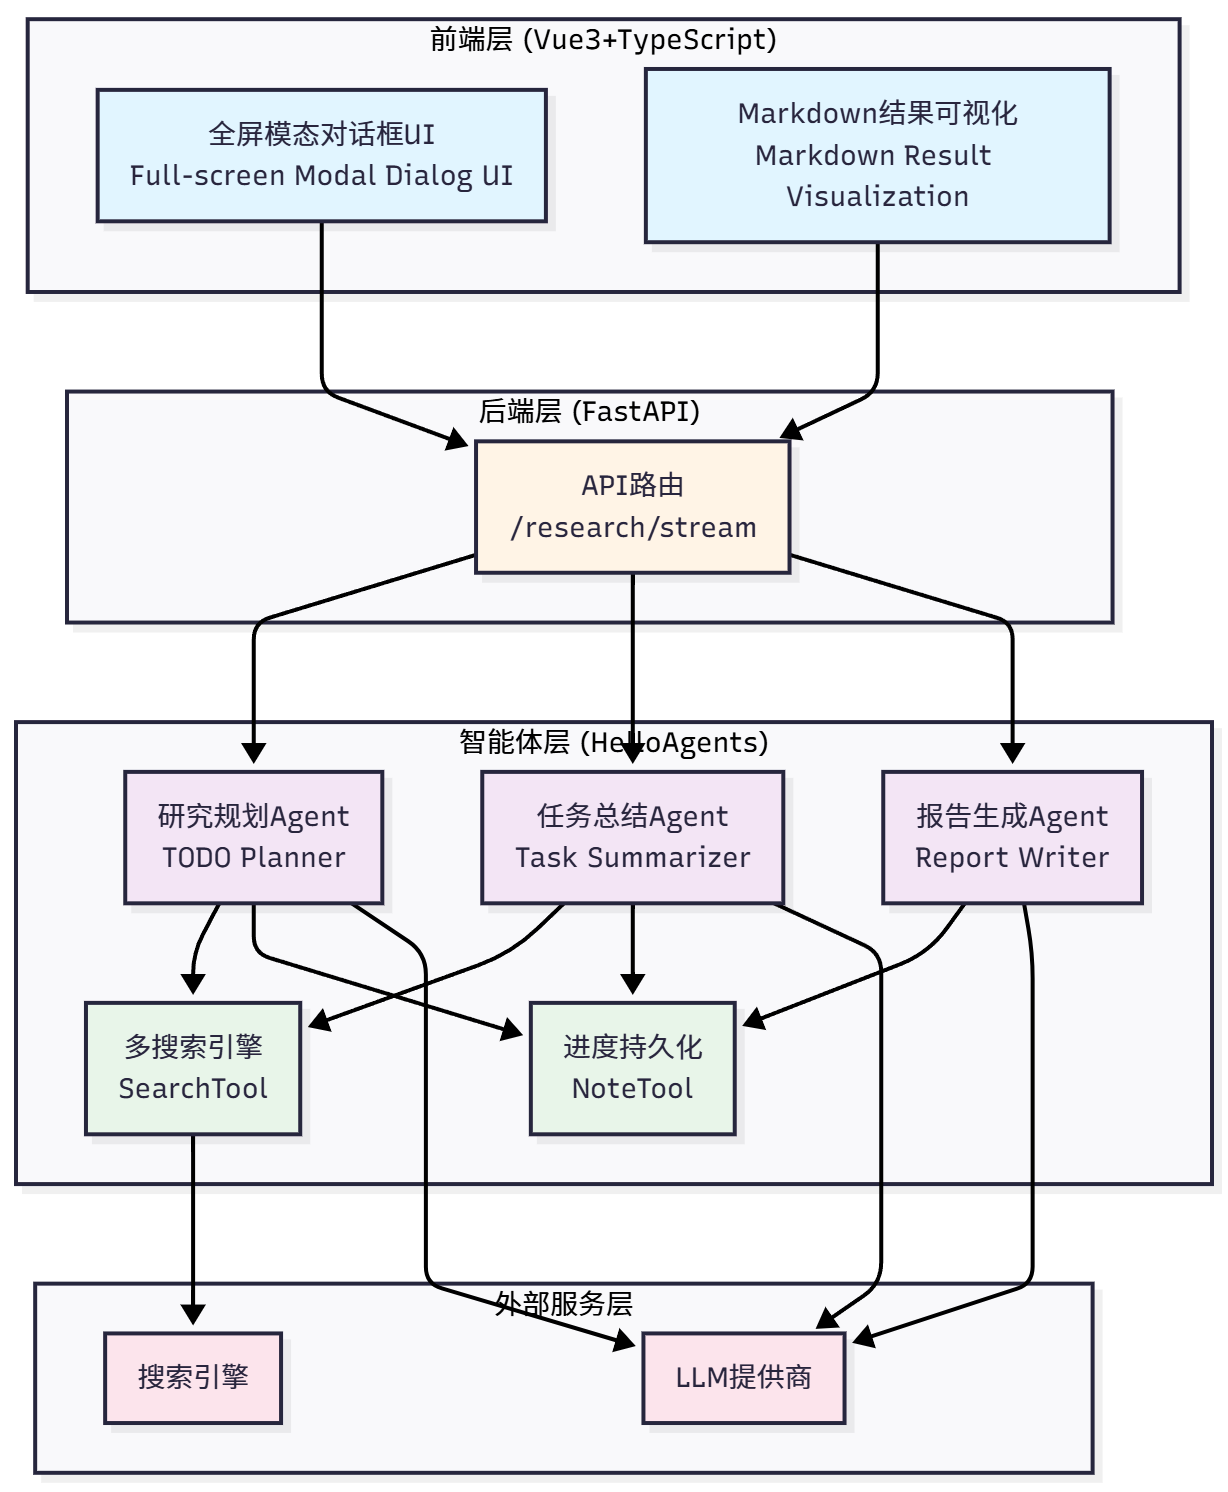
图 14.1 深度研究助手技术架构
系统分为四层架构设计:
前端层 (Vue3+TypeScript):全屏模态对话框 UI、Markdown 结果可视化
后端层 (FastAPI):API 路由(/research/stream)
智能体层 (HelloAgents):三个专门 Agent(TODO Planner、Task Summarizer、Report Writer)+ 两个核心工具(SearchTool、NoteTool)
外部服务层:搜索引擎+ LLM 提供商
让我们看看一个完整的研究请求是如何在系统中流转的,如图 14.2 所示:
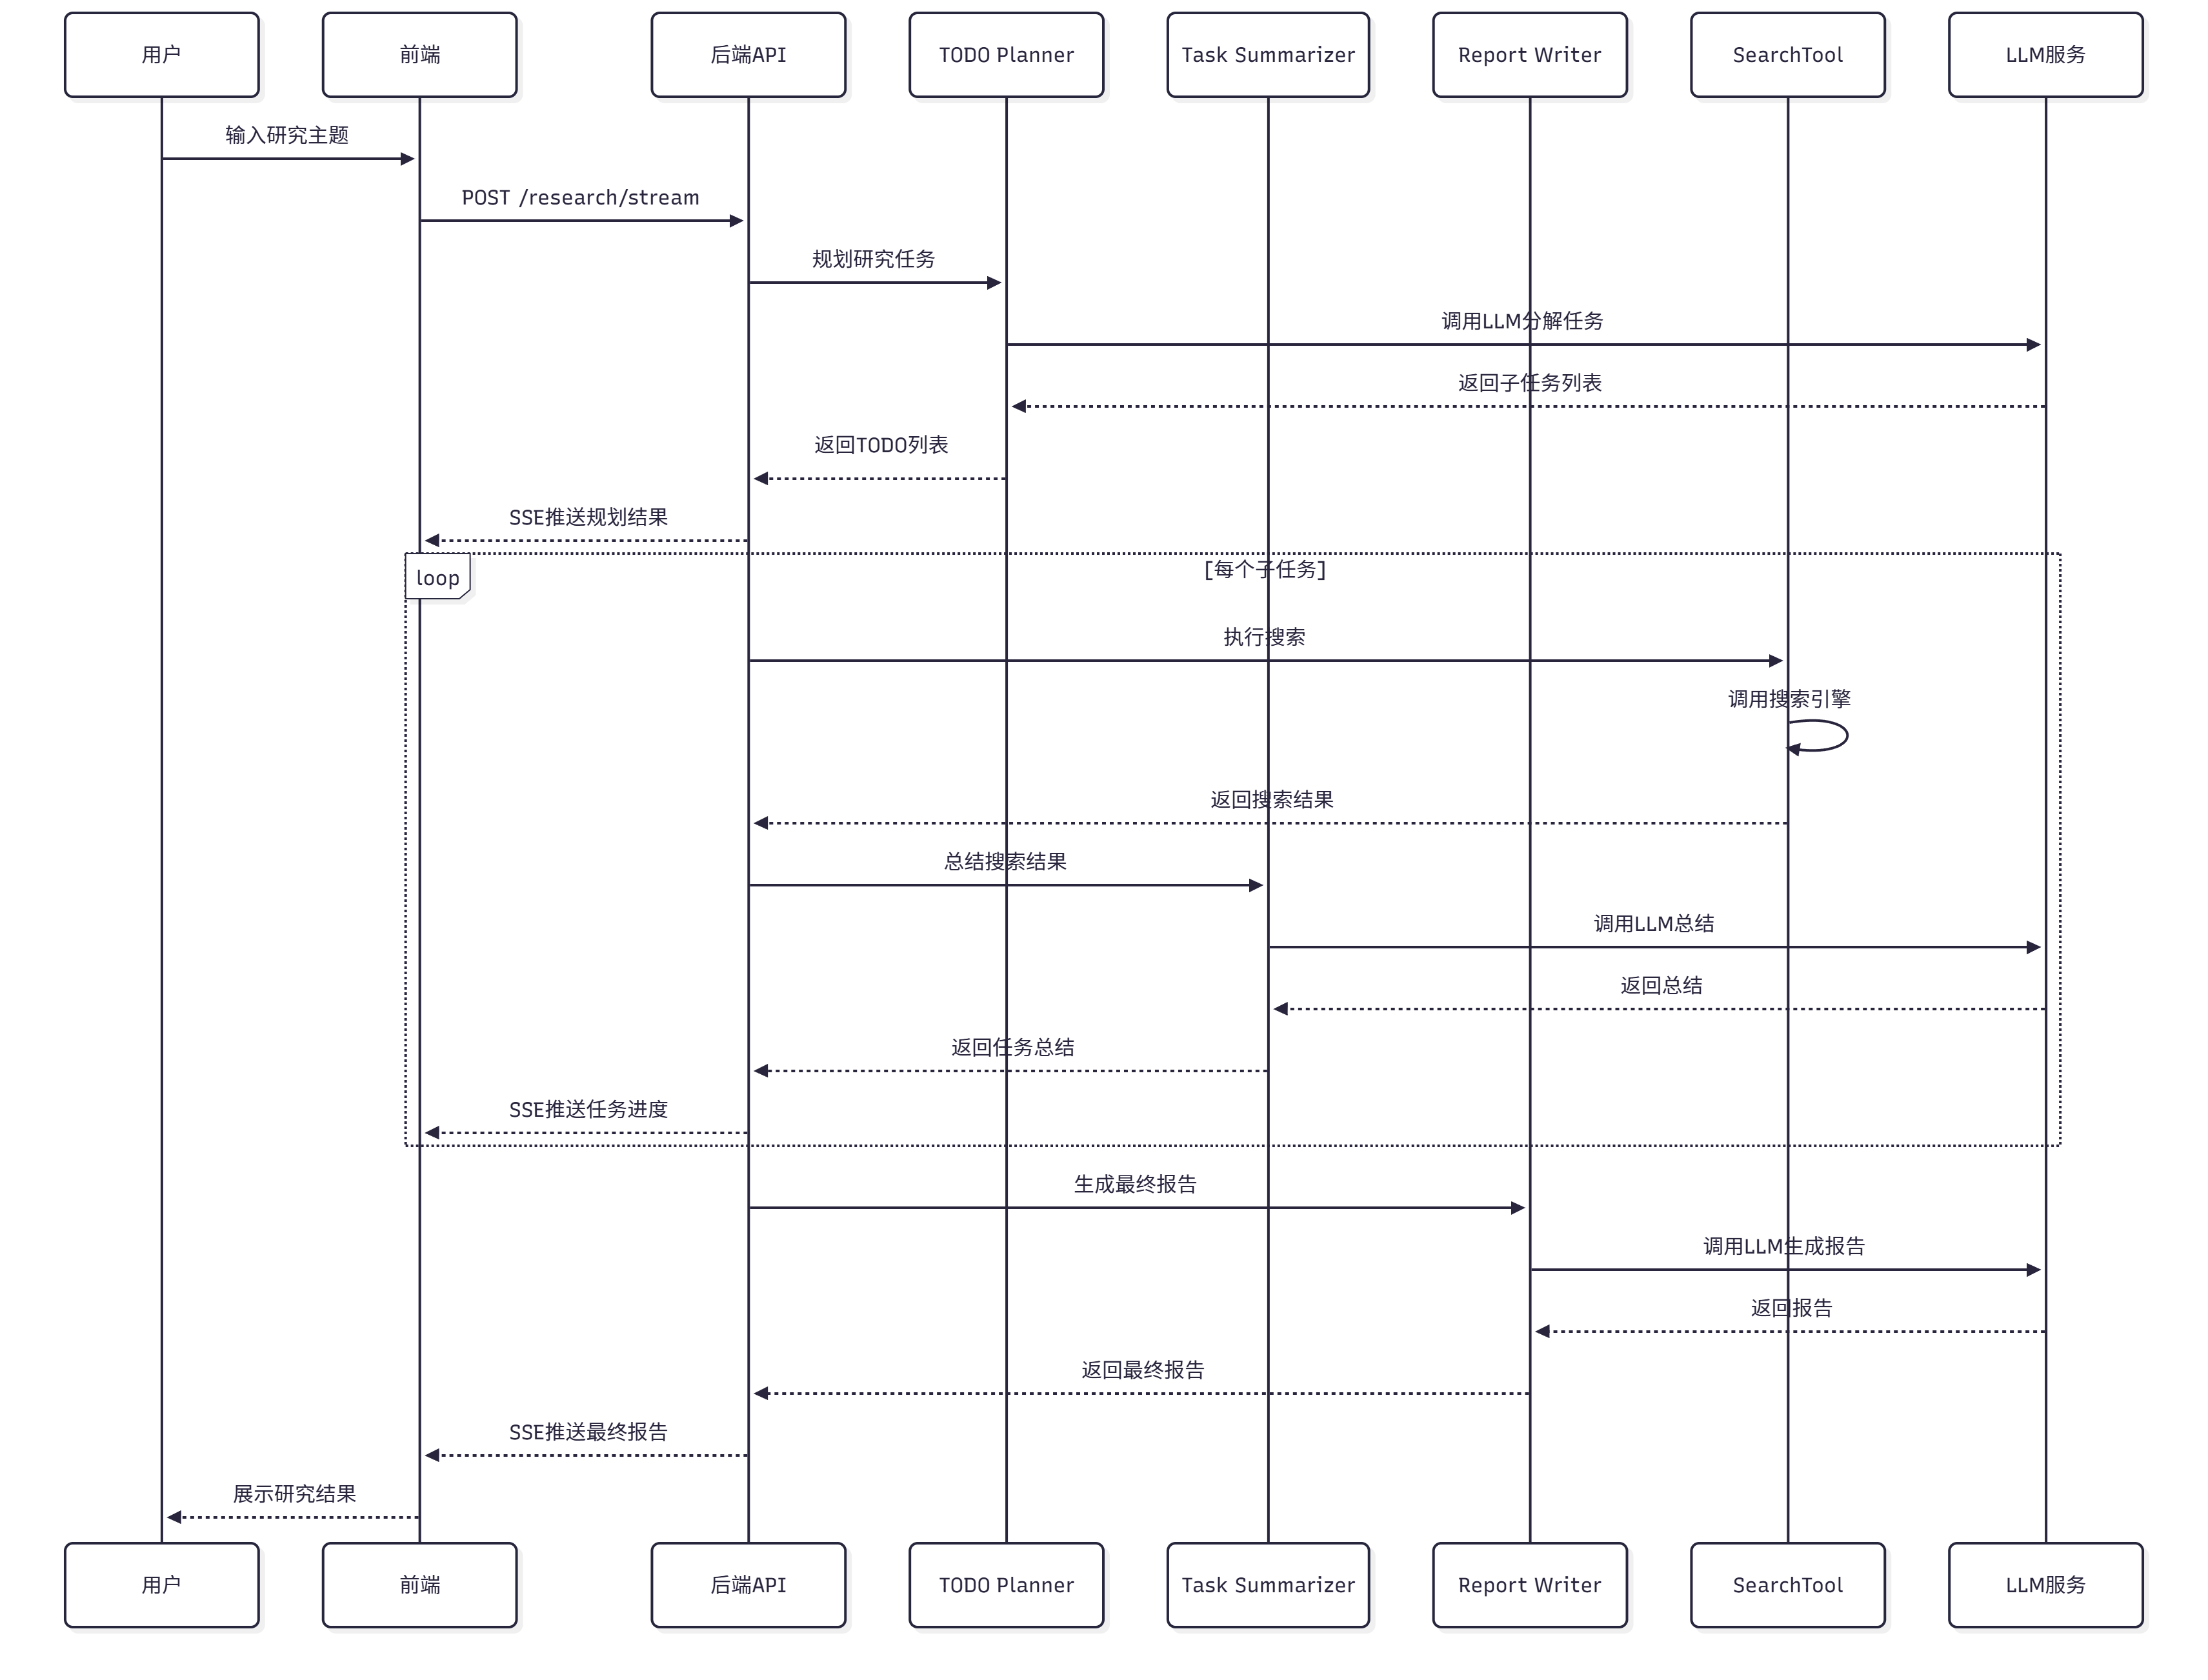
图 14.2 深度研究助手数据流转过程
- 用户输入:用户在前端输入研究主题
- 前端发送:前端通过 SSE 连接到
/research/stream - 后端接收:FastAPI 接收请求,创建研究状态
- 规划阶段:调用研究规划 Agent,分解为 3 个子任务
- 执行阶段:逐个执行每个子任务
- 使用 SearchTool 搜索
- 调用任务总结 Agent 总结
- 使用 NoteTool 记录结果
- 报告阶段:调用报告生成 Agent,整合所有总结
- 流式返回:通过 SSE 推送进度和结果到前端
- 前端展示:前端实时更新任务状态、进度条、日志、报告
项目的目录结构如下:
helloagents-deepresearch/
├── backend/                    # 后端代码
│   ├── src/
│   │   ├── agent.py           # 核心协调器
│   │   ├── main.py            # FastAPI入口
│   │   ├── models.py          # 数据模型
│   │   ├── prompts.py         # Prompt模板
│   │   ├── config.py          # 配置管理
│   │   └── services/          # 服务层
│   │       ├── planner.py     # 规划服务
│   │       ├── summarizer.py  # 总结服务
│   │       ├── reporter.py    # 报告服务
│   │       └── search.py      # 搜索服务
│   ├── .env                   # 环境变量
│   ├── pyproject.toml         # 依赖管理
│   └── workspace/             # 研究笔记
│
└── frontend/                   # 前端代码
    ├── src/
    │   ├── App.vue            # 主组件
    │   ├── components/        # UI组件
    │   │   └── ResearchModal.vue
    │   └── composables/       # 组合式函数
    │       └── useResearch.ts
    ├── package.json           # npm依赖
    └── vite.config.ts         # 构建配置
14.1.3 快速体验:5 分钟运行项目
在深入学习实现细节之前,让我们先把项目跑起来,看看最终的效果。这样你会对整个系统有一个直观的认识。
你可以通过以下命令检查版本:
python --version  # 应该显示 Python 3.10.x 或更高
node --version    # 应该显示 v16.x.x 或更高
npm --version     # 应该显示 8.x.x 或更高
(1)启动后端
# 1. 进入后端目录
cd helloagents-deepresearch/backend

# 2. 安装依赖
# 方式1:使用uv(推荐,更快的Python包管理器)
uv sync

# 方式2:使用pip
pip install -e .

# 3. 配置环境变量
cp .env.example .env

# 4. 编辑.env文件,填入你的API密钥
# 使用你喜欢的编辑器打开.env文件
# 至少需要配置:
# - LLM_PROVIDER(如 openai、deepseek、qwen)
# - LLM_API_KEY(你的LLM API密钥)
# - SEARCH_API(如 duckduckgo、tavily)

# 5. 启动后端
python src/main.py
如果一切正常,你会看到类似的输出:
INFO:     Started server process [12345]
INFO:     Waiting for application startup.
INFO:     Application startup complete.
INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
(2)启动前端
打开一个新的终端窗口:
# 1. 进入前端目录
cd helloagents-deepresearch/frontend

# 2. 安装依赖
npm install

# 3. 启动前端
npm run dev
如果一切正常,你会看到类似的输出:
  VITE v5.0.0  ready in 500 ms

  ➜  Local:   http://localhost:5174/
  ➜  Network: use --host to expose
  ➜  press h + enter to show help
(3)开始研究
打开浏览器访问 http://localhost:5174,你会看到一个居中的输入卡片,如图 14.3 所示。输入研究主题,例如Datawhale是一个什么样的组织?,选择搜索引擎(如果配置了多个),点击"开始研究"按钮。
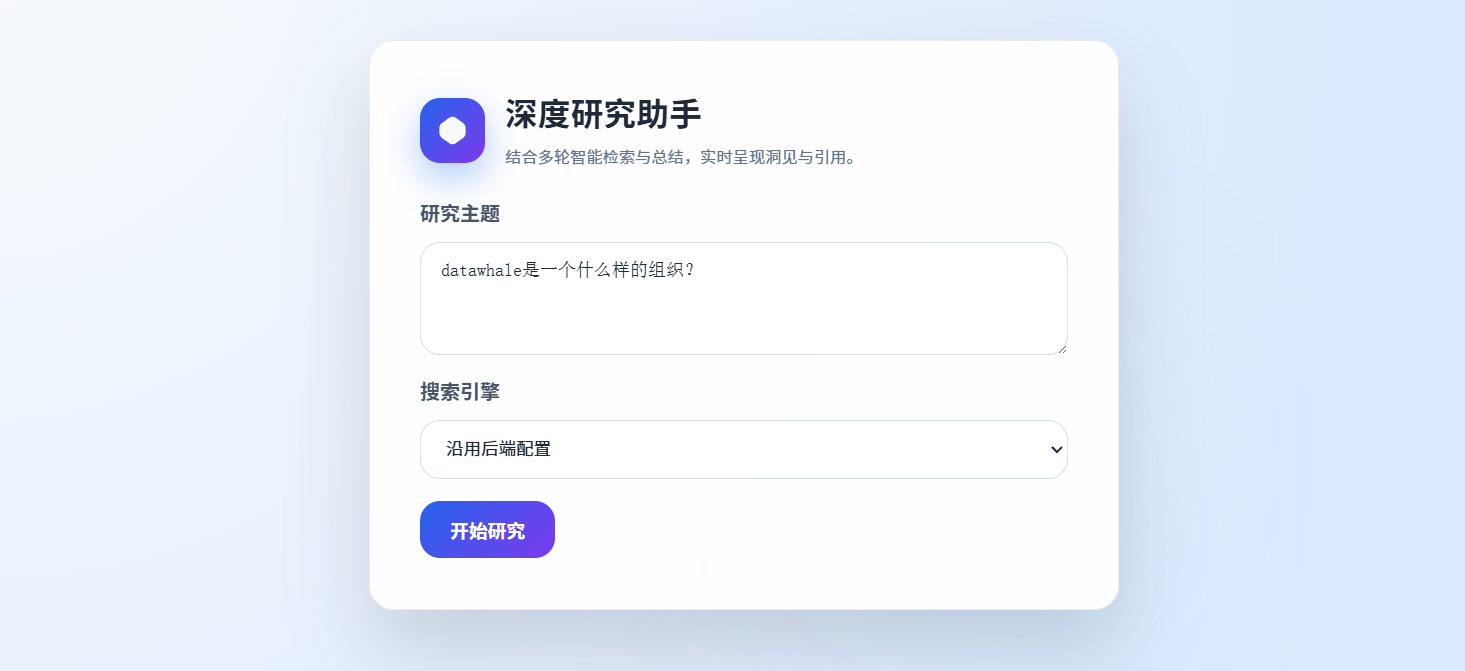
图 14.3 深度研究助手搜索页面
如图 14.4 所示,系统会自动展开为全屏,左侧显示研究信息,右侧实时显示研究进度和结果。整个研究过程大约需要 1-3 分钟,取决于主题的复杂度和搜索引擎的响应速度。
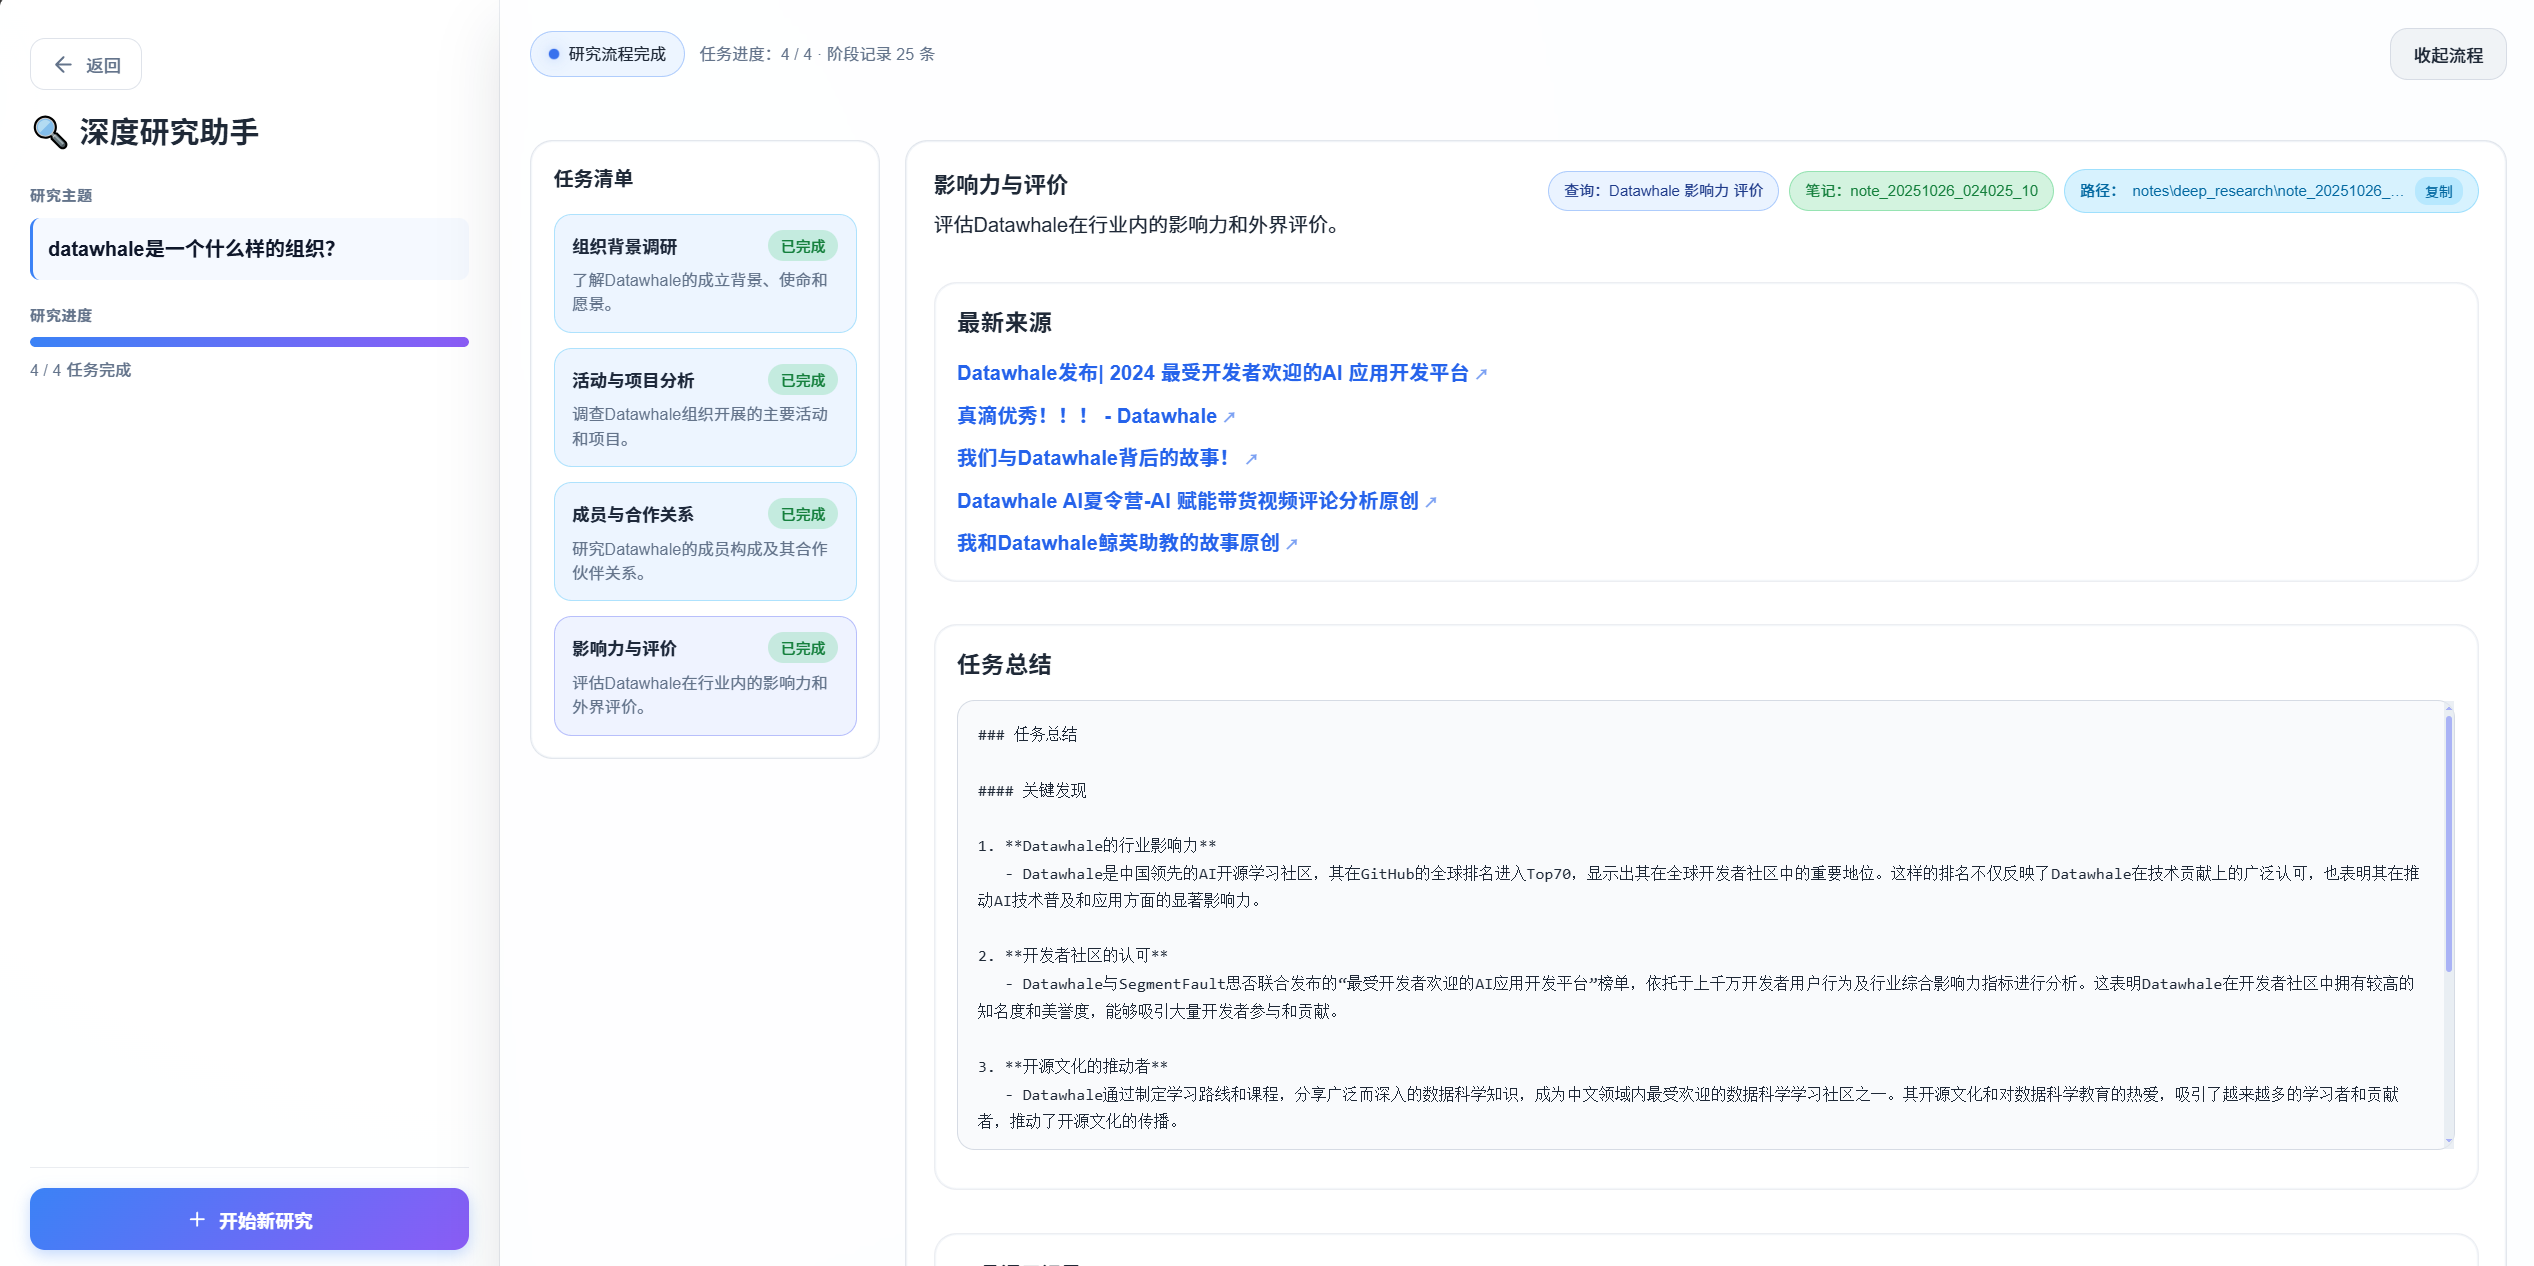
图 14.4 深度研究助手展开研究
研究完成后,你会看到:
- 任务列表:显示所有子任务及其状态
- 进度日志:显示研究过程中的所有操作
- 最终报告:结构化的 Markdown 报告,包含所有子任务的总结和来源引用
现在你已经成功运行了深度研究助手,对系统有了直观的认识。