3.1.1 从 N-gram 到 RNN
语言模型 (Language Model, LM) 是自然语言处理的核心,其根本任务是计算一个词序列(即一个句子)出现的概率。一个好的语言模型能够告诉我们什么样的句子是通顺的、自然的。在多智能体系统中,语言模型是智能体理解人类指令、生成回应的基础。本节将回顾从经典的统计方法到现代深度学习模型的演进历程,为理解后续的 Transformer 架构打下坚实的基础。
(1)统计语言模型与N-gram的思想
在深度学习兴起之前,统计方法是语言模型的主流。其核心思想是,一个句子出现的概率,等于该句子中每个词出现的条件概率的连乘。对于一个由词 构成的句子 S,其概率 P(S) 可以表示为:
这个公式被称为概率的链式法则。然而,直接计算这个公式几乎是不可能的,因为像 这样的条件概率太难从语料库中估计了,词序列 可能从未在训练数据中出现过。
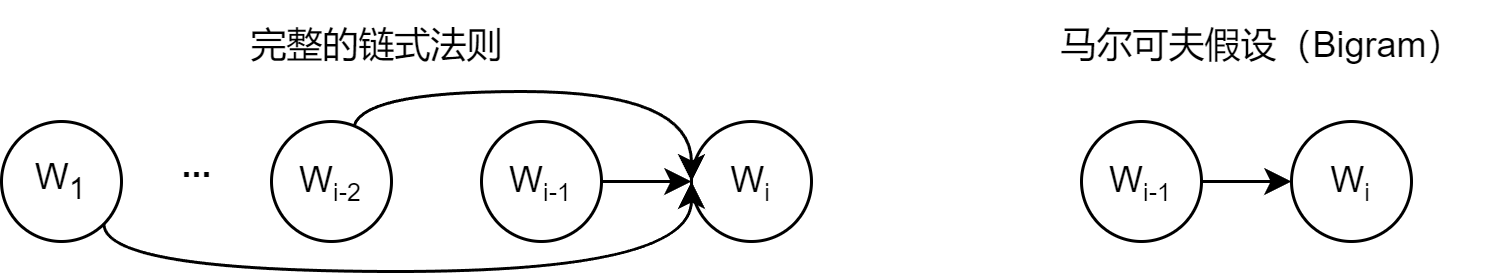
图 3.1 马尔可夫假设示意图
为了解决这个问题,研究者引入了马尔可夫假设 (Markov Assumption) 。其核心思想是:我们不必回溯一个词的全部历史,可以近似地认为,一个词的出现概率只与它前面有限的 个词有关,如图3.1所示。基于这个假设建立的语言模型,我们称之为 N-gram模型。这里的 "N" 代表我们考虑的上下文窗口大小。让我们来看几个最常见的例子来理解这个概念:
- Bigram (当 N=2 时) :这是最简单的情况,我们假设一个词的出现只与它前面的一个词有关。因此,链式法则中复杂的条件概率 就可以被近似为更容易计算的形式:
- Trigram (当 N=3 时) :类似地,我们假设一个词的出现只与它前面的两个词有关:
这些概率可以通过在大型语料库中进行最大似然估计(Maximum Likelihood Estimation,MLE) 来计算。这个术语听起来很复杂,但其思想非常直观:最可能出现的,就是我们在数据中看到次数最多的。例如,对于 Bigram 模型,我们想计算在词 出现后,下一个词是 的概率 。根据最大似然估计,这个概率可以通过简单的计数来估算:
这里的 Count() 函数就代表“计数”:
- :表示词对 在语料库中连续出现的总次数。
- :表示单个词 在语料库中出现的总次数。
公式的含义就是:我们用“词对 出现的次数”除以“词 出现的总次数”,来作为 的一个近似估计。
为了让这个过程更具体,我们来手动进行一次计算。假设我们拥有一个仅包含以下两句话的迷你语料库:datawhale agent learns, datawhale agent works。我们的目标是:使用 Bigram (N=2) 模型,估算句子 datawhale agent learns 出现的概率。根据 Bigram 的假设,我们每次会考察连续的两个词(即一个词对)。
第一步:计算第一个词的概率 这是 datawhale 出现的次数除以总词数。datawhale 出现了 2 次,总词数是 6。
第二步:计算条件概率 这是词对 datawhale agent 出现的次数除以 datawhale 出现的总次数。datawhale agent 出现了 2 次,datawhale 出现了 2 次。
第三步:计算条件概率 这是词对 agent learns 出现的次数除以 agent 出现的总次数。agent learns 出现了 1 次,agent 出现了 2 次。
最后:将概率连乘 所以,整个句子的近似概率为:
import collections

# 示例语料库,与上方案例讲解中的语料库保持一致
corpus = "datawhale agent learns datawhale agent works"
tokens = corpus.split()
total_tokens = len(tokens)

# --- 第一步:计算 P(datawhale) ---
count_datawhale = tokens.count('datawhale')
p_datawhale = count_datawhale / total_tokens
print(f"第一步: P(datawhale) = {count_datawhale}/{total_tokens} = {p_datawhale:.3f}")

# --- 第二步:计算 P(agent|datawhale) ---
# 先计算 bigrams 用于后续步骤
bigrams = zip(tokens, tokens[1:])
bigram_counts = collections.Counter(bigrams)
count_datawhale_agent = bigram_counts[('datawhale', 'agent')]
# count_datawhale 已在第一步计算
p_agent_given_datawhale = count_datawhale_agent / count_datawhale
print(f"第二步: P(agent|datawhale) = {count_datawhale_agent}/{count_datawhale} = {p_agent_given_datawhale:.3f}")

# --- 第三步:计算 P(learns|agent) ---
count_agent_learns = bigram_counts[('agent', 'learns')]
count_agent = tokens.count('agent')
p_learns_given_agent = count_agent_learns / count_agent
print(f"第三步: P(learns|agent) = {count_agent_learns}/{count_agent} = {p_learns_given_agent:.3f}")

# --- 最后:将概率连乘 ---
p_sentence = p_datawhale * p_agent_given_datawhale * p_learns_given_agent
print(f"最后: P('datawhale agent learns') ≈ {p_datawhale:.3f} * {p_agent_given_datawhale:.3f} * {p_learns_given_agent:.3f} = {p_sentence:.3f}")

>>>
第一步: P(datawhale) = 2/6 = 0.333
第二步: P(agent|datawhale) = 2/2 = 1.000
第三步: P(learns|agent) = 1/2 = 0.500
最后: P('datawhale agent learns') ≈ 0.333 * 1.000 * 0.500 = 0.167
N-gram 模型虽然简单有效,但有两个致命缺陷:
- 数据稀疏性 (Sparsity) :如果一个词序列从未在语料库中出现,其概率估计就为 0,这显然是不合理的。虽然可以通过平滑 (Smoothing) 技术缓解,但无法根除。
- 泛化能力差:模型无法理解词与词之间的语义相似性。例如,即使模型在语料库中见过很多次
agent learns,它也无法将这个知识泛化到语义相似的词上。当我们计算robot learns的概率时,如果robot这个词从未出现过,或者robot learns这个组合从未出现过,模型计算出的概率也会是零。模型无法理解agent和robot在语义上的相似性。
(2)神经网络语言模型与词嵌入
N-gram 模型的根本缺陷在于它将词视为孤立、离散的符号。为了克服这个问题,研究者们转向了神经网络,并提出了一种思想:用连续的向量来表示词。2003年,Bengio 等人提出的前馈神经网络语言模型 (Feedforward Neural Network Language Model) 是这一领域的里程碑[1]。
其核心思想可以分为两步:
- 构建一个语义空间:创建一个高维的连续向量空间,然后将词汇表中的每个词都映射为该空间中的一个点。这个点(即向量)就被称为词嵌入 (Word Embedding) 或词向量。在这个空间里,语义上相近的词,它们对应的向量在空间中的位置也相近。例如,
agent和robot的向量会靠得很近,而agent和apple的向量会离得很远。 - 学习从上下文到下一个词的映射:利用神经网络的强大拟合能力,来学习一个函数。这个函数的输入是前 个词的词向量,输出是词汇表中每个词在当前上下文后出现的概率分布。
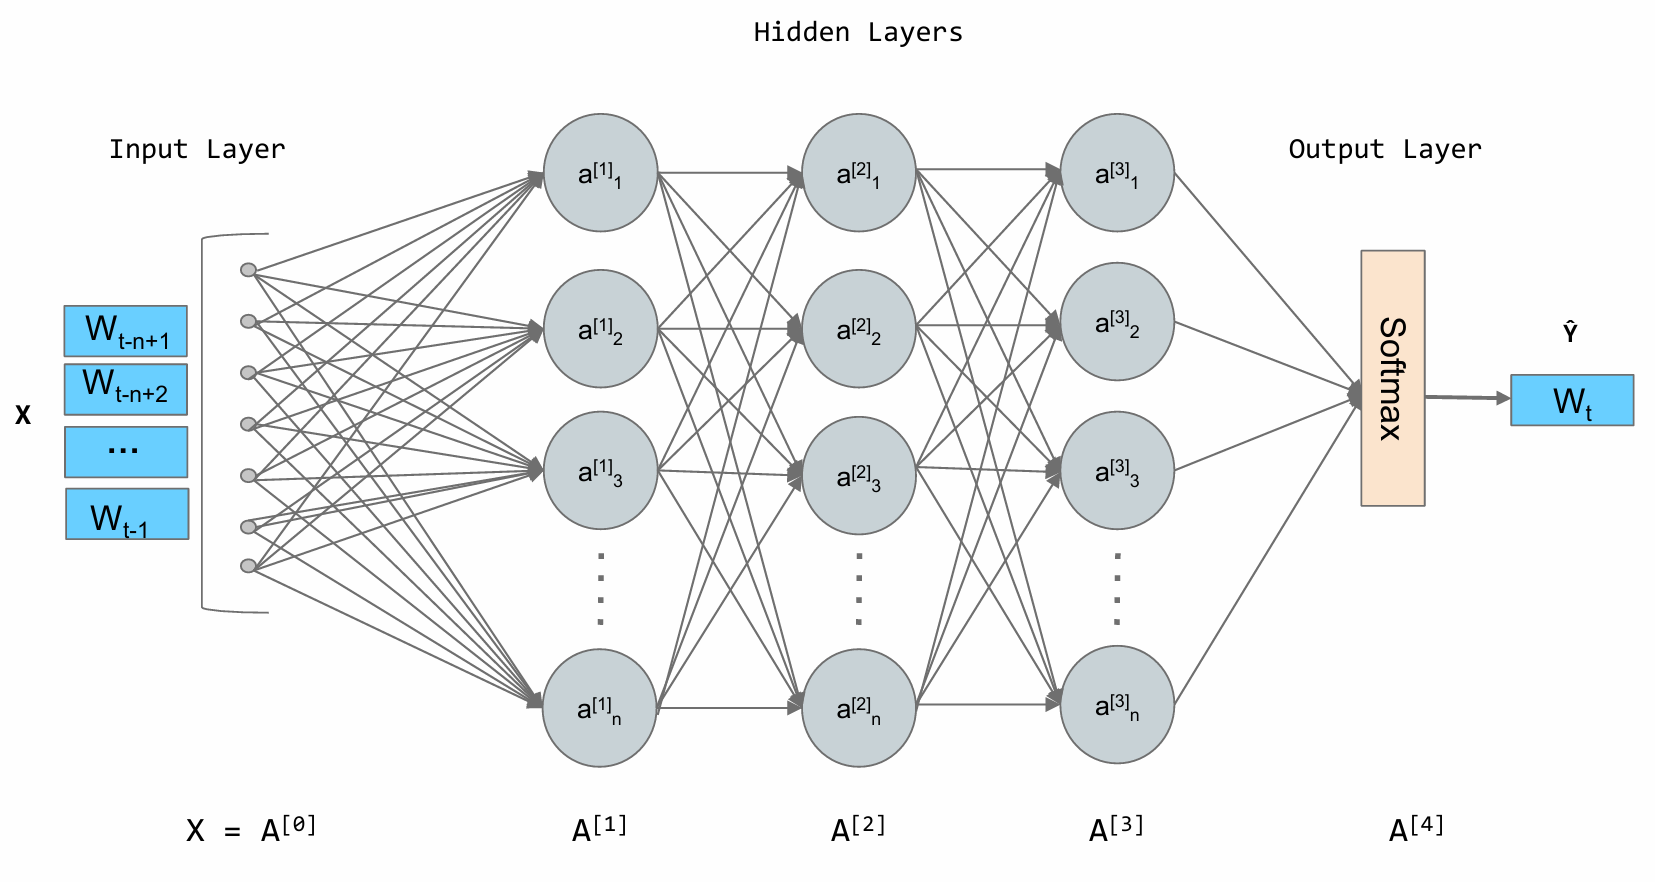
图 3.2 神经网络语言模型架构示意图
如图3.2所示,在这个架构中,词嵌入是在模型训练过程中自动学习得到的。模型为了完成“预测下一个词”这个任务,会不断调整每个词的向量位置,最终使这些向量能够蕴含丰富的语义信息。一旦我们将词转换成了向量,我们就可以用数学工具来度量它们之间的关系。最常用的方法是余弦相似度 (Cosine Similarity) ,它通过计算两个向量夹角的余弦值来衡量它们的相似性。
这个公式的含义是:
- 如果两个向量方向完全相同,夹角为0°,余弦值为1,表示完全相关。
- 如果两个向量方向正交,夹角为90°,余弦值为0,表示毫无关系。
- 如果两个向量方向完全相反,夹角为180°,余弦值为-1,表示完全负相关。
通过这种方式,词向量不仅能捕捉到“同义词”这类简单的关系,还能捕捉到更复杂的类比关系。
一个著名的例子展示了词向量捕捉到的语义关系: vector('King') - vector('Man') + vector('Woman') 这个向量运算的结果,在向量空间中与 vector('Queen') 的位置惊人地接近。这好比在进行语义的平移:我们从“国王”这个点出发,减去“男性”的向量,再加上“女性”的向量,最终就抵达了“女王”的位置。这证明了词嵌入能够学习到“性别”、“皇室”这类抽象概念。
import numpy as np

# 假设我们已经学习到了简化的二维词向量
embeddings = {
    "king": np.array([0.9, 0.8]),
    "queen": np.array([0.9, 0.2]),
    "man": np.array([0.7, 0.9]),
    "woman": np.array([0.7, 0.3])
}

def cosine_similarity(vec1, vec2):
    dot_product = np.dot(vec1, vec2)
    norm_product = np.linalg.norm(vec1) * np.linalg.norm(vec2)
    return dot_product / norm_product

# king - man + woman
result_vec = embeddings["king"] - embeddings["man"] + embeddings["woman"]

# 计算结果向量与 "queen" 的相似度
sim = cosine_similarity(result_vec, embeddings["queen"])

print(f"king - man + woman 的结果向量: {result_vec}")
print(f"该结果与 'queen' 的相似度: {sim:.4f}")

>>>
king - man + woman 的结果向量: [0.9 0.2]
该结果与 'queen' 的相似度: 1.0000
神经网络语言模型通过词嵌入,成功解决了 N-gram 模型的泛化能力差的问题。然而,它仍然有一个类似 N-gram 的限制:上下文窗口是固定的。它只能考虑固定数量的前文,这为能处理任意长序列的循环神经网络埋下了伏笔。
(3)循环神经网络 (RNN) 与长短时记忆网络 (LSTM)
前一节的神经网络语言模型虽然引入了词嵌入解决了泛化问题,但它和 N-gram 模型一样,上下文窗口是固定大小的。为了预测下一个词,它只能看到前 n−1 个词,再早的历史信息就被丢弃了。这显然不符合我们人类理解语言的方式。为了打破固定窗口的限制,循环神经网络 (Recurrent Neural Network, RNN) 应运而生,其核心思想非常直观:为网络增加“记忆”能力[2]。
如图3.3所示,RNN 的设计引入了一个隐藏状态 (hidden state) 向量,我们可以将其理解为网络的短期记忆。在处理序列的每一步,网络都会读取当前的输入词,并结合它上一刻的记忆(即上一个时间步的隐藏状态),然后生成一个新的记忆(即当前时间步的隐藏状态)传递给下一刻。这个循环往复的过程,使得信息可以在序列中不断向后传递。
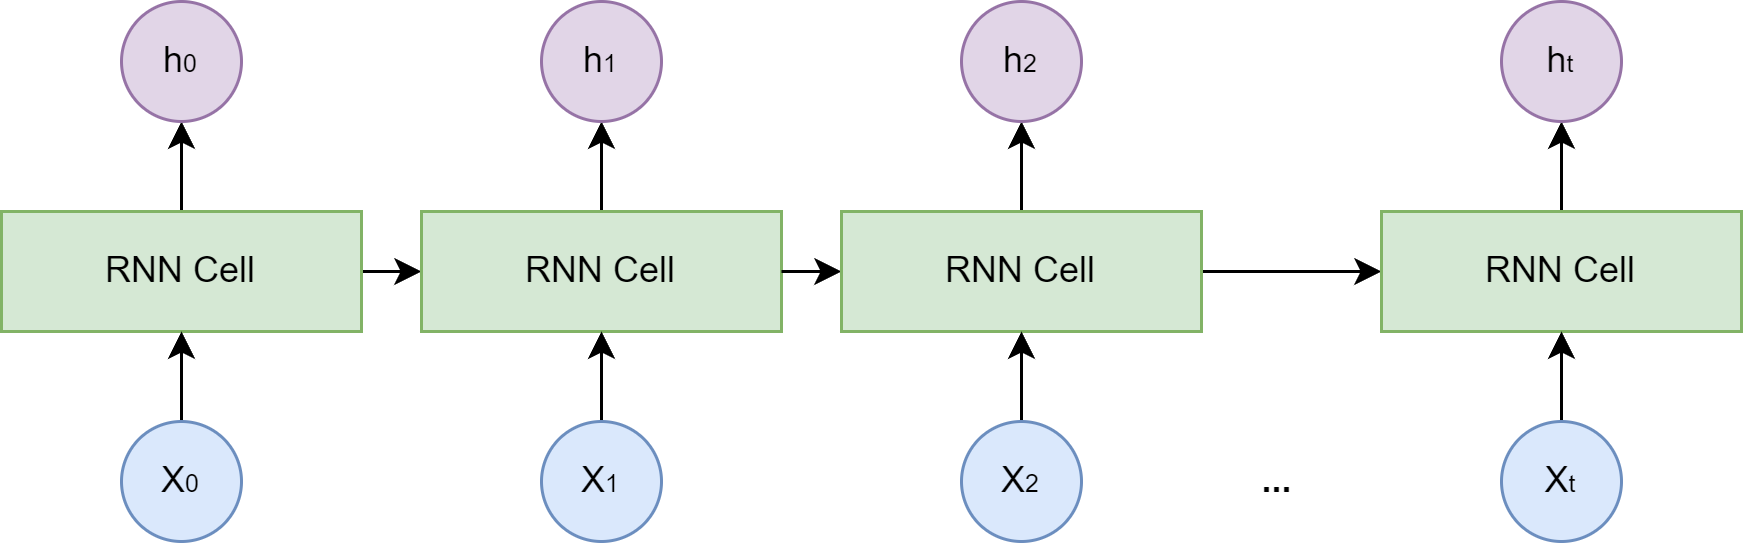
图 3.3 RNN 结构示意图
然而,标准的 RNN 在实践中存在一个严重的问题:长期依赖问题 (Long-term Dependency Problem) 。在训练过程中,模型需要通过反向传播算法根据输出端的误差来调整网络深处的权重。对于 RNN 而言,序列的长度就是网络的深度。当序列很长时,梯度在从后向前传播的过程中会经过多次连乘,这会导致梯度值快速趋向于零(梯度消失)或变得极大(梯度爆炸)。梯度消失使得模型无法有效学习到序列早期信息对后期输出的影响,即难以捕捉长距离的依赖关系。
为了解决长期依赖问题,长短时记忆网络 (Long Short-Term Memory, LSTM) 被设计出来[3]。LSTM 是一种特殊的 RNN,其核心创新在于引入了细胞状态 (Cell State) 和一套精密的门控机制 (Gating Mechanism) 。细胞状态可以看作是一条独立于隐藏状态的信息通路,允许信息在时间步之间更顺畅地传递。门控机制则是由几个小型神经网络构成,它们可以学习如何有选择地让信息通过,从而控制细胞状态中信息的增加与移除。这些门包括:
- 遗忘门 (Forget Gate):决定从上一时刻的细胞状态中丢弃哪些信息。
- 输入门 (Input Gate):决定将当前输入中的哪些新信息存入细胞状态。
- 输出门 (Output Gate):决定根据当前的细胞状态,输出哪些信息到隐藏状态。
3.1.2 Transformer 架构解析
在上一节中,我们看到RNN及LSTM通过引入循环结构来处理序列数据,这在一定程度上解决了捕捉长距离依赖的问题。然而,这种循环的计算方式也带来了新的瓶颈:它必须按顺序处理数据。第 t 个时间步的计算,必须等待第 t−1 个时间步完成后才能开始。这意味着 RNN 无法进行大规模的并行计算,在处理长序列时效率低下,这极大地限制了模型规模和训练速度的提升。Transformer在2017 年由谷歌团队提出[4]。它完全抛弃了循环结构,转而完全依赖一种名为注意力 (Attention) 的机制来捕捉序列内的依赖关系,从而实现了真正意义上的并行计算。
(1)Encoder-Decoder 整体结构
最初的 Transformer 模型是为端到端任务机器翻译而设计的。如图3.4所示,它在宏观上遵循了一个经典的编码器-解码器 (Encoder-Decoder) 架构。
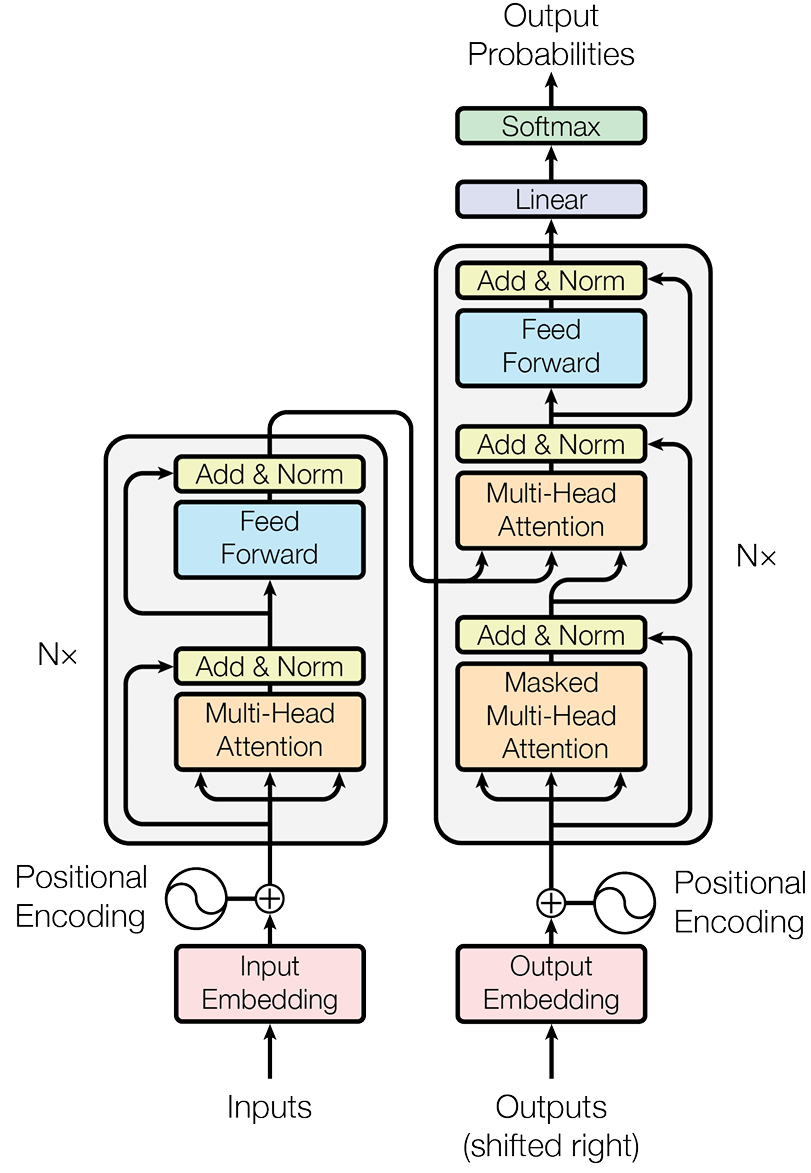
图 3.4 Transformer 整体架构图
我们可以将这个结构理解为一个分工明确的团队:
- 编码器 (Encoder) :任务是“理解”输入的整个句子。它会读取所有输入词元(这个概念会在3.2.2节介绍),最终为每个词元生成一个富含上下文信息的向量表示。
- 解码器 (Decoder) :任务是“生成”目标句子。它会参考自己已经生成的前文,并“咨询”编码器的理解结果,来生成下一个词。
为了真正理解 Transformer 的工作原理,最好的方法莫过于亲手实现它。在本节中,我们将采用一种“自顶向下”的方法:首先,我们搭建出 Transformer 完整的代码框架,定义好所有需要的类和方法。然后,我们将像完成拼图一样,逐一实现这些类的具体功能。
import torch
import torch.nn as nn
import math

# --- 占位符模块,将在后续小节中实现 ---

class PositionalEncoding(nn.Module):
    """
    位置编码模块
    """
    def forward(self, x):
        pass

class MultiHeadAttention(nn.Module):
    """
    多头注意力机制模块
    """
    def forward(self, query, key, value, mask):
        pass

class PositionWiseFeedForward(nn.Module):
    """
    位置前馈网络模块
    """
    def forward(self, x):
        pass

# --- 编码器核心层 ---

class EncoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ff, dropout):
        super(EncoderLayer, self).__init__()
        self.self_attn = MultiHeadAttention() # 待实现
        self.feed_forward = PositionWiseFeedForward() # 待实现
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, mask):
        # 残差连接与层归一化将在 3.1.2.4 节中详细解释
        # 1. 多头自注意力
        attn_output = self.self_attn(x, x, x, mask)
        x = self.norm1(x + self.dropout(attn_output))

        # 2. 前馈网络
        ff_output = self.feed_forward(x)
        x = self.norm2(x + self.dropout(ff_output))

        return x

# --- 解码器核心层 ---

class DecoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ff, dropout):
        super(DecoderLayer, self).__init__()
        self.self_attn = MultiHeadAttention() # 待实现
        self.cross_attn = MultiHeadAttention() # 待实现
        self.feed_forward = PositionWiseFeedForward() # 待实现
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.norm3 = nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, encoder_output, src_mask, tgt_mask):
        # 1. 掩码多头自注意力 (对自己)
        attn_output = self.self_attn(x, x, x, tgt_mask)
        x = self.norm1(x + self.dropout(attn_output))

        # 2. 交叉注意力 (对编码器输出)
        cross_attn_output = self.cross_attn(x, encoder_output, encoder_output, src_mask)
        x = self.norm2(x + self.dropout(cross_attn_output))

        # 3. 前馈网络
        ff_output = self.feed_forward(x)
        x = self.norm3(x + self.dropout(ff_output))

        return x
(2)从自注意力到多头注意力
现在,我们来填充骨架中最关键的模块,注意力机制。
想象一下我们阅读这个句子:“The agent learns because it is intelligent.”。当我们读到加粗的 "it" 时,为了理解它的指代,我们的大脑会不自觉地将更多的注意力放在前面的 "agent" 这个词上。自注意力 (Self-Attention) 机制就是对这种现象的数学建模。它允许模型在处理序列中的每一个词时,都能兼顾句子中的所有其他词,并为这些词分配不同的“注意力权重”。权重越高的词,代表其与当前词的关联性越强,其信息也应该在当前词的表示中占据更大的比重。
为了实现上述过程,自注意力机制为每个输入的词元向量引入了三个可学习的角色:
- 查询 (Query, Q):代表当前词元,它正在主动地“查询”其他词元以获取信息。
- 键 (Key, K):代表句子中可被查询的词元“标签”或“索引”。
- 值 (Value, V):代表词元本身所携带的“内容”或“信息”。
这三个向量都是由原始的词嵌入向量乘以三个不同的、可学习的权重矩阵 () 得到的。整个计算过程可以分为以下几步,我们可以把它想象成一次高效的开卷考试:
- 准备“考题”和“资料”:对于句子中的每个词,都通过权重矩阵生成其向量。
- 计算相关性得分:要计算词的新表示,就用词的向量,去和句子中所有词(包括自己)的向量进行点积运算。这个得分反映了其他词对于理解词的重要性。
- 稳定化与归一化:将得到的所有分数除以一个缩放因子(是向量的维度),以防止梯度过小,然后用Softmax函数将分数转换成总和为1的权重,也就是归一化的过程。
- 加权求和:将上一步得到的权重分别乘以每个词对应的向量,然后将所有结果相加。最终得到的向量,就是词融合了全局上下文信息后的新表示。
这个过程可以用一个简洁的公式来概括:
如果只进行一次上述的注意力计算(即单头),模型可能会只学会关注一种类型的关联。比如,在处理 "it" 时,可能只学会了关注主语。但语言中的关系是复杂的,我们希望模型能同时关注多种关系(如指代关系、时态关系、从属关系等)。多头注意力机制应运而生。它的思想很简单:把一次做完变成分成几组,分开做,再合并。
它将原始的 Q, K, V 向量在维度上切分成 h 份(h 就是“头”数),每一份都独立地进行一次单头注意力的计算。这就好比让 h 个不同的“专家”从不同的角度去审视句子,每个专家都能捕捉到一种不同的特征关系。最后,将这 h 个专家的“意见”(即输出向量)拼接起来,再通过一个线性变换进行整合,就得到了最终的输出。
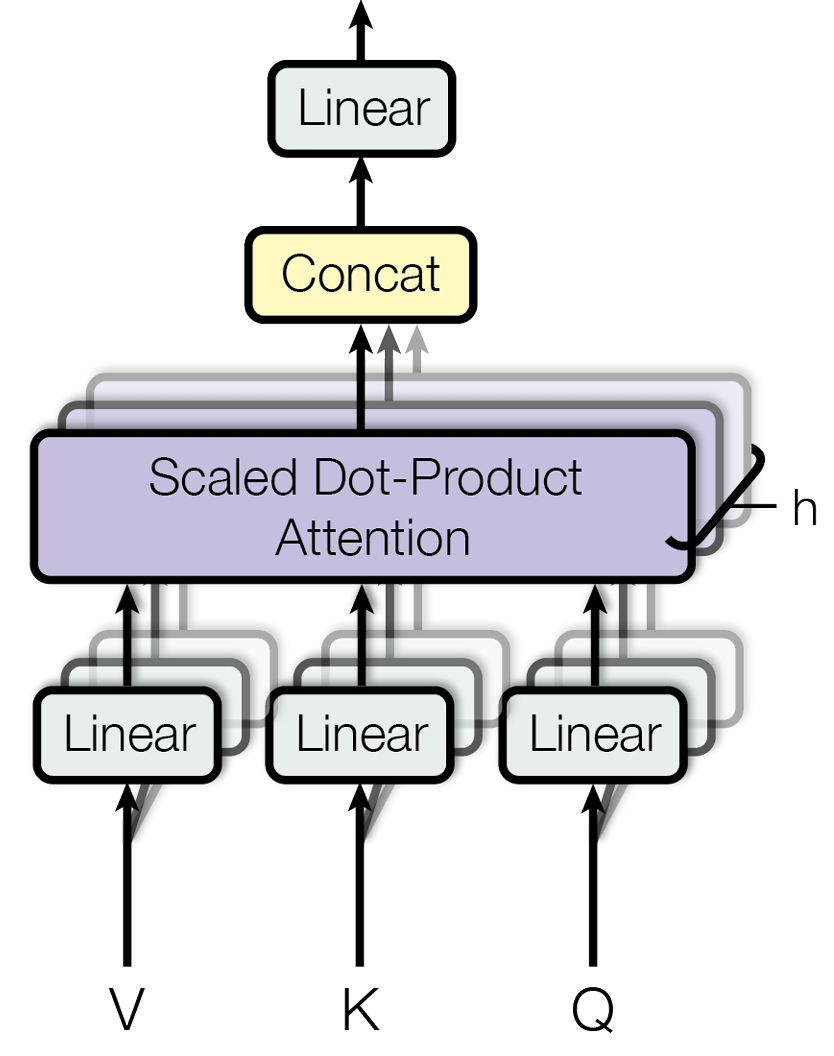
图 3.5 多头注意力机制
如图3.5所示,这种设计让模型能够共同关注来自不同位置、不同表示子空间的信息,极大地增强了模型的表达能力。以下是多头注意力的简单实现可供参考。
class MultiHeadAttention(nn.Module):
    """
    多头注意力机制模块
    """
    def __init__(self, d_model, num_heads):
        super(MultiHeadAttention, self).__init__()
        assert d_model % num_heads == 0, "d_model 必须能被 num_heads 整除"

        self.d_model = d_model
        self.num_heads = num_heads
        self.d_k = d_model // num_heads

        # 定义 Q, K, V 和输出的线性变换层
        self.W_q = nn.Linear(d_model, d_model)
        self.W_k = nn.Linear(d_model, d_model)
        self.W_v = nn.Linear(d_model, d_model)
        self.W_o = nn.Linear(d_model, d_model)

    def scaled_dot_product_attention(self, Q, K, V, mask=None):
        # 1. 计算注意力得分 (QK^T)
        attn_scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)

        # 2. 应用掩码 (如果提供)
        if mask is not None:
            # 将掩码中为 0 的位置设置为一个非常小的负数,这样 softmax 后会接近 0
            attn_scores = attn_scores.masked_fill(mask == 0, -1e9)

        # 3. 计算注意力权重 (Softmax)
        attn_probs = torch.softmax(attn_scores, dim=-1)

        # 4. 加权求和 (权重 * V)
        output = torch.matmul(attn_probs, V)
        return output

    def split_heads(self, x):
        # 将输入 x 的形状从 (batch_size, seq_length, d_model)
        # 变换为 (batch_size, num_heads, seq_length, d_k)
        batch_size, seq_length, d_model = x.size()
        return x.view(batch_size, seq_length, self.num_heads, self.d_k).transpose(1, 2)

    def combine_heads(self, x):
        # 将输入 x 的形状从 (batch_size, num_heads, seq_length, d_k)
        # 变回 (batch_size, seq_length, d_model)
        batch_size, num_heads, seq_length, d_k = x.size()
        return x.transpose(1, 2).contiguous().view(batch_size, seq_length, self.d_model)

    def forward(self, Q, K, V, mask=None):
        # 1. 对 Q, K, V 进行线性变换
        Q = self.split_heads(self.W_q(Q))
        K = self.split_heads(self.W_k(K))
        V = self.split_heads(self.W_v(V))

        # 2. 计算缩放点积注意力
        attn_output = self.scaled_dot_product_attention(Q, K, V, mask)

        # 3. 合并多头输出并进行最终的线性变换
        output = self.W_o(self.combine_heads(attn_output))
        return output
(3)前馈神经网络
在每个 Encoder 和 Decoder 层中,多头注意力子层之后都跟着一个逐位置前馈网络(Position-wise Feed-Forward Network, FFN) 。如果说注意力层的作用是从整个序列中“动态地聚合”相关信息,那么前馈网络的作用从这些聚合后的信息中提取更高阶的特征。
这个名字的关键在于“逐位置”。它意味着这个前馈网络会独立地作用于序列中的每一个词元向量。换句话说,对于一个长度为 seq_len 的序列,这个 FFN 实际上会被调用 seq_len 次,每次处理一个词元。重要的是,所有位置共享的是同一组网络权重。这种设计既保持了对每个位置进行独立加工的能力,又大大减少了模型的参数量。这个网络的结构非常简单,由两个线性变换和一个 ReLU 激活函数组成:
其中,是注意力子层的输出。 是可学习的参数。通常,第一个线性层的输出维度 d_ff 会远大于输入的维度 d_model(例如 d_ff = 4 * d_model),经过 ReLU 激活后再通过第二个线性层映射回 d_model 维度。这种“先扩大再缩小”的模式,被认为有助于模型学习更丰富的特征表示。
在我们的 PyTorch 骨架中,我们可以用以下代码来实现这个模块:
class PositionWiseFeedForward(nn.Module):
    """
    位置前馈网络模块
    """
    def __init__(self, d_model, d_ff, dropout=0.1):
        super(PositionWiseFeedForward, self).__init__()
        self.linear1 = nn.Linear(d_model, d_ff)
        self.dropout = nn.Dropout(dropout)
        self.linear2 = nn.Linear(d_ff, d_model)
        self.relu = nn.ReLU()

    def forward(self, x):
        # x 形状: (batch_size, seq_len, d_model)
        x = self.linear1(x)
        x = self.relu(x)
        x = self.dropout(x)
        x = self.linear2(x)
        # 最终输出形状: (batch_size, seq_len, d_model)
        return x
(4)残差连接与层归一化
在 Transformer 的每个编码器和解码器层中,所有子模块(如多头注意力和前馈网络)都被一个 Add & Norm 操作包裹。这个组合是为了保证 Transformer 能够稳定训练。
这个操作由两个部分组成:
- 残差连接 (Add):该操作将子模块的输入
x直接加到该子模块的输出Sublayer(x)上。这一结构解决了深度神经网络中的梯度消失 (Vanishing Gradients) 问题。在反向传播时,梯度可以绕过子模块直接向前传播,从而保证了即使网络层数很深,模型也能得到有效的训练。其公式可以表示为:。 - 层归一化 (Norm):该操作对单个样本的所有特征进行归一化,使其均值为0,方差为1。这解决了模型训练过程中的内部协变量偏移 (Internal Covariate Shift) 问题,使每一层的输入分布保持稳定,从而加速模型收敛并提高训练的稳定性。
3.1.2.5 位置编码
我们已经了解,Transformer 的核心是自注意力机制,它通过计算序列中任意两个词元之间的关系来捕捉依赖。然而,这种计算方式有一个固有的问题:它本身不包含任何关于词元顺序或位置的信息。对于自注意力来说,“agent learns” 和 “learns agent” 这两个序列是完全等价的,因为它只关心词元之间的关系,而忽略了它们的排列。为了解决这个问题,Transformer 引入了位置编码 (Positional Encoding) 。
位置编码的核心思想是,为输入序列中的每一个词元嵌入向量,都额外加上一个能代表其绝对位置和相对位置信息的“位置向量”。这个位置向量不是通过学习得到的,而是通过一个固定的数学公式直接计算得出。这样一来,即使两个词元(例如,两个都叫 agent 的词元)自身的嵌入是相同的,但由于它们在句子中的位置不同,它们最终输入到 Transformer 模型中的向量就会因为加上了不同的位置编码而变得独一无二。原论文中提出的位置编码使用正弦和余弦函数来生成,其公式如下:
其中:
- 是词元在序列中的位置(例如,,,,...)
- 是位置向量中的维度索引(从 到 )
- 是词嵌入向量的维度(与我们模型中定义的一致)
现在,我们来实现 PositionalEncoding 模块,并完成我们 Transformer 骨架代码的最后一部分。
class PositionalEncoding(nn.Module):
    """
    为输入序列的词嵌入向量添加位置编码。
    """
    def __init__(self, d_model: int, dropout: float = 0.1, max_len: int = 5000):
        super().__init__()
        self.dropout = nn.Dropout(p=dropout)

        # 创建一个足够长的位置编码矩阵
        position = torch.arange(max_len).unsqueeze(1)
        div_term = torch.exp(torch.arange(0, d_model, 2) * (-math.log(10000.0) / d_model))

        # pe (positional encoding) 的大小为 (max_len, d_model)
        pe = torch.zeros(max_len, d_model)

        # 偶数维度使用 sin, 奇数维度使用 cos
        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)

        # 将 pe 注册为 buffer,这样它就不会被视为模型参数,但会随模型移动(例如 to(device))
        self.register_buffer('pe', pe.unsqueeze(0))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # x.size(1) 是当前输入的序列长度
        # 将位置编码加到输入向量上
        x = x + self.pe[:, :x.size(1)]
        return self.dropout(x)
本小节主要是为了帮助理解 Transformer 的宏观结构和内部每个模块的运作细节。由于是为了补充智能体学习中大模型的知识体系,也就不再继续往下深入实现。至此,我们已经为理解现代大语言模型打下了坚实的架构基础。在下一节中,我们将探讨 Decoder-Only 架构,看看它是如何基于 Transformer 的思想演变而来。
3.1.3 Decoder-Only 架构
前面一节中,我们动手构建了一个完整的Transformer 模型,它能在很多端到端的场景表现出色。但是当任务转换为构建一个与人对话、创作、作为智能体大脑的通用模型时,或许我们并不需要那么复杂的结构。
Transformer的设计哲学是“先理解,再生成”。编码器负责深入理解输入的整个句子,形成一个包含全局信息的上下文记忆,然后解码器基于这份记忆来生成翻译。但 OpenAI 在开发 GPT (Generative Pre-trained Transformer) 时,提出了一个更简单的思想[5]:语言的核心任务,不就是预测下一个最有可能出现的词吗?
无论是回答问题、写故事还是生成代码,本质上都是在一个已有的文本序列后面,一个词一个词地添加最合理的内容。基于这个思想,GPT 做了一个大胆的简化:它完全抛弃了编码器,只保留了解码器部分。 这就是 Decoder-Only 架构的由来。
Decoder-Only 架构的工作模式被称为自回归 (Autoregressive) 。这个听起来很专业的术语,其实描述了一个非常简单的过程:
- 给模型一个起始文本(例如 “Datawhale Agent is”)。
- 模型预测出下一个最有可能的词(例如 “a”)。
- 模型将自己刚刚生成的词 “a” 添加到输入文本的末尾,形成新的输入(“Datawhale Agent is a”)。
- 模型基于这个新输入,再次预测下一个词(例如 “powerful”)。
- 不断重复这个过程,直到生成完整的句子或达到停止条件。
模型就像一个在玩“文字接龙”的游戏,它不断地“回顾”自己已经写下的内容,然后思考下一个字该写什么。
你可能会问,在训练时模型通常会一次性拿到完整文本,那么它是如何保证学习预测第 t+1 个词时,不去“偷看”更后面的答案呢?
答案就是掩码自注意力 (Masked Self-Attention) 。在 Decoder-Only 架构中,这个机制变得至关重要。它的工作原理非常巧妙:
在训练阶段,虽然一段文本可以被并行送入模型,但在自注意力机制计算出注意力分数矩阵(即每个词对其他所有词的关注度得分)之后、进行 Softmax 归一化之前,模型会应用一个“因果掩码”。这个掩码会将所有位于当前位置之后的词元对应的分数替换为一个非常大的负数。当这个带有负无穷分数的矩阵经过 Softmax 函数时,这些位置的概率就会变为 0。这样一来,模型在计算任意位置的表示时,都从数学上被阻止了去关注它后面的信息。
在生成阶段则更直接:未来的词元还没有生成出来,模型只能把已经生成的内容作为上下文输入,并一步步预测下一个词。掩码自注意力保证了训练时的学习方式与生成时的自回归使用方式保持一致,从而让模型始终只依赖当前位置之前的信息。
Decoder-Only 架构的优势
这种看似简单的架构,却带来了巨大的成功,其优势在于:
- 训练目标统一:模型的唯一任务就是“预测下一个词”,这个简单的目标非常适合在海量的无标注文本数据上进行预训练。
- 结构简单,易于扩展:更少的组件意味着更容易进行规模化扩展。今天的 GPT-4、Llama 等拥有数千亿甚至万亿参数的巨型模型,都是基于这种简洁的架构。
- 天然适合生成任务:其自回归的工作模式与所有生成式任务(对话、写作、代码生成等)完美契合,这也是它能成为构建通用智能体基础的核心原因。
总而言之,从 Transformer 的解码器演变而来的 Decoder-Only 架构,通过“预测下一个词”这一简单的范式,开启了我们今天所处的大语言模型时代。