在我们已经实现的 ReAct 和 Plan-and-Solve 范式中,智能体一旦完成了任务,其工作流程便告结束。然而,它们生成的初始答案,无论是行动轨迹还是最终结果,都可能存在谬误或有待改进之处。Reflection 机制的核心思想,正是为智能体引入一种事后(post-hoc)的自我校正循环,使其能够像人类一样,审视自己的工作,发现不足,并进行迭代优化。
4.4.1 Reflection 机制的核心思想
Reflection 机制的灵感来源于人类的学习过程:我们完成初稿后会进行校对,解出数学题后会进行验算。这一思想在多个研究中得到了体现,例如 Shinn, Noah 在2023年提出的 Reflexion 框架[3]。其核心工作流程可以概括为一个简洁的三步循环:执行 -> 反思 -> 优化。
- 执行 (Execution):首先,智能体使用我们熟悉的方法(如 ReAct 或 Plan-and-Solve)尝试完成任务,生成一个初步的解决方案或行动轨迹。这可以看作是“初稿”。
- 反思 (Reflection):接着,智能体进入反思阶段。它会调用一个独立的、或者带有特殊提示词的大语言模型实例,来扮演一个“评审员”的角色。这个“评审员”会审视第一步生成的“初稿”,并从多个维度进行评估,例如:
- 事实性错误:是否存在与常识或已知事实相悖的内容?
- 逻辑漏洞:推理过程是否存在不连贯或矛盾之处?
- 效率问题:是否有更直接、更简洁的路径来完成任务?
- 遗漏信息:是否忽略了问题的某些关键约束或方面? 根据评估,它会生成一段结构化的反馈 (Feedback),指出具体的问题所在和改进建议。
- 优化 (Refinement):最后,智能体将“初稿”和“反馈”作为新的上下文,再次调用大语言模型,要求它根据反馈内容对初稿进行修正,生成一个更完善的“修订稿”。
如图4.3所示,这个循环可以重复进行多次,直到反思阶段不再发现新的问题,或者达到预设的迭代次数上限。我们可以将这个迭代优化的过程形式化地表达出来。假设 是第 次迭代产生的输出( 为初始输出),反思模型 会生成针对 的反馈 :
随后,优化模型 会结合原始任务、上一版输出以及反馈,生成新一版的输出 :
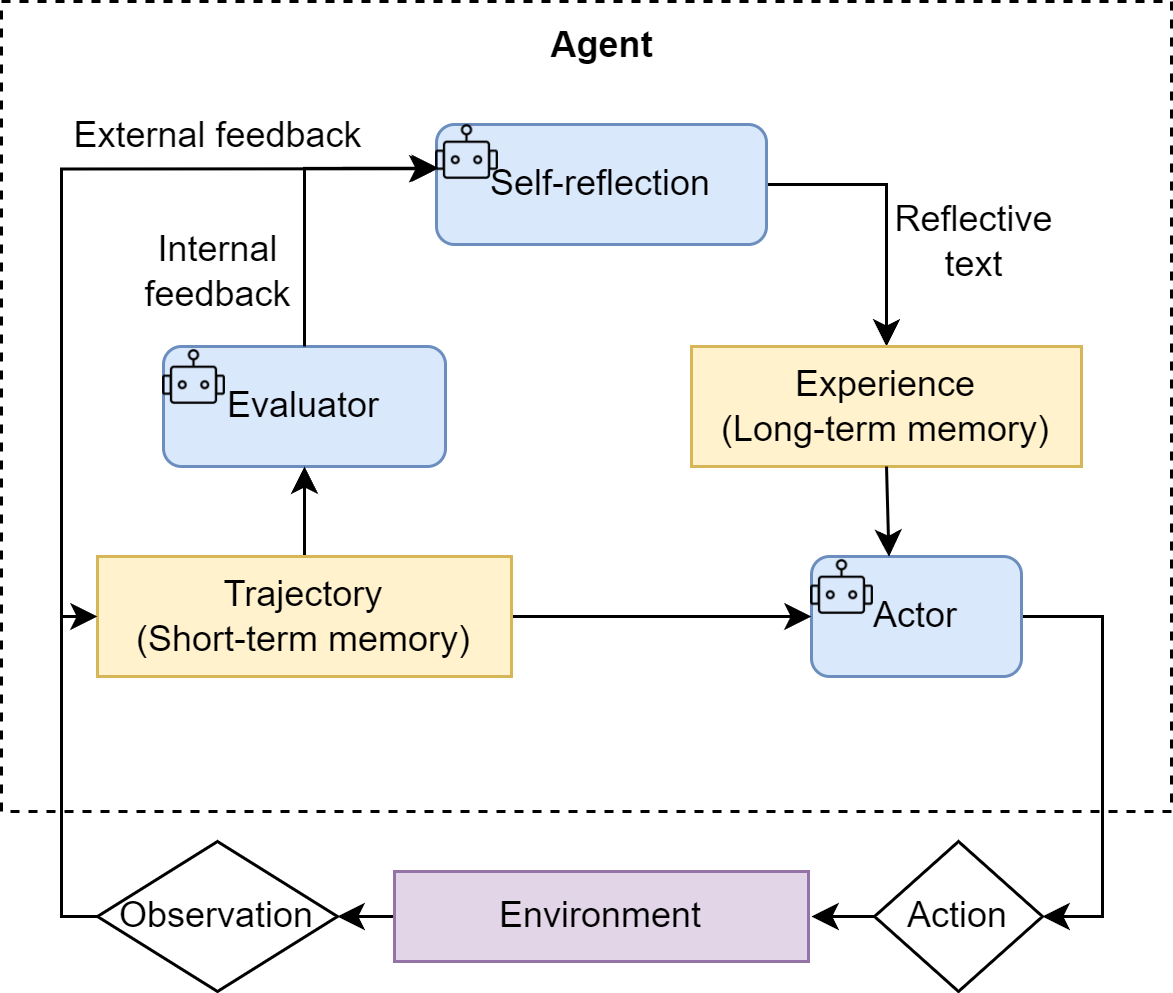
图 4.3 Reflection 机制中的“执行-反思-优化”迭代循环
与前两种范式相比,Reflection 的价值在于:
- 它为智能体提供了一个内部纠错回路,使其不再完全依赖于外部工具的反馈(ReAct 的 Observation),从而能够修正更高层次的逻辑和策略错误。
- 它将一次性的任务执行,转变为一个持续优化的过程,显著提升了复杂任务的最终成功率和答案质量。
- 它为智能体构建了一个临时的“短期记忆”。整个“执行-反思-优化”的轨迹形成了一个宝贵的经验记录,智能体不仅知道最终答案,还记得自己是如何从有缺陷的初稿迭代到最终版本的。更进一步,这个记忆系统还可以是多模态的,允许智能体反思和修正文本以外的输出(如代码、图像等),为构建更强大的多模态智能体奠定了基础。
4.4.2 案例设定与记忆模块设计
为了在实战中体现 Reflection 机制,我们将引入记忆管理机制,因为reflection通常对应着信息的存储和提取,如果上下文足够长的情况,想让“评审员”直接获取所有的信息然后进行反思往往会传入很多冗余信息。这一步实践我们主要完成代码生成与迭代优化。
这一步的目标任务是:“编写一个Python函数,找出1到n之间所有的素数 (prime numbers)。”
这个任务是检验 Reflection 机制的绝佳场景:
- 存在明确的优化路径:大语言模型初次生成的代码很可能是一个简单但效率低下的递归实现。
- 反思点清晰:可以通过反思发现其“时间复杂度过高”或“存在重复计算”的问题。
- 优化方向明确:可以根据反馈,将其优化为更高效的迭代版本或使用备忘录模式的版本。
Reflection 的核心在于迭代,而迭代的前提是能够记住之前的尝试和获得的反馈。因此,一个“短期记忆”模块是实现该范式的必需品。这个记忆模块将负责存储每一次“执行-反思”循环的完整轨迹。
from typing import List, Dict, Any, Optional

class Memory:
    """
    一个简单的短期记忆模块,用于存储智能体的行动与反思轨迹。
    """

    def __init__(self):
        """
        初始化一个空列表来存储所有记录。
        """
        self.records: List[Dict[str, Any]] = []

    def add_record(self, record_type: str, content: str):
        """
        向记忆中添加一条新记录。

        参数:
        - record_type (str): 记录的类型 ('execution' 或 'reflection')。
        - content (str): 记录的具体内容 (例如,生成的代码或反思的反馈)。
        """
        record = {"type": record_type, "content": content}
        self.records.append(record)
        print(f"📝 记忆已更新,新增一条 '{record_type}' 记录。")

    def get_trajectory(self) -> str:
        """
        将所有记忆记录格式化为一个连贯的字符串文本,用于构建提示词。
        """
        trajectory_parts = []
        for record in self.records:
            if record['type'] == 'execution':
                trajectory_parts.append(f"--- 上一轮尝试 (代码) ---\n{record['content']}")
            elif record['type'] == 'reflection':
                trajectory_parts.append(f"--- 评审员反馈 ---\n{record['content']}")

        return "\n\n".join(trajectory_parts)

    def get_last_execution(self) -> Optional[str]:
        """
        获取最近一次的执行结果 (例如,最新生成的代码)。
        如果不存在,则返回 None。
        """
        for record in reversed(self.records):
            if record['type'] == 'execution':
                return record['content']
        return None
这个 Memory 类的设计比较简洁,主体是这样的:
- 使用一个列表
records来按顺序存储每一次的行动和反思。 add_record方法负责向记忆中添加新的条目。get_trajectory方法是核心,它将记忆轨迹“序列化”成一段文本,可以直接插入到后续的提示词中,为模型的反思和优化提供完整的上下文。get_last_execution方便我们获取最新的“初稿”以供反思。
4.4.3 Reflection 智能体的编码实现
有了 Memory 模块作为基础,我们现在可以着手构建 ReflectionAgent 的核心逻辑。整个智能体的工作流程将围绕我们之前讨论的“执行-反思-优化”循环展开,并通过精心设计的提示词来引导大语言模型扮演不同的角色。
(1)提示词设计
与之前的范式不同,Reflection 机制需要多个不同角色的提示词来协同工作。
- 初始执行提示词 (Execution Prompt) :这是智能体首次尝试解决问题的提示词,内容相对直接,只要求模型完成指定任务。
INITIAL_PROMPT_TEMPLATE = """
你是一位资深的Python程序员。请根据以下要求,编写一个Python函数。
你的代码必须包含完整的函数签名、文档字符串,并遵循PEP 8编码规范。

要求: {task}

请直接输出代码,不要包含任何额外的解释。
"""
- 反思提示词 (Reflection Prompt) :这个提示词是 Reflection 机制的灵魂。它指示模型扮演“代码评审员”的角色,对上一轮生成的代码进行批判性分析,并提供具体的、可操作的反馈。
REFLECT_PROMPT_TEMPLATE = """
你是一位极其严格的代码评审专家和资深算法工程师,对代码的性能有极致的要求。
你的任务是审查以下Python代码,并专注于找出其在<strong>算法效率</strong>上的主要瓶颈。

# 原始任务:
{task}

# 待审查的代码:
```python
{code}
```

请分析该代码的时间复杂度,并思考是否存在一种<strong>算法上更优</strong>的解决方案来显著提升性能。
如果存在,请清晰地指出当前算法的不足,并提出具体的、可行的改进算法建议(例如,使用筛法替代试除法)。
如果代码在算法层面已经达到最优,才能回答“无需改进”。

请直接输出你的反馈,不要包含任何额外的解释。
"""
- 优化提示词 (Refinement Prompt) :当收到反馈后,这个提示词将引导模型根据反馈内容,对原有代码进行修正和优化。
REFINE_PROMPT_TEMPLATE = """
你是一位资深的Python程序员。你正在根据一位代码评审专家的反馈来优化你的代码。

# 原始任务:
{task}

# 你上一轮尝试的代码:
{last_code_attempt}
评审员的反馈:
{feedback}

请根据评审员的反馈,生成一个优化后的新版本代码。
你的代码必须包含完整的函数签名、文档字符串,并遵循PEP 8编码规范。
请直接输出优化后的代码,不要包含任何额外的解释。
"""
(2)智能体封装与实现
现在,我们将这套提示词逻辑和 Memory 模块整合到 ReflectionAgent 类中。
# 假设 llm_client.py 和 memory.py 已定义
# from llm_client import HelloAgentsLLM
# from memory import Memory

class ReflectionAgent:
    def __init__(self, llm_client, max_iterations=3):
        self.llm_client = llm_client
        self.memory = Memory()
        self.max_iterations = max_iterations

    def run(self, task: str):
        print(f"\n--- 开始处理任务 ---\n任务: {task}")

        # --- 1. 初始执行 ---
        print("\n--- 正在进行初始尝试 ---")
        initial_prompt = INITIAL_PROMPT_TEMPLATE.format(task=task)
        initial_code = self._get_llm_response(initial_prompt)
        self.memory.add_record("execution", initial_code)

        # --- 2. 迭代循环:反思与优化 ---
        for i in range(self.max_iterations):
            print(f"\n--- 第 {i+1}/{self.max_iterations} 轮迭代 ---")

            # a. 反思
            print("\n-> 正在进行反思...")
            last_code = self.memory.get_last_execution()
            reflect_prompt = REFLECT_PROMPT_TEMPLATE.format(task=task, code=last_code)
            feedback = self._get_llm_response(reflect_prompt)
            self.memory.add_record("reflection", feedback)

            # b. 检查是否需要停止
            if "无需改进" in feedback:
                print("\n✅ 反思认为代码已无需改进,任务完成。")
                break

            # c. 优化
            print("\n-> 正在进行优化...")
            refine_prompt = REFINE_PROMPT_TEMPLATE.format(
                task=task,
                last_code_attempt=last_code,
                feedback=feedback
            )
            refined_code = self._get_llm_response(refine_prompt)
            self.memory.add_record("execution", refined_code)

        final_code = self.memory.get_last_execution()
        print(f"\n--- 任务完成 ---\n最终生成的代码:\n```python\n{final_code}\n```")
        return final_code

    def _get_llm_response(self, prompt: str) -> str:
        """一个辅助方法,用于调用LLM并获取完整的流式响应。"""
        messages = [{"role": "user", "content": prompt}]
        response_text = self.llm_client.think(messages=messages) or ""
        return response_text
4.4.4 运行实例与分析
完整的代码同样参考本书配套的代码仓库 code 文件夹,这里提供一个输出实例。
--- 开始处理任务 ---
任务: 编写一个Python函数,找出1到n之间所有的素数 (prime numbers)。

--- 正在进行初始尝试 ---
🧠 正在调用 xxxxxx 模型...
✅ 大语言模型响应成功:
```python
def find_primes(n):
    ...
    return primes
```
📝 记忆已更新,新增一条 'execution' 记录。

--- 第 1/2 轮迭代 ---

-> 正在进行反思...
🧠 正在调用 xxxxxx 模型...
✅ 大语言模型响应成功:
当前代码的时间复杂度为O(n * sqrt(n))。虽然对于较小的n值,这种实现是可以接受的,但当n非常大时,性能会显著下降。主要瓶颈在于每个数都需要进行试除法检查,这导致了较高的时间开销。

建议使用埃拉托斯特尼筛法(Sieve of Eratosthenes),该算法的时间复杂度为O(n log(log n)),能够显著提高查找素数的效率。

改进后的代码如下:
```python
def find_primes(n):
    ...
    return primes
```
📝 记忆已更新,新增一条 'reflection' 记录。

-> 正在进行优化...
🧠 正在调用 xxxxxx 模型...
✅ 大语言模型响应成功:
```python
def find_primes(n):
    ...
    return primes
```
📝 记忆已更新,新增一条 'execution' 记录。

--- 第 2/2 轮迭代 ---

-> 正在进行反思...
🧠 正在调用 xxxxxx 模型...
✅ 大语言模型响应成功:
当前代码使用了Eratosthenes筛法,时间复杂度为O(n log log n),空间复杂度为O(n)。此算法在寻找1到n之间的所有素数时已经非常高效,通常情况下无需进一步优化。但在某些特定场景下,可以考虑以下改进:

1. <strong>分段筛法(Segmented Sieve)</strong>:适用于n非常大但内存有限的情况。将区间分成多个小段,每段分别用筛法处理,减少内存使用。
2. <strong>奇数筛法(Odd Number Sieve)</strong>:除了2以外,所有素数都是奇数。可以在初始化`is_prime`数组时只标记奇数,这样可以将空间复杂度降低一半,同时减少一些不必要的计算。

然而,这些改进对于大多数应用场景来说并不是必需的,因为标准的Eratosthenes筛法已经足够高效。因此,在一般情况下,<strong>无需改进</strong>。
📝 记忆已更新,新增一条 'reflection' 记录。

✅ 反思认为代码已无需改进,任务完成。

--- 任务完成 ---
最终生成的代码:
```python
def find_primes(n):
    """
    Finds all prime numbers between 1 and n using the Sieve of Eratosthenes algorithm.

    :param n: The upper limit of the range to find prime numbers.
    :return: A list of all prime numbers between 1 and n.
    """
    if n < 2:
        return []

    is_prime = [True] * (n + 1)
    is_prime[0] = is_prime[1] = False

    p = 2
    while p * p <= n:
        if is_prime[p]:
            for i in range(p * p, n + 1, p):
                is_prime[i] = False
        p += 1

    primes = [num for num in range(2, n + 1) if is_prime[num]]
    return primes
```
这个运行实例展示了 Reflection 机制是如何驱动智能体进行深度优化的:
- 有效的“批判”是优化的前提:在第一轮反思中,由于我们使用了“极其严格”且“专注于算法效率”的提示词,智能体没有满足于功能正确的初版代码,而是精准地指出了其
O(n * sqrt(n))的时间复杂度瓶颈,并提出了算法层面的改进建议——埃拉托斯特尼筛法。 - 迭代式改进: 智能体在接收到明确的反馈后,于优化阶段成功地实现了更高效的筛法,将算法复杂度降至
O(n log log n),完成了第一次有意义的自我迭代。 - 收敛与终止: 在第二轮反思中,智能体面对已经高效的筛法,展现出了更深层次的知识。它不仅肯定了当前算法的效率,甚至还提及了分段筛法等更高级的优化方向,但最终做出了“在一般情况下无需改进”的正确判断。这个判断触发了我们的终止条件,使优化过程得以收敛。
这个案例充分证明,一个设计良好的 Reflection 机制,其价值不仅在于修复错误,更在于驱动解决方案在质量和效率上实现阶梯式的提升,这使其成为构建复杂、高质量智能体的关键技术之一。
4.4.5 Reflection 机制的成本收益分析
尽管 Reflection 机制在提升任务解决质量上表现出色,但这种能力的获得并非没有代价。在实际应用中,我们需要权衡其带来的收益与相应的成本。
(1)主要成本
-
模型调用开销增加:这是最直接的成本。每进行一轮迭代,至少需要额外调用两次大语言模型(一次用于反思,一次用于优化)。如果迭代多轮,API 调用成本和计算资源消耗将成倍增加。
-
任务延迟显著提高:Reflection 是一个串行过程,每一轮的优化都必须等待上一轮的反思完成。这使得任务的总耗时显著延长,不适合对实时性要求高的场景。
-
提示工程复杂度上升:如我们的案例所示,Reflection 的成功在很大程度上依赖于高质量、有针对性的提示词。为“执行”、“反思”、“优化”等不同阶段设计和调试有效的提示词,需要投入更多的开发精力。
(2)核心收益
-
解决方案质量的跃迁:最大的收益在于,它能将一个“合格”的初始方案,迭代优化成一个“优秀”的最终方案。这种从功能正确到性能高效、从逻辑粗糙到逻辑严谨的提升,在很多关键任务中是至关重要的。
-
鲁棒性与可靠性增强:通过内部的自我纠错循环,智能体能够发现并修复初始方案中可能存在的逻辑漏洞、事实性错误或边界情况处理不当等问题,从而大大提高了最终结果的可靠性。
综上所述,Reflection 机制是一种典型的“以成本换质量”的策略。它非常适合那些对最终结果的质量、准确性和可靠性有极高要求,且对任务完成的实时性要求相对宽松的场景。例如:
- 生成关键的业务代码或技术报告。
- 在科学研究中进行复杂的逻辑推演。
- 需要深度分析和规划的决策支持系统。
反之,如果应用场景需要快速响应,或者一个“大致正确”的答案就已经足够,那么使用更轻量的 ReAct 或 Plan-and-Solve 范式可能会是更具性价比的选择。