12.1.1 为何需要智能体评估
我们现在的 SimpleAgent,它已经具备了强大的推理和工具调用能力。让我们看一个典型的使用场景:
from hello_agents import SimpleAgent, HelloAgentsLLM
from hello_agents.tools import SearchTool

# 创建LLM和智能体
llm = HelloAgentsLLM()

# 创建一个强调工具使用的系统提示词
system_prompt = """你是一个AI助手,可以使用搜索工具来获取最新信息。

当需要搜索信息时,请使用以下格式:
[TOOL_CALL:search:搜索关键词]

例如:
- [TOOL_CALL:search:最新AI新闻]
- [TOOL_CALL:search:Python编程教程]

请在回答问题前先使用搜索工具获取最新信息。"""

agent = SimpleAgent(name="AI助手", llm=llm, system_prompt=system_prompt)

# 添加搜索工具
agent.add_tool(SearchTool())

# 示例:使用搜索工具回答问题
response = agent.run("最新的AI技术发展趋势是什么?")
print(f"\n回答:{response}")
这个智能体能正常工作,但我们面临一个核心问题:如何客观地评估它的性能?当我们优化提示词或更换 LLM 模型后,如何知道是否真的有改进?在部署到生产环境前,如何保证智能体的可靠性?这些问题都需要通过系统化的评估来解决。
智能体评估的核心价值在于提供标准化的方法来衡量智能体的能力。通过评估,我们可以用具体的数字指标量化智能体的表现,客观比较不同设计方案的优劣,及时发现智能体在特定场景下的弱点,并向用户证明智能体的可靠性。
与传统软件测试不同,智能体评估面临着独特的挑战。首先是输出的不确定性,同一问题可能有多个正确答案,很难用简单的对错来判断。其次是评估标准的多样性,不同任务需要不同的评估方法,工具调用需要检查函数签名,问答任务需要评估语义相似度。最后是评估成本的高昂,每次评估都需要大量的 API 调用,成本可能达到数百元甚至更多。
为了应对这些挑战,学术界和工业界提出了多个标准化的评估基准(Benchmark)。这些基准提供了统一的数据集、评估指标和评分方法,使我们能够在相同的标准下评估和对比不同的智能体系统。
12.1.2 主流评估基准概览
智能体评估领域已经涌现出多个具有影响力的基准测试。下面介绍一些主流的评估基准和指标:
(1)工具调用能力评估
工具调用是智能体的核心能力之一。智能体需要理解用户意图,选择合适的工具,并正确构造函数调用。相关的评估基准包括:
- BFCL (Berkeley Function Calling Leaderboard)[1]:UC Berkeley 推出,包含 1120+测试样本,涵盖 simple、multiple、parallel、irrelevance 四个类别,使用 AST 匹配算法评估,数据集规模适中,社区活跃。
- ToolBench[2]:清华大学推出,包含 16000+真实 API 调用场景,覆盖真实世界的复杂工具使用场景。
- API-Bank[3]:Microsoft Research 推出,包含 53 个常用 API 工具,专注于评估智能体对 API 文档的理解和调用能力。
(2)通用能力评估
评估智能体在真实世界任务中的综合表现,包括多步推理、知识运用、多模态理解等能力:
- GAIA (General AI Assistants)[4]:Meta AI 和 Hugging Face 联合推出,包含 466 个真实世界问题,分为 Level 1/2/3 三个难度级别,评估多步推理、工具使用、文件处理、网页浏览等能力,使用准精确匹配(Quasi Exact Match)算法,任务真实且综合性强。
- AgentBench[5]:清华大学推出,包含 8 个不同领域的任务,全面评估智能体的通用能力。
- WebArena[6]:CMU 推出,评估智能体在真实网页环境中的任务完成能力和网页交互能力。
(3)多智能体协作评估
评估多个智能体协同工作的能力:
- ChatEval[7]:评估多智能体对话系统的质量。
- SOTOPIA[8]:评估智能体在社交场景中的互动能力。
- 自定义协作场景:根据具体应用场景设计的评估任务。
(4)常用评估指标
不同基准使用不同的评估指标,常见的包括:
- 准确性指标:Accuracy(准确率)、Exact Match(精确匹配)、F1 Score(F1 分数),用于衡量答案的正确性。
- 效率指标:Response Time(响应时间)、Token Usage(Token 使用量),用于衡量执行效率。
- 鲁棒性指标:Error Rate(错误率)、Failure Recovery(故障恢复),用于衡量容错能力。
- 协作指标:Communication Efficiency(通信效率)、Task Completion(任务完成度),用于衡量协作效果。
12.1.3 HelloAgents 评估体系设计
考虑到学习曲线和实用性,本章将重点介绍以下评估场景:
-
BFCL:评估工具调用能力
- 选择理由:数据集规模适中,评估指标清晰,社区活跃
- 适用场景:评估智能体的函数调用准确性
-
GAIA:评估通用 AI 助手能力
- 选择理由:任务真实,难度分级,综合性强
- 适用场景:评估智能体的综合问题解决能力
-
数据生成质量评估:评估 LLM 生成数据质量
- 选择理由:通过这个案例可以完整体验如何使用 Agent 创造数据,评估数据的完整演示。
- 适用场景:评估生成的训练数据、测试数据的质量
- 评估方法:LLM Judge、Win Rate、人工验证
通过这三个评估场景,我们将构建一个完整的评估体系,如图 12.1 展示了我们的评估系统构建思路。
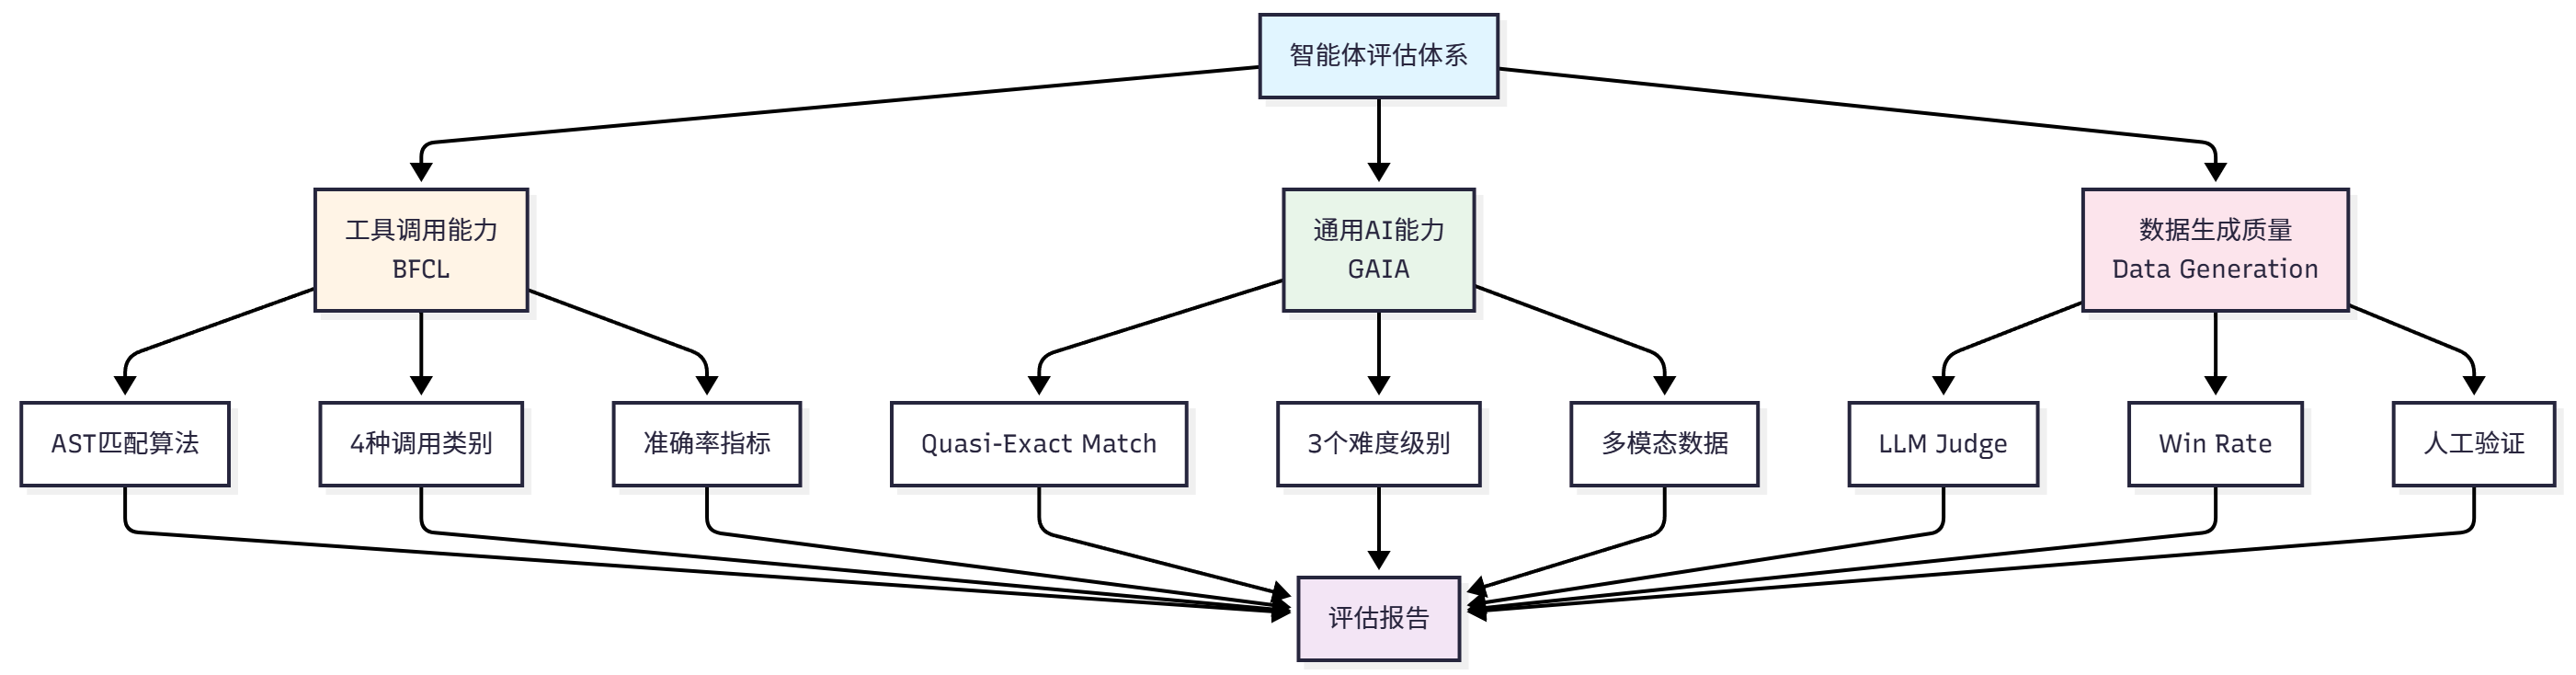
图 12.1 HelloAgents 评估体系架构图
12.1.4 本章学习目标与快速体验
让我们先看看第十二章的学习内容:
hello_agents/
├── evaluation/                         # 评估模块
│   └── benchmarks/                     # 评估基准实现
│       ├── bfcl/                       # BFCL评估实现
│       │   ├── dataset.py              # BFCL数据集加载器
│       │   ├── evaluator.py            # BFCL评估器(AST匹配)
│       │   ├── metrics.py              # BFCL专用指标
│       │   └── ast_matcher.py          # AST匹配算法
│       ├── gaia/                       # GAIA评估实现
│       │   ├── dataset.py              # GAIA数据集加载器
│       │   ├── evaluator.py            # GAIA评估器(准精确匹配)
│       │   ├── metrics.py              # GAIA专用指标
│       │   └── quasi_exact_match.py    # 准精确匹配算法
│       └── data_generation/            # 数据生成评估实现
│           ├── dataset.py              # AIME数据集加载器
│           ├── llm_judge.py            # LLM Judge评估器
│           └── win_rate.py             # Win Rate评估器
└── tools/builtin/                      # 内置工具模块
    ├── bfcl_evaluation_tool.py         # BFCL评估工具
    ├── gaia_evaluation_tool.py         # GAIA评估工具
    ├── llm_judge_tool.py               # LLM Judge工具
    └── win_rate_tool.py                # Win Rate工具
对于这一章的内容,学习目标是掌握应用评估工具的能力。让我们先准备好开发环境:
# 安装HelloAgents框架(第12章版本)
pip install "hello-agents[evaluation]==0.2.7"

# 设置环境变量
export HF_TOKEN="your_huggingface_token"     # 用于GAIA数据集(后续也会有设置步骤)

# 由于 `bfcl-eval` 官方包强制要求 numpy<=2.0.0, 和HelloAgents 主依赖版本存在冲突,因此需要单独安装
pip install "numpy==1.26.4" bfcl-eval
在接下来的章节中,我们将深入学习每种评估方法的详细用法和介绍。