在前面的章节中,我们分别学习了数据准备、SFT 训练、GRPO 训练和模型评估。现在,让我们把这些知识整合起来,完成一个端到端的 Agentic RL 训练流程。
11.6.1 端到端训练流程
一个完整的 Agentic RL 训练流程包括以下阶段:数据准备、SFT 训练、SFT 评估、GRPO 训练、GRPO 评估、模型部署。如图 11.9 所示。

图 11.9 端到端训练流程
让我们通过一个完整的脚本来实现这个流程:
"""
完整的Agentic RL训练流程
从数据准备到模型部署的端到端示例
"""

from hello_agents.tools import RLTrainingTool
import json
from datetime import datetime

class AgenticRLPipeline:
    """Agentic RL训练流水线"""

    def __init__(self, config_path="config.json"):
        """
        初始化训练流水线

        Args:
            config_path: 配置文件路径
        """
        self.rl_tool = RLTrainingTool()
        self.config = self.load_config(config_path)
        self.results = {}

    def load_config(self, config_path):
        """加载配置文件"""
        with open(config_path, 'r') as f:
            return json.load(f)

    def log(self, message):
        """记录日志"""
        timestamp = datetime.now().strftime("%Y-%m-%d %H:%M:%S")
        print(f"[{timestamp}] {message}")

    def stage1_prepare_data(self):
        """阶段1: 数据准备"""
        self.log("=" * 50)
        self.log("阶段1: 数据准备")
        self.log("=" * 50)

        # 加载并检查数据集
        result = self.rl_tool.run({
            "action": "load_dataset",
            "format": "sft",
            "max_samples": self.config["data"]["max_samples"],
        })

        # 解析JSON结果
        dataset_info = json.loads(result)

        self.log(f"✓ 数据集加载完成")
        self.log(f"  - 样本数: {dataset_info['dataset_size']}")
        self.log(f"  - 格式: {dataset_info['format']}")
        self.log(f"  - 数据列: {', '.join(dataset_info['sample_keys'])}")

        self.results["data"] = dataset_info

        return dataset_info

    def stage2_sft_training(self):
        """阶段2: SFT训练"""
        self.log("\n" + "=" * 50)
        self.log("阶段2: SFT训练")
        self.log("=" * 50)

        sft_config = self.config["sft"]

        result = self.rl_tool.run({
            "action": "train",
            "algorithm": "sft",
            "model_name": self.config["model"]["base_model"],
            "output_dir": sft_config["output_dir"],
            "max_samples": self.config["data"]["max_samples"],
            "num_epochs": sft_config["num_epochs"],
            "batch_size": sft_config["batch_size"],
            "use_lora": True,
            # 训练监控配置
            "use_wandb": self.config.get("monitoring", {}).get("use_wandb", False),
            "use_tensorboard": self.config.get("monitoring", {}).get("use_tensorboard", True),
            "wandb_project": self.config.get("monitoring", {}).get("wandb_project", None),
        })

        # 解析JSON结果
        result_data = json.loads(result)

        self.log(f"✓ SFT训练完成")
        self.log(f"  - 模型路径: {result_data['output_dir']}")
        self.log(f"  - 状态: {result_data['status']}")

        self.results["sft_training"] = result_data

        return result_data["output_dir"]

    def stage3_sft_evaluation(self, model_path):
        """阶段3: SFT评估"""
        self.log("\n" + "=" * 50)
        self.log("阶段3: SFT评估")
        self.log("=" * 50)

        result = self.rl_tool.run({
            "action": "evaluate",
            "model_path": model_path,
            "max_samples": self.config["eval"]["max_samples"],
            "use_lora": True,
        })
        eval_data = json.loads(result)

        self.log(f"✓ SFT评估完成")
        self.log(f"  - 准确率: {eval_data['accuracy']}")
        self.log(f"  - 平均奖励: {eval_data['average_reward']}")

        self.results["sft_evaluation"] = eval_data

        return eval_data

    def stage4_grpo_training(self, sft_model_path):
        """阶段4: GRPO训练"""
        self.log("\n" + "=" * 50)
        self.log("阶段4: GRPO训练")
        self.log("=" * 50)

        grpo_config = self.config["grpo"]

        result = self.rl_tool.run({
            "action": "train",
            "algorithm": "grpo",
            "model_name": sft_model_path,
            "output_dir": grpo_config["output_dir"],
            "max_samples": self.config["data"]["max_samples"],
            "num_epochs": grpo_config["num_epochs"],
            "batch_size": grpo_config["batch_size"],
            "use_lora": True,
            # 训练监控配置
            "use_wandb": self.config.get("monitoring", {}).get("use_wandb", False),
            "use_tensorboard": self.config.get("monitoring", {}).get("use_tensorboard", True),
            "wandb_project": self.config.get("monitoring", {}).get("wandb_project", None),
        })

        # 解析JSON结果
        result_data = json.loads(result)

        self.log(f"✓ GRPO训练完成")
        self.log(f"  - 模型路径: {result_data['output_dir']}")
        self.log(f"  - 状态: {result_data['status']}")

        self.results["grpo_training"] = result_data

        return result_data["output_dir"]

    def stage5_grpo_evaluation(self, model_path):
        """阶段5: GRPO评估"""
        self.log("\n" + "=" * 50)
        self.log("阶段5: GRPO评估")
        self.log("=" * 50)

        result = self.rl_tool.run({
            "action": "evaluate",
            "model_path": model_path,
            "max_samples": self.config["eval"]["max_samples"],
            "use_lora": True,
        })
        eval_data = json.loads(result)

        self.log(f"✓ GRPO评估完成")
        self.log(f"  - 准确率: {eval_data['accuracy']}")
        self.log(f"  - 平均奖励: {eval_data['average_reward']}")

        self.results["grpo_evaluation"] = eval_data

        return eval_data

    def stage6_save_results(self):
        """阶段6: 保存结果"""
        self.log("\n" + "=" * 50)
        self.log("阶段6: 保存结果")
        self.log("=" * 50)

        # 保存训练结果
        results_path = "training_results.json"
        with open(results_path, 'w') as f:
            json.dump(self.results, f, indent=2)

        self.log(f"✓ 结果已保存到: {results_path}")

    def run(self):
        """运行完整流程"""
        try:
            # 阶段1: 数据准备
            self.stage1_prepare_data()

            # 阶段2: SFT训练
            sft_model_path = self.stage2_sft_training()

            # 阶段3: SFT评估
            self.stage3_sft_evaluation(sft_model_path)

            # 阶段4: GRPO训练
            grpo_model_path = self.stage4_grpo_training(sft_model_path)

            # 阶段5: GRPO评估
            self.stage5_grpo_evaluation(grpo_model_path)

            # 阶段6: 保存结果
            self.stage6_save_results()

            self.log("\n" + "=" * 50)
            self.log("✓ 训练流程完成!")
            self.log("=" * 50)

        except Exception as e:
            self.log(f"\n✗ 训练失败: {str(e)}")
            raise

# 使用示例
if __name__ == "__main__":
    # 创建配置文件
    config = {
        "model": {
            "base_model": "Qwen/Qwen3-0.6B"
        },
        "data": {
            "max_samples": 1000  # 使用1000个样本
        },
        "sft": {
            "output_dir": "./models/sft_model",
            "num_epochs": 3,
            "batch_size": 8,
        },
        "grpo": {
            "output_dir": "./models/grpo_model",
            "num_epochs": 3,
            "batch_size": 4,
        },
        "eval": {
            "max_samples": 200,
            "sft_accuracy_threshold": 0.40  # SFT准确率阈值
        },
        "monitoring": {
            "use_wandb": False,  # 是否使用Wandb
            "use_tensorboard": True,  # 是否使用TensorBoard
            "wandb_project": "agentic-rl-pipeline"  # Wandb项目名
        }
    }

    # 保存配置
    with open("config.json", 'w') as f:
        json.dump(config, f, indent=2)

    # 运行训练流程
    pipeline = AgenticRLPipeline("config.json")
    pipeline.run()
运行这个脚本,你将看到完整的训练过程。
运行小建议:
从小规模开始:不要一开始就用全部数据训练。先用 100-1000 个样本快速迭代,验证流程和参数,确认效果后再扩大规模。这样可以节省大量时间和计算资源。
数据质量检查:在训练前检查数据质量,确保格式正确、答案准确、没有重复样本。可以使用以下代码:
def check_data_quality(dataset):
    """检查数据质量"""
    issues = []

    # 检查必需字段
    required_fields = ["prompt", "completion"]
    for field in required_fields:
        if field not in dataset.column_names:
            issues.append(f"缺少字段: {field}")

    # 检查空值
    for i, sample in enumerate(dataset):
        if not sample["prompt"] or not sample["completion"]:
            issues.append(f"样本{i}包含空值")

    # 检查重复
    prompts = [s["prompt"] for s in dataset]
    duplicates = len(prompts) - len(set(prompts))
    if duplicates > 0:
        issues.append(f"发现{duplicates}个重复样本")

    return issues

# 使用
issues = check_data_quality(dataset)
if issues:
    print("数据质量问题:")
    for issue in issues:
        print(f"  - {issue}")
else:
    print("✓ 数据质量检查通过")
数据增强:如果数据量不足,可以考虑数据增强,如改写问题(保持答案不变)、生成相似问题、反向翻译(translate back)。但要注意保持数据质量,避免引入噪声。
11.6.2 超参数调优
超参数调优是提升模型性能的关键。下面是一些常用的调优策略。
(1)网格搜索
网格搜索(Grid Search)是最简单的调优方法,遍历所有参数组合,选择最佳的一组。
# 定义参数网格
param_grid = {
    "learning_rate": [1e-5, 5e-5, 1e-4],
    "lora_rank": [8, 16, 32],
    "kl_coef": [0.05, 0.1, 0.2],
}

best_accuracy = 0
best_params = None

# 遍历所有组合
for lr in param_grid["learning_rate"]:
    for rank in param_grid["lora_rank"]:
        for kl in param_grid["kl_coef"]:
            print(f"测试参数: lr={lr}, rank={rank}, kl={kl}")

            # 训练模型
            result = rl_tool.run({
                "action": "train",
                "algorithm": "grpo",
                "learning_rate": lr,
                "lora_rank": rank,
                "kl_coef": kl,
                # 其他参数...
            })

            # 评估模型
            eval_result = rl_tool.run({
                "action": "evaluate",
                "model_path": result["model_path"],
            })

            # 更新最佳参数
            if eval_result["accuracy"] > best_accuracy:
                best_accuracy = eval_result["accuracy"]
                best_params = {"lr": lr, "rank": rank, "kl": kl}

print(f"最佳参数: {best_params}")
print(f"最佳准确率: {best_accuracy:.2%}")
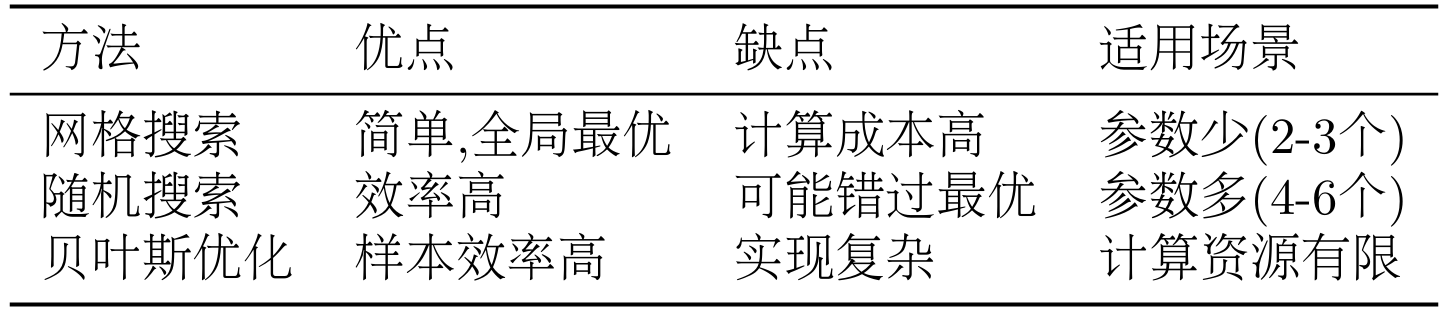
网格搜索的优点是简单直接,能找到全局最优。缺点是计算成本高,参数多时不可行。
(2)随机搜索
随机搜索(Random Search)随机采样参数组合,比网格搜索更高效。
import random

# 定义参数范围
param_ranges = {
    "learning_rate": (1e-6, 1e-4),  # 对数均匀分布
    "lora_rank": [4, 8, 16, 32, 64],
    "kl_coef": (0.01, 0.5),
}

best_accuracy = 0
best_params = None

# 随机采样N次
N = 10
for i in range(N):
    # 随机采样参数
    lr = 10 ** random.uniform(-6, -4)  # 对数均匀
    rank = random.choice(param_ranges["lora_rank"])
    kl = random.uniform(0.01, 0.5)

    print(f"[{i+1}/{N}] 测试参数: lr={lr:.2e}, rank={rank}, kl={kl:.3f}")

    # 训练和评估(同上)
    # ...

print(f"最佳参数: {best_params}")
print(f"最佳准确率: {best_accuracy:.2%}")
随机搜索的优点是效率高,适合参数空间大的情况。缺点是可能错过最优解。
(3)贝叶斯优化
贝叶斯优化(Bayesian Optimization)使用概率模型指导搜索,更加智能。可以使用 Optuna 等库:
import optuna

def objective(trial):
    """优化目标函数"""
    # 采样参数
    lr = trial.suggest_loguniform("learning_rate", 1e-6, 1e-4)
    rank = trial.suggest_categorical("lora_rank", [8, 16, 32])
    kl = trial.suggest_uniform("kl_coef", 0.01, 0.5)

    # 训练模型
    result = rl_tool.run({
        "action": "train",
        "algorithm": "grpo",
        "learning_rate": lr,
        "lora_rank": rank,
        "kl_coef": kl,
        # 其他参数...
    })

    # 评估模型
    eval_result = rl_tool.run({
        "action": "evaluate",
        "model_path": result["model_path"],
    })

    return eval_result["accuracy"]

# 创建研究
study = optuna.create_study(direction="maximize")
study.optimize(objective, n_trials=20)

# 打印最佳参数
print(f"最佳参数: {study.best_params}")
print(f"最佳准确率: {study.best_value:.2%}")
贝叶斯优化的优点是样本效率高,能快速找到好的参数。缺点是实现复杂,需要额外的库。
如表 11.8 所示,不同调优方法的对比。
表 11.8 超参数调优方法对比
11.6.3 分布式训练
当数据量和模型规模增大时,单 GPU 训练会变得非常缓慢。这时我们需要使用分布式训练来加速训练过程。HelloAgents 基于 TRL 和 Hugging Face Accelerate,天然支持多 GPU 和多节点分布式训练
方案选择建议:
- 单机多卡(2-8 卡): 使用 DDP,简单高效
- 大模型(>7B): 使用 DeepSpeed ZeRO-2 或 ZeRO-3
- 多节点集群: 使用 DeepSpeed ZeRO-3 + Offload
(1)配置 Accelerate
首先需要创建 Accelerate 配置文件。运行以下命令:
accelerate config
根据提示选择配置:
In which compute environment are you running?
> This machine

Which type of machine are you using?
> multi-GPU

How many different machines will you use?
> 1

Do you wish to optimize your script with torch dynamo?
> NO

Do you want to use DeepSpeed?
> YES

Which DeepSpeed config file do you want to use?
> ZeRO-2

How many GPU(s) should be used for distributed training?
> 4
这会在~/.cache/huggingface/accelerate/default_config.yaml生成配置文件。
(2)使用 DDP 训练
数据并行(DDP)是最简单的分布式方案,每个 GPU 持有完整模型副本,数据被分割到各个 GPU 上。
Accelerate 配置文件 (multi_gpu_ddp.yaml):
compute_environment: LOCAL_MACHINE
distributed_type: MULTI_GPU
num_processes: 4  # GPU数量
machine_rank: 0
num_machines: 1
gpu_ids: all
mixed_precision: fp16
训练脚本 (无需修改):
from hello_agents.tools import RLTrainingTool

rl_tool = RLTrainingTool()

# 训练代码完全不变
result = rl_tool.run({
    "action": "train",
    "algorithm": "grpo",
    "model_name": "Qwen/Qwen3-0.6B",
    "output_dir": "./models/grpo_ddp",
    "num_epochs": 3,
    "batch_size": 4,  # 每个GPU的batch size
    "use_lora": True,
})
启动训练:
# 使用配置文件
accelerate launch --config_file multi_gpu_ddp.yaml train_script.py

# 或者直接指定参数
accelerate launch --num_processes 4 --mixed_precision fp16 train_script.py
(3)使用 DeepSpeed ZeRO 训练
DeepSpeed ZeRO通过分片优化器状态、梯度和模型参数,大幅降低显存占用,支持更大的模型和 batch size。
ZeRO-2 配置文件 (deepspeed_zero2.yaml):
compute_environment: LOCAL_MACHINE
distributed_type: DEEPSPEED
num_processes: 4
machine_rank: 0
num_machines: 1
gpu_ids: all
mixed_precision: fp16
deepspeed_config:
  gradient_accumulation_steps: 4
  gradient_clipping: 1.0
  offload_optimizer_device: none
  offload_param_device: none
  zero3_init_flag: false
  zero_stage: 2  # ZeRO-2
ZeRO-3 配置文件 (deepspeed_zero3.yaml):
compute_environment: LOCAL_MACHINE
distributed_type: DEEPSPEED
num_processes: 4
machine_rank: 0
num_machines: 1
gpu_ids: all
mixed_precision: fp16
deepspeed_config:
  gradient_accumulation_steps: 4
  gradient_clipping: 1.0
  offload_optimizer_device: cpu  # 优化器状态卸载到CPU
  offload_param_device: cpu      # 参数卸载到CPU
  zero3_init_flag: true
  zero_stage: 3  # ZeRO-3
启动训练:
# ZeRO-2
accelerate launch --config_file deepspeed_zero2.yaml train_script.py

# ZeRO-3
accelerate launch --config_file deepspeed_zero3.yaml train_script.py
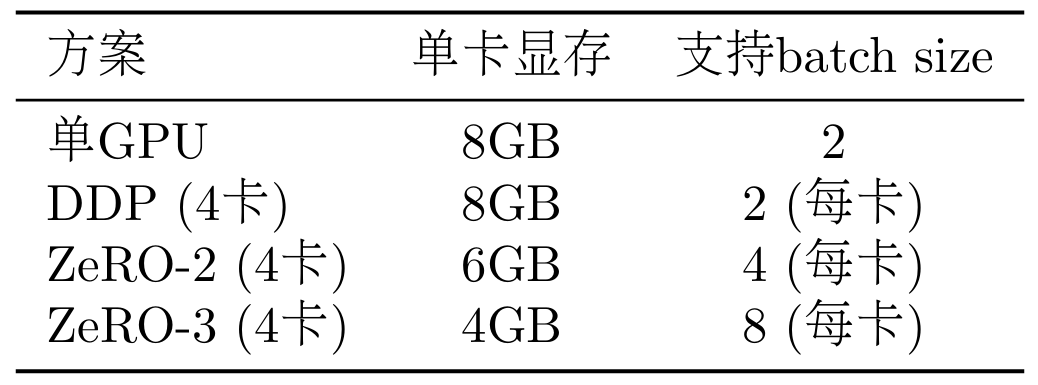
如表 11.9 所示,这是 Qwen3-0.6B 模型用不同方式训练的显存对比:
表 11.9 显存对比 (Qwen3-0.6B 模型)
(4)多节点训练
对于超大规模训练,可以使用多个节点(机器)。
主节点配置 (multi_node_main.yaml):
compute_environment: LOCAL_MACHINE
distributed_type: DEEPSPEED
num_processes: 16  # 4节点 x 4GPU
machine_rank: 0    # 主节点
num_machines: 4
main_process_ip: 192.168.1.100  # 主节点IP
main_process_port: 29500
gpu_ids: all
mixed_precision: fp16
deepspeed_config:
  zero_stage: 3
  offload_optimizer_device: cpu
  offload_param_device: cpu
工作节点配置 (修改machine_rank为 1, 2, 3):
machine_rank: 1  # 工作节点1
# 其他配置相同
启动训练:
# 在主节点上
accelerate launch --config_file multi_node_main.yaml train_script.py

# 在工作节点1上
accelerate launch --config_file multi_node_worker1.yaml train_script.py

# 在工作节点2上
accelerate launch --config_file multi_node_worker2.yaml train_script.py

# 在工作节点3上
accelerate launch --config_file multi_node_worker3.yaml train_script.py
(5)分布式训练最佳实践
1. Batch Size 调整
分布式训练时,总 batch size = per_device_batch_size × num_gpus × gradient_accumulation_steps
# 单GPU: batch_size=4, gradient_accumulation=4, 总batch=16
# 4GPU DDP: batch_size=4, gradient_accumulation=1, 总batch=16 (保持一致)
2. 学习率缩放
使用线性缩放规则: lr_new = lr_base × sqrt(total_batch_size_new / total_batch_size_base)
# 基准: 单GPU, batch=16, lr=5e-5
# 4GPU: batch=64, lr=5e-5 × sqrt(64/16) = 1e-4
3. 监控和调试
# 启用详细日志
export ACCELERATE_LOG_LEVEL=INFO

# 启用NCCL调试(多节点)
export NCCL_DEBUG=INFO

# 检查GPU利用率
watch -n 1 nvidia-smi
11.6.4 生产部署
训练完成后,我们需要将模型部署到生产环境。下面是一些部署建议。
(1)模型导出
将 LoRA 权重合并到基础模型,方便部署:
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import PeftModel

# 加载基础模型
base_model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen3-0.6B")

# 加载LoRA权重
model = PeftModel.from_pretrained(base_model, "./models/grpo_model")

# 合并权重
merged_model = model.merge_and_unload()

# 保存合并后的模型
merged_model.save_pretrained("./models/merged_model")

# 保存tokenizer
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-0.6B")
tokenizer.save_pretrained("./models/merged_model")

print("✓ 模型已导出到: ./models/merged_model")
(2)推理优化
使用量化和优化技术加速推理:
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

# 加载模型(使用8-bit量化)
model = AutoModelForCausalLM.from_pretrained(
    "./models/merged_model",
    load_in_8bit=True,  # 8-bit量化
    device_map="auto",  # 自动分配设备
)

tokenizer = AutoTokenizer.from_pretrained("./models/merged_model")

# 推理
def generate_answer(question):
    prompt = f"<|im_start|>user\n{question}<|im_end|>\n<|im_start|>assistant\n"
    inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

    outputs = model.generate(
        **inputs,
        max_new_tokens=512,
        temperature=0.7,
        do_sample=True,
    )

    response = tokenizer.decode(outputs[0], skip_special_tokens=False)
    return response

# 测试
question = "What is 48 + 24?"
answer = generate_answer(question)
print(answer)
(3)API 服务
使用 FastAPI 创建推理服务:
from fastapi import FastAPI
from pydantic import BaseModel
from transformers import AutoModelForCausalLM, AutoTokenizer

app = FastAPI()

# 加载模型
model = AutoModelForCausalLM.from_pretrained("./models/merged_model")
tokenizer = AutoTokenizer.from_pretrained("./models/merged_model")

class Question(BaseModel):
    text: str
    max_tokens: int = 512

class Answer(BaseModel):
    text: str
    confidence: float

@app.post("/generate", response_model=Answer)
def generate(question: Question):
    """生成答案"""
    prompt = f"<|im_start|>user\n{question.text}<|im_end|>\n<|im_start|>assistant\n"
    inputs = tokenizer(prompt, return_tensors="pt")

    outputs = model.generate(
        **inputs,
        max_new_tokens=question.max_tokens,
        temperature=0.7,
        return_dict_in_generate=True,
        output_scores=True,
    )

    response = tokenizer.decode(outputs.sequences[0], skip_special_tokens=False)

    # 计算置信度(简化版)
    confidence = 0.8  # 实际应该基于输出概率计算

    return Answer(text=response, confidence=confidence)

# 运行: uvicorn api:app --host 0.0.0.0 --port 8000