在前面的章节中,我们实现了多种智能体范式和通信协议。不过智能体处理更复杂的任务时表现不佳,自然会有疑问:如何让智能体具备更强的推理能力?如何让智能体学会更好地使用工具?如何让智能体能够自我改进?
这正是 Agentic RL(基于强化学习的智能体训练)要解决的核心问题。本章将为 HelloAgents 框架引入强化学习训练能力,让你能够训练出具备推理、工具使用等高级能力的智能体。我们将从 LLM 训练的基础知识开始,逐步深入到监督微调(Supervised Fine-Tuning,SFT)、群组相对策略优化(Group Relative Policy Optimization, GRPO)等实用技术,最终构建一个完整的智能体训练 pipeline。
11.1.1 从强化学习到 Agentic RL
在第二章的 2.4.2 节中,我们介绍了基于强化学习的智能体。强化学习(Reinforcement Learning, RL)是一种专注于解决序贯决策问题的学习范式,它通过智能体与环境的直接交互,在"试错"中学习如何最大化长期收益。
现在,让我们将这个框架应用到 LLM 智能体上。考虑一个数学问题求解智能体,它需要回答这样的问题:
问题: Janet's ducks lay 16 eggs per day. She eats three for breakfast
every morning and bakes muffins for her friends every day with four.
She sells the remainder at the farmers' market daily for $2 per fresh
duck egg. How much in dollars does she make every day at the farmers' market?
这个问题需要多步推理:首先计算 Janet 每天剩余的鸡蛋数量(16 - 3 - 4 = 9),然后计算她的收入(9 × 2 = 18)。我们可以将这个任务映射到强化学习框架:
- 智能体:基于 LLM 的推理系统
- 环境:数学问题和验证系统
- 状态:当前的问题描述和已有的推理步骤
- 行动:生成下一步推理或最终答案
- 奖励:答案是否正确(正确+1,错误 0)
传统的监督学习方法存在三个核心局限:一是数据质量完全决定训练质量,模型只能模仿训练数据,难以超越;二是缺乏探索能力,只能被动学习人类提供的路径;三是难以优化长期目标,无法精确优化多步推理的中间过程。
强化学习提供了新的可能性。通过让智能体自主生成多个候选答案并根据正确性获得奖励,它可以学习哪些推理路径更优、哪些步骤是关键,甚至发现比人类标注更好的解题方法[8]。这就是 Agentic RL 的核心思想:将 LLM 作为可学习策略,嵌入智能体的感知-决策-执行循环,通过强化学习优化多步任务表现。
11.1.2 LLM 训练全景图
在深入 Agentic RL 之前,我们需要先理解 LLM 训练的完整流程。一个强大的 LLM(如 GPT、Claude、Qwen)的诞生,通常要经历两个主要阶段:预训练(Pretraining)和后训练(Post-training)。如图 11.1 所示,这两个阶段构成了 LLM 从"语言模型"到"对话助手"的完整演化路径。
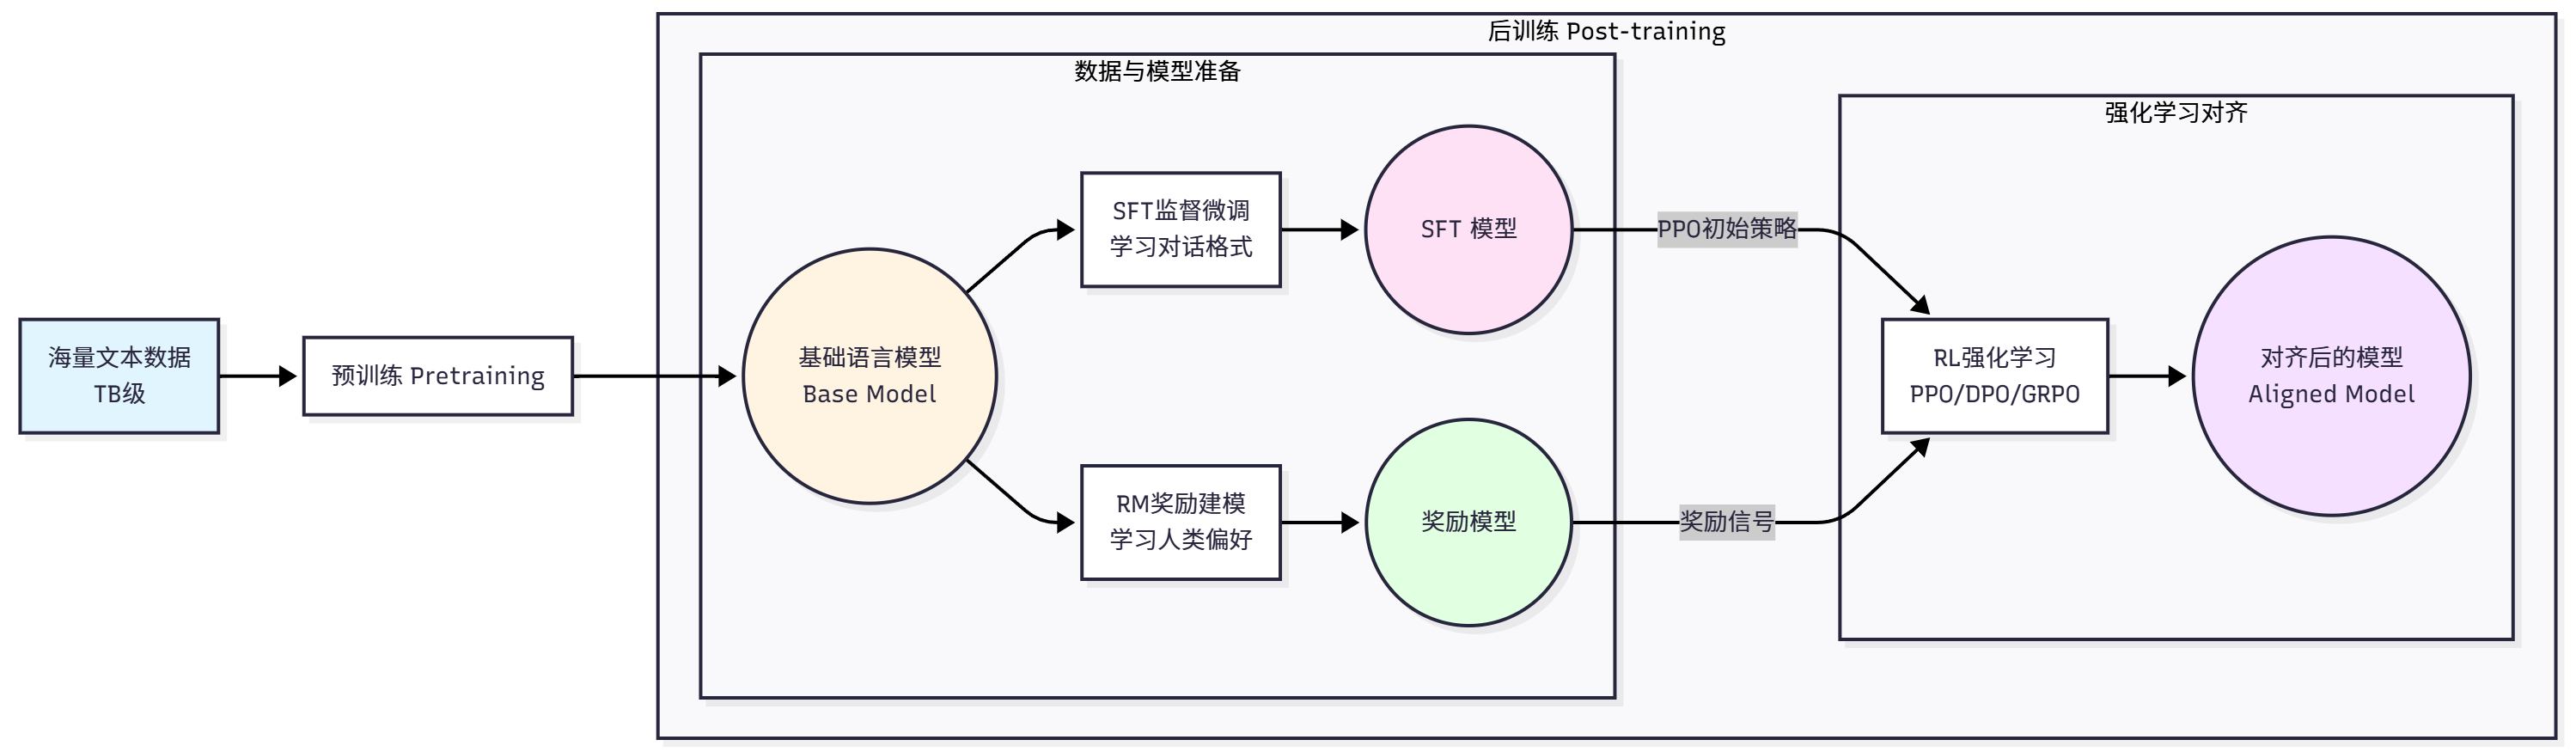
图 11.1 LLM 训练全景图
预训练阶段是 LLM 训练的第一阶段,目标是让模型学习语言的基本规律和世界知识。这个阶段使用海量的文本数据(通常是数 TB 级别),通过自监督学习的方式训练模型:训练信号来自文本本身,例如根据上文预测下一个词。最常见的预训练任务是因果语言建模(Causal Language Modeling),也称为下一个词预测(Next Token Prediction)。
给定一个文本序列 ,模型需要预测下一个词 :
其中 是模型参数, 是模型预测的下一个词的概率分布,目标是最小化负对数似然,即最大化预测正确词的概率。例如,给定文本"The cat sat on the",模型需要预测下一个词最可能是"mat"。通过在海量文本上进行这样的训练,模型逐渐学会语法规则(什么样的词序是合法的)、语义知识(词与词之间的关系)、世界知识(关于世界的事实性信息)以及基础的推理能力。
预训练阶段的特点是数据量巨大、计算成本高,学到的是通用的语言理解和生成能力,训练过程通常采用从未标注文本中自动构造监督信号的自监督目标。
后训练阶段则是要解决预训练模型的不足。预训练后的模型虽然具备了强大的语言能力,但它只是一个"预测下一个词"的模型,并不知道如何遵循人类的指令、生成有帮助无害诚实的回答、拒绝不当的请求,以及以对话的方式与人交互。后训练阶段就是要解决这些问题,让模型对齐人类的偏好和价值观。
后训练通常包含三个步骤。第一步是监督微调(SFT)[15],目标是让模型学会遵循指令和对话格式。训练数据是(prompt, completion)对,训练目标与预训练类似,仍然是最大化正确输出的概率:
其中 是输入提示(prompt), 是期望的输出, 是训练样本数量。SFT 的特点是数据量较小、需要人工标注、快速见效、主要学习任务格式和基本能力。
第二步是奖励建模(RM)。SFT 后的模型虽然能遵循指令,但生成的回答质量参差不齐。我们需要一种方式来评估回答的质量,这就是奖励模型的作用[13,14]。奖励模型的训练数据是偏好对比数据,包含同一个问题的两个回答,一个更好(chosen),一个更差(rejected)。奖励模型的训练目标是学习人类的偏好:
其中 是奖励模型,输入是(提示,回答)对,输出是质量分数; 是更好的回答(chosen), 是更差的回答(rejected), 是 sigmoid 函数,目标是让奖励模型给更好的回答更高的分数。
第三步是强化学习微调。有了奖励模型后,我们就可以用强化学习来优化语言模型,让它生成更高质量的回答。最经典的算法是 PPO(Proximal Policy Optimization)[1],训练目标是:
其中 是当前策略,即语言模型, 是参考策略,这个场景下可以是 SFT 模型, 是奖励模型的评分, 是 KL 散度,目的是为了防止模型偏离太远, 是平衡系数。这个目标函数的含义是:最大化奖励,同时不要偏离原始模型太远。
传统的 RLHF(Reinforcement Learning from Human Feedback)[5]需要大量人工标注偏好数据,成本高昂。为了降低成本,研究者提出了 RLAIF(Reinforcement Learning from AI Feedback)[7],用强大的 AI 模型(如 GPT-4)来替代人类标注员。RLAIF 的工作流程是:用 SFT 模型生成多个候选回答,用强大的 AI 模型对回答进行评分和排序,用 AI 的评分训练奖励模型,用奖励模型进行强化学习。实验表明,RLAIF 的效果接近甚至超过 RLHF,同时成本大幅降低[11]。
11.1.3 Agentic RL 的核心理念
在理解了 LLM 的基础训练流程后,让我们来看看 Agentic RL 与传统训练方法的区别。传统的后训练(我们称之为 PBRFT: Preference-Based Reinforcement Fine-Tuning)主要关注单轮对话的质量优化:给定一个用户问题,模型生成一个回答,然后根据回答的质量获得奖励。这种方式适合优化对话助手,但对于需要多步推理、工具使用、长期规划的智能体任务来说,就显得力不从心了。
Agentic RL则是一种新的范式,它将 LLM 视为一个可学习的策略,嵌入在一个顺序决策循环中。在这个框架下,智能体需要在动态环境中与外部世界交互,执行多步行动来完成复杂任务,获得中间反馈来指导后续决策,优化长期累积奖励而非单步奖励。
让我们通过一个具体例子来理解这个区别。在 PBRFT 场景中,用户问"请解释什么是强化学习",模型生成完整回答,然后根据回答质量直接给分。而在 Agentic RL 场景中,用户请求"帮我分析这个 GitHub 仓库的代码质量",智能体需要经历多个步骤:首先调用 GitHub API 获取仓库信息,成功获得仓库结构和文件列表,得到+0.1 的奖励;然后读取主要代码文件,成功获得代码内容,得到+0.1 的奖励;接着分析代码质量合理,得到+0.2 的奖励;最后生成分析报告质量高,得到+0.6 的奖励。总奖励是所有步骤的累积:1.0。
可以看到,Agentic RL 的关键特征是多步交互、每一步的行动都会改变环境状态、每一步都可以获得反馈、优化整个任务的完成质量。
强化学习常用马尔可夫决策过程(Markov Decision Process,MDP)框架进行形式化。MDP 由五元组 定义:状态空间 、行动空间 、状态转移函数 、奖励函数 和折扣因子 。下表从 MDP 角度对比 PBRFT 和 Agentic RL。
表 11.1 PBRFT 与 Agentic RL 对比
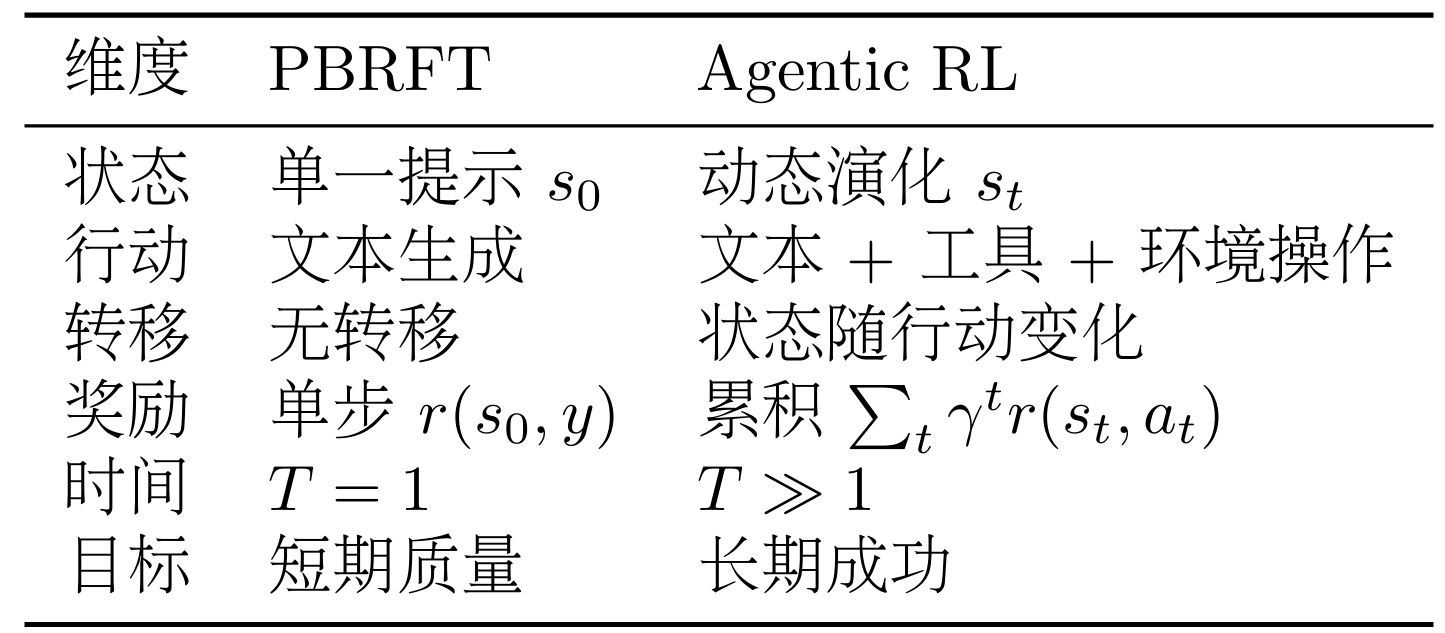
在状态方面,PBRFT 的状态 仅由用户提示构成,时间跨度 (单步),状态不变化,可以表示为 。而 Agentic RL 的状态 包含历史观察和上下文,时间跨度 (多步),状态随行动演化,可以表示为 ,其中 是第 步的观察(如工具返回结果、环境反馈等)。
在行动方面,PBRFT 的行动空间只有文本生成,单一行动类型,表示为 。而 Agentic RL 的行动空间包含文本生成、工具调用、环境操作等多种类型,表示为 ,例如 是生成思考过程或回答, 是调用计算器、搜索引擎等工具。
在转移函数方面,PBRFT 无状态转移,表示为 。而 Agentic RL 的状态根据行动和环境动态变化,表示为 ,例如调用搜索工具后,状态会包含搜索结果。
在奖励方面,PBRFT 只有单步奖励 ,仅在任务结束时给予,表示为 ,通常由奖励模型给出: 。而 Agentic RL 有多步奖励 ,可以在中间步骤给予部分奖励,表示为:
其中 是折扣因子, 可以是稀疏奖励(只在任务完成时给予,如答案正确 +1)、密集奖励(每步都给予,如工具调用成功 +0.1)或结合两者的混合奖励。
在目标函数方面,PBRFT 最大化单步期望奖励:
而 Agentic RL 最大化累积折扣奖励:
其中 是完整的轨迹(trajectory)。
这种转变不仅仅是技术细节的差异,而是思维方式的根本转变。PBRFT 思维关注"如何让模型生成更好的单个回答",优化回答质量,关注语言表达,进行单步决策。而 Agentic RL 思维关注"如何让智能体完成复杂任务",优化任务完成度,关注行动策略,进行多步规划。这种转变使得 LLM 从"对话助手"进化为"自主智能体",能够主动寻找信息、知道何时、如何使用外部工具、为了最终目标,愿意执行看似"绕路"的中间步骤、从错误学习。
Agentic RL 的目标是赋予 LLM 智能体六大核心能力,如图 11.2 所示。
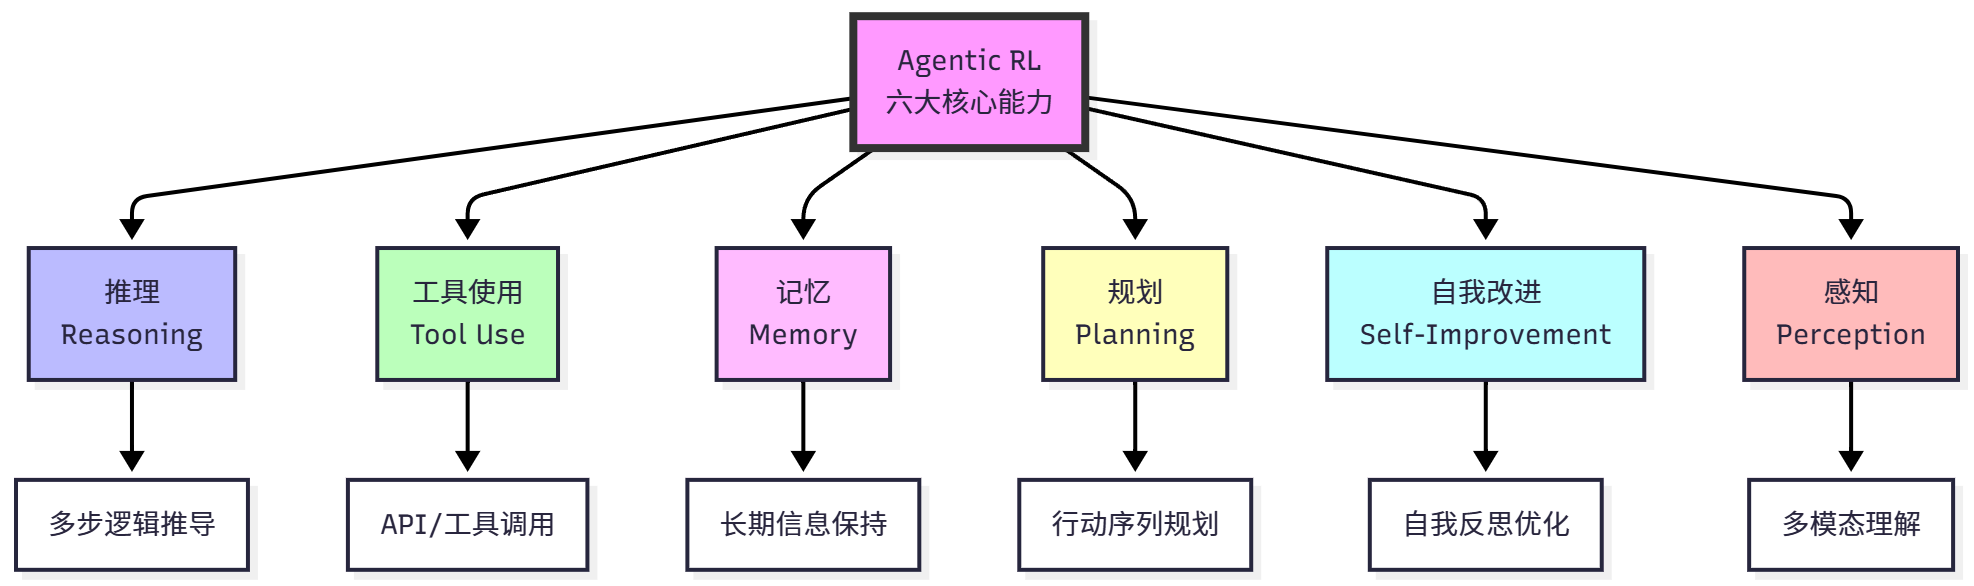
图 11.2 Agentic RL 的六大核心能力
推理(Reasoning)是指从给定信息中逻辑地得出结论的过程,是智能体的核心能力。传统的 CoT 提示方法依赖少样本示例,泛化能力有限;SFT 只能模仿训练数据中的推理模式,难以创新。强化学习的优势在于通过试错学习有效的推理策略,发现训练数据中没有的推理路径,学会何时需要深度思考、何时可以快速回答。推理任务可以建模为序列决策问题,给定问题 ,智能体需要生成推理链 和最终答案 。奖励函数通常设计为 if else ,训练目标是 。通过这种方式,模型学会生成高质量的推理链,而不仅仅是记忆答案。
工具使用(Tool Use)是指智能体调用外部工具来完成任务的能力。在工具使用任务中,行动空间扩展为 ,其中 是生成思考过程, 是调用工具。强化学习让智能体学会何时需要使用工具、选择哪个工具、如何组合多个工具。例如,在解决数学问题时,智能体需要学会何时使用计算器、何时使用代码解释器、何时直接推理。
记忆(Memory)是指智能体保持和重用过去信息的能力,对于长期任务至关重要。LLM 的上下文窗口有限,静态检索策略(如 RAG)无法针对任务优化。强化学习让智能体学会记忆管理策略:决定哪些信息值得记住、何时更新记忆、何时删除过时信息。这类似于人类的工作记忆,我们会主动管理大脑中的信息,保留重要的、遗忘无关的。
规划(Planning)是指制定行动序列以达成目标的能力。传统的 CoT 是线性思考,无法回溯;提示工程使用静态规划模板,难以适应新情况。强化学习让智能体学会动态规划:通过试错发现有效的行动序列,学会权衡短期和长期收益。例如,在多步任务中,智能体可能需要先执行一些看似"绕路"的步骤,例如收集信息,才能最终完成任务。
自我改进(Self-Improvement)是指智能体回顾自身输出、纠正错误并优化策略的能力。强化学习让智能体学会自我反思:识别自己的错误、分析失败原因、调整策略。这种能力使得智能体能够在没有人工干预的情况下持续改进,类似于人类的"从错误中学习"。
感知(Perception)是指理解多模态信息的能力。例如,强化学习可以提升视觉推理能力,让模型学会使用视觉工具,学会视觉规划。这使得智能体不仅能理解文本,还能理解和操作视觉世界。
11.1.4 HelloAgents 的 Agentic RL 设计
在理解了 Agentic RL 的核心理念后,让我们看看如何在 HelloAgents 框架中实现这些能力。
在技术选型上,我们集成了 TRL(Transformer Reinforcement Learning)框架[9],模型选择 Qwen3-0.6B[10]。TRL 是 Hugging Face 的强化学习库,成熟稳定、功能完整、易于集成。Qwen3-0.6B 是阿里云的小型语言模型,0.6B 参数适合普通 GPU 训练,性能优秀且开源免费。
HelloAgents 的 Agentic RL 模块采用四层架构设计,如图 11.3 所示。
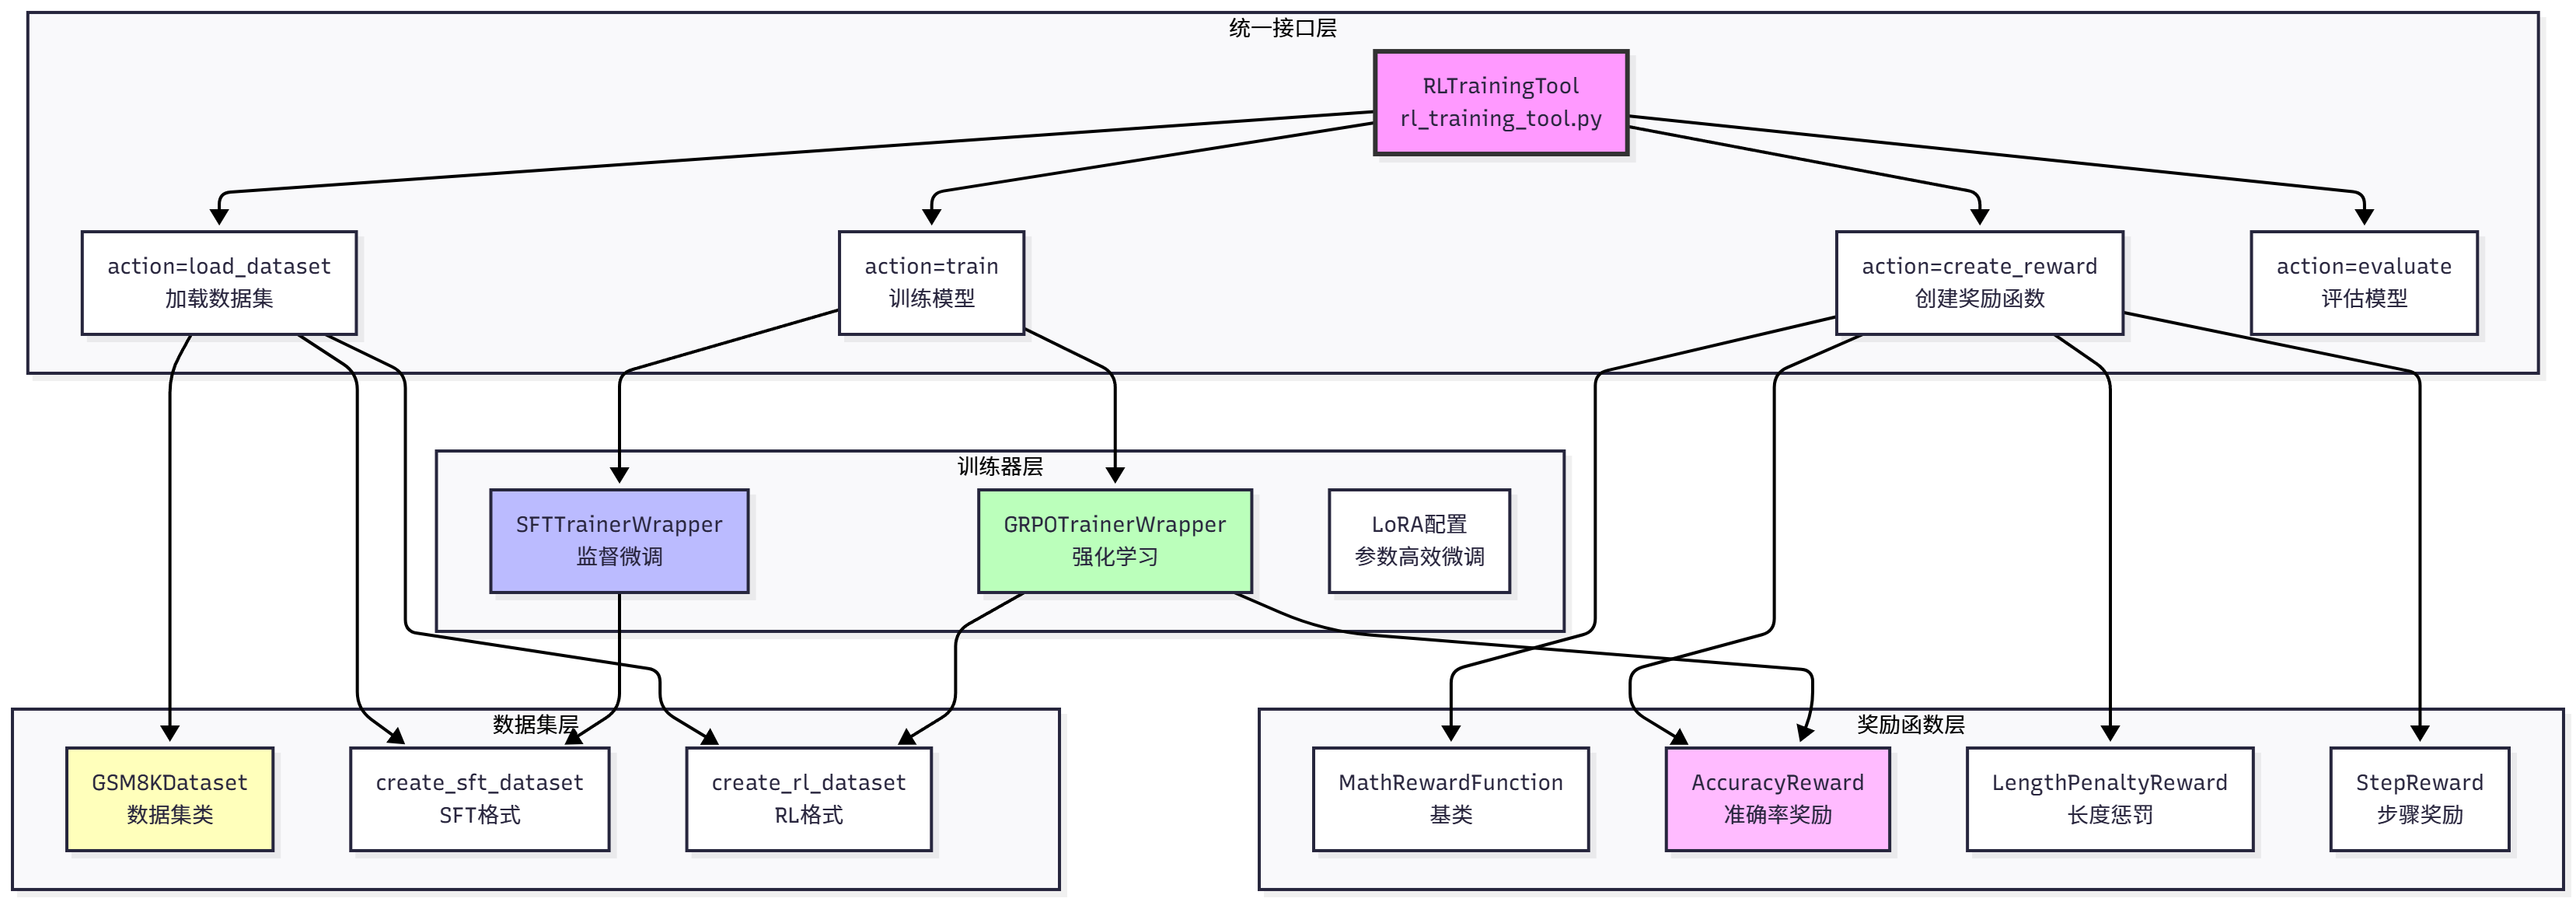
图 11.3 HelloAgents Agentic RL 架构
最底层是数据集层,包含GSM8KDataset类、create_sft_dataset()函数和create_rl_dataset()函数,负责数据加载和格式转换。第二层是奖励函数层,包含MathRewardFunction基类、AccuracyReward准确率奖励、LengthPenaltyReward长度惩罚、StepReward步骤奖励,以及便捷创建函数create_*_reward(),负责定义什么是好的行为。第三层是训练器层,包含SFTTrainerWrapper和GRPOTrainerWrapper,负责具体的训练逻辑和 LoRA 支持。最顶层是统一接口层,提供RLTrainingTool统一训练工具,支持四种操作:action="train"(训练模型)、action="load_dataset"(加载数据集)、action="create_reward"(创建奖励函数)、action="evaluate"(评估模型)。
11.1.5 快速上手示例
在深入学习之前,让我们先快速体验一下完整的训练流程。由于这一章的理论部分比较多,实战需要调试的地方也十分繁琐,因此不专注于构造工具而是学会应用。首先安装 HelloAgents 框架:
# 安装HelloAgents框架(第11章版本)
pip install "hello-agents[rl]==0.2.5"

# 或者从源码安装
cd HelloAgents
pip install -e ".[rl]"
然后运行快速训练示例:
import sys
import json

from hello_agents.tools import RLTrainingTool

# 创建RL训练工具
rl_tool = RLTrainingTool()

# 1. 快速测试:SFT训练(10个样本,1个epoch)
sft_result_str = rl_tool.run({
    "action": "train",
    "algorithm": "sft",
    "model_name": "Qwen/Qwen3-0.6B",
    "output_dir": "./models/quick_test_sft",
    "max_samples": 10,      # 只用10个样本快速测试
    "num_epochs": 1,        # 只训练1轮
    "batch_size": 2,
    "use_lora": True        # 使用LoRA加速训练
})

sft_result = json.loads(sft_result_str)
print(f"\n✓ SFT训练完成,模型保存在: {sft_result['output_dir']}")

# 2. GRPO训练(5个样本,1个epoch)
grpo_result_str = rl_tool.run({
    "action": "train",
    "algorithm": "grpo",
    "model_name": "Qwen/Qwen3-0.6B",  # 使用基础模型
    "output_dir": "./models/quick_test_grpo",
    "max_samples": 5,       # 只用5个样本快速测试
    "num_epochs": 1,
    "batch_size": 2,        # 必须能被num_generations(8)整除,使用2
    "use_lora": True
})

grpo_result = json.loads(grpo_result_str)
print(f"\n✓ GRPO训练完成,模型保存在: {grpo_result['output_dir']}")

# 3. 评估模型
eval_result_str = rl_tool.run({
    "action": "evaluate",
    "model_path": "./models/quick_test_grpo",
    "max_samples": 10,      # 在10个测试样本上评估
    "use_lora": True
})

eval_result = json.loads(eval_result_str)
print(f"\n✓ 评估完成:")
print(f"  - 准确率: {eval_result['accuracy']}")
print(f"  - 平均奖励: {eval_result['average_reward']}")
print(f"  - 测试样本数: {eval_result['num_samples']}")

print("\n" + "=" * 50)
print("🎉 恭喜!你已经完成了第一个Agentic RL模型的训练!")
print("=" * 50)
print(f"\n模型路径:")
print(f"  SFT模型: {sft_result['output_dir']}")
print(f"  GRPO模型: {grpo_result['output_dir']}")
这个快速示例展示了完整的训练流程:SFT 训练让模型学习基础的推理格式和对话模式,GRPO 训练通过强化学习优化推理策略提升准确率,模型评估在测试集上评估训练效果。另外跑完之后准确率很低是正常现象,因为现在模型只见过 0.7%的训练样本,并且只运行了一轮。