在经历了数年提示工程(Prompt Engineering)成为应用型AI的焦点之后,一个新的术语开始走到台前:上下文工程(Context Engineering)。如今,用语言模型构建系统不再只是找对提示词里的句式和措辞,而是要回答一个更宏观的问题:什么样的上下文配置,最有可能让模型产出我们期望的行为?
所谓“上下文”,是指在对大语言模型(LLM)进行采样时所包含的那组 tokens。手头的工程问题,是在 LLM 的固有约束之下,优化这些 tokens 的效用,以便稳定地得到预期结果。想要有效驾驭 LLM,往往需要“在上下文中思考”——也就是说:在任何一次调用时,都要审视 LLM 可见的整体状态,并预判这种状态可能诱发的行为。
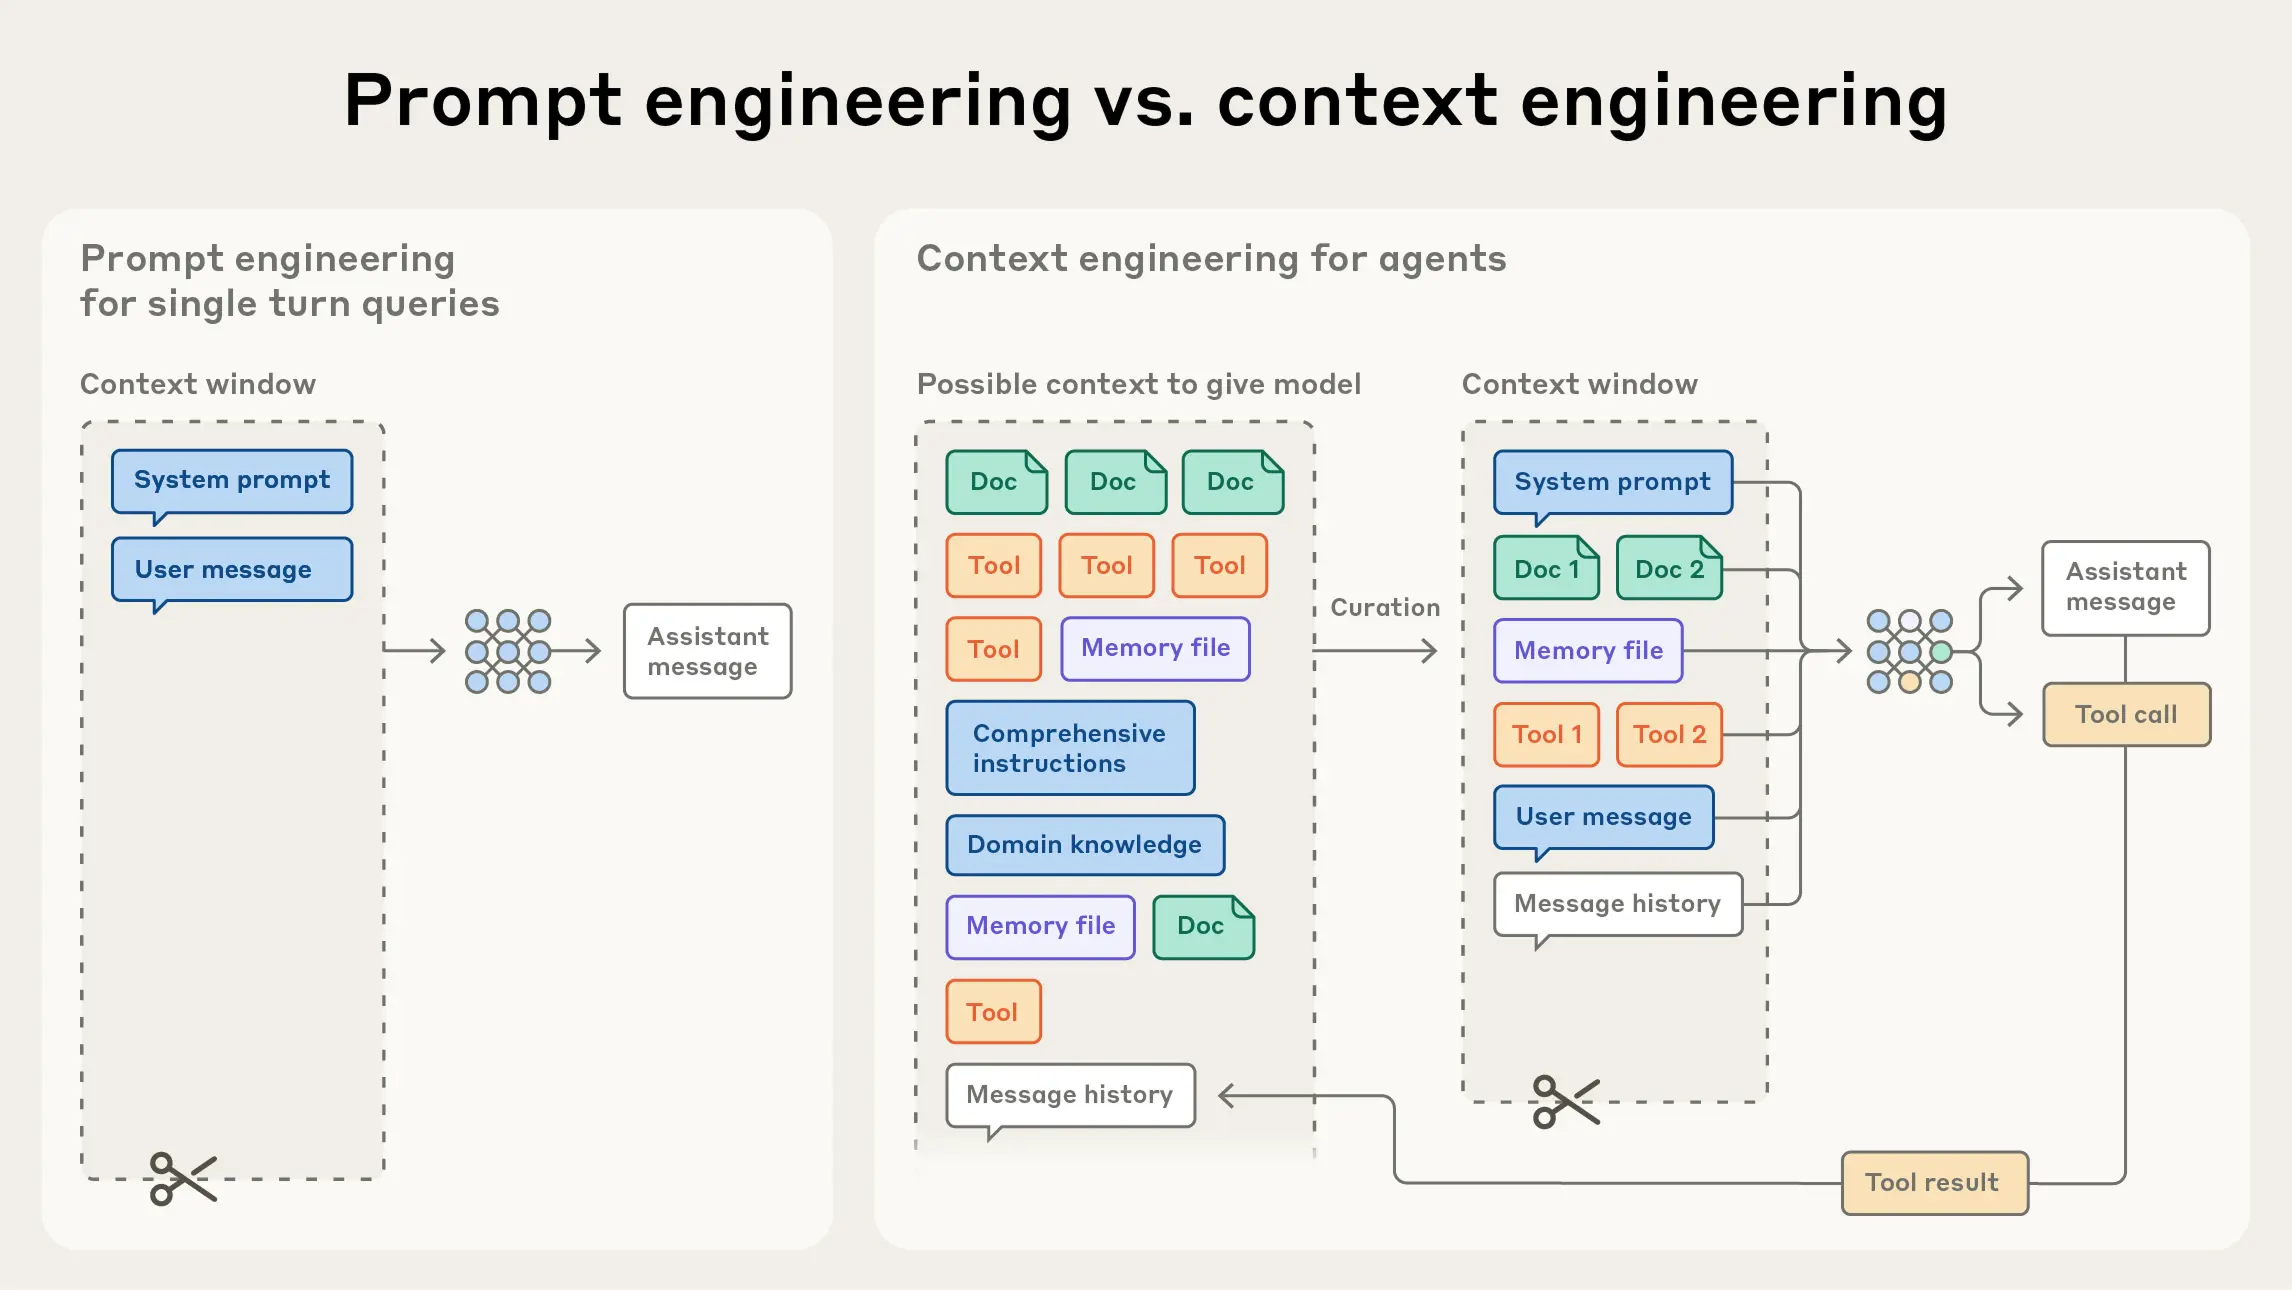
图 9.1 Prompt engineering vs Context engineering
本节将探讨正在兴起的上下文工程,并给出一个用于构建可调控、有效智能体的精炼心智模型。
上下文工程 vs. 提示工程
如图9.1所示,在现在前沿模型厂商的视角中,上下文工程是提示工程的自然演进。提示工程关注如何编写与组织 LLM 的指令以获得更优结果(例如系统提示的写法与结构化策略);而上下文工程则是在推理阶段,如何策划与维护“最优的信息集合(tokens)”,其中不仅包含提示本身,还包含其他会进入上下文窗口的一切信息。
在 LLM 工程的早期阶段,提示往往是主要工作,因为大多数用例(除日常聊天外)都需要针对单轮分类或文本生成做精调式的提示优化。顾名思义,提示工程的核心是“如何写出有效提示”,尤其是系统提示。然而,随着我们开始工程化地构建更强的智能体,它们在更长的时间范围内、跨多次推理轮次地工作,我们就需要能管理整个上下文状态的策略——其中包括系统指令、工具、MCP(Model Context Protocol)、外部数据、消息历史等。
一个循环运行的智能体,会不断产生下一轮推理可能相关的数据,这些信息必须被周期性地提炼。因此,上下文工程的“艺与术”,在于从持续扩张的“候选信息宇宙”中,甄别哪些内容应当进入有限的上下文窗口。