监督微调(Supervised Fine-Tuning, SFT)是强化学习训练的第一步,也是最重要的基础。SFT 让模型学习任务的基本格式、对话模式和初步的推理能力。没有 SFT 的基础,直接进行强化学习往往会失败,因为模型连基本的输出格式都不会。
11.3.1 为什么需要 SFT
在开始强化学习之前,我们需要先进行 SFT 训练。这是因为预训练模型虽然具备强大的语言能力,但它并不知道如何完成特定任务。预训练模型的训练目标是预测下一个词,而不是解决数学问题或使用工具。预训练模型的输出格式是自由文本,而我们需要结构化的输出(如"Step 1: ..., Step 2: ..., Final Answer: ...")。预训练模型没有见过任务相关的数据,不知道什么是"好的"推理过程。
SFT 的作用是教会模型任务的基本规则。首先,学习输出格式,让模型知道如何组织答案(如使用"Step 1", "Final Answer"等标记)。其次,学习推理模式,通过示例学习如何分解问题、逐步推导。再次,建立基线能力,为后续的强化学习提供一个合理的起点。最后,减少探索空间,强化学习不需要从零开始,可以在 SFT 的基础上优化。
让我们通过一个对比实验来理解 SFT 的重要性。假设我们直接用预训练模型解决 GSM8K 问题:
from transformers import AutoTokenizer, AutoModelForCausalLM

# 加载预训练模型
model_name = "Qwen/Qwen3-0.6B"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)

# 测试问题
question = """Natalia sold clips to 48 of her friends in April, and then she sold half as many clips in May. How many clips did Natalia sell altogether in April and May?"""

# 构造输入
prompt = f"<|im_start|>user\n{question}<|im_end|>\n<|im_start|>assistant\n"
inputs = tokenizer(prompt, return_tensors="pt")

# 生成回答
outputs = model.generate(**inputs, max_new_tokens=200)
response = tokenizer.decode(outputs[0], skip_special_tokens=False)

print("预训练模型的回答:")
print(response)
预训练模型的输出可能是:
<|im_start|>user
Natalia sold clips to 48 of her friends in April, and then she sold half as many clips in May. How many clips did Natalia sell altogether in April and May?<|im_end|>
<|im_start|>assistant
I can help you with that. Let me think about this problem. Natalia sold clips to her friends. In April she sold 48 clips. In May she sold half as many. So we need to find out how many she sold in May and then add them together. But I'm not sure how to calculate half of 48. Maybe I should use a calculator? Or maybe I can just estimate...
可以看到,预训练模型虽然理解了问题,但输出非常冗长、缺乏结构、没有明确的答案、推理过程混乱。这样的输出无法用于强化学习,因为我们无法提取答案、无法评估质量、无法提供有效的奖励信号。
现在让我们看看 SFT 后的模型:
# 加载SFT模型(假设已经训练好)
sft_model_path = "./models/sft_model"
sft_model = AutoModelForCausalLM.from_pretrained(sft_model_path)

# 使用相同的问题
outputs = sft_model.generate(**inputs, max_new_tokens=200)
response = tokenizer.decode(outputs[0], skip_special_tokens=False)

print("SFT模型的回答:")
print(response)
SFT 模型的输出:
<|im_start|>user
Natalia sold clips to 48 of her friends in April, and then she sold half as many clips in May. How many clips did Natalia sell altogether in April and May?<|im_end|>
<|im_start|>assistant
Let me solve this step by step.

Step 1: Calculate clips sold in May
Natalia sold half as many clips in May as in April.
Clips in May = 48 / 2 = 24

Step 2: Calculate total clips
Total = April + May = 48 + 24 = 72

Final Answer: 72<|im_end|>
可以看到,SFT 模型的输出结构清晰(使用"Step 1", "Step 2", "Final Answer"标记)、推理正确、答案明确、格式统一。这样的输出可以用于强化学习,因为我们可以提取答案、计算奖励、优化策略。
如图 11.6 所示,SFT 是从预训练模型到强化学习的桥梁。
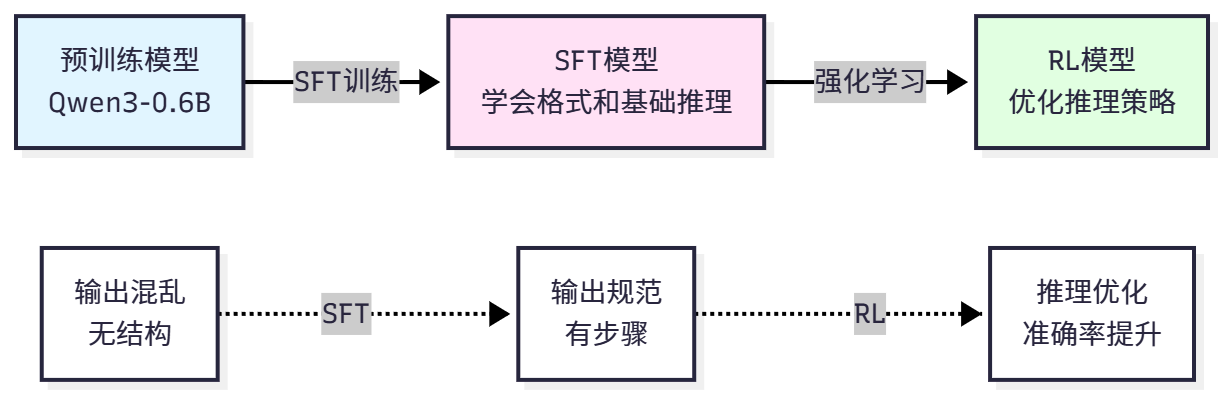
图 11.6 SFT 在训练流程中的作用
11.3.2 LoRA:参数高效微调
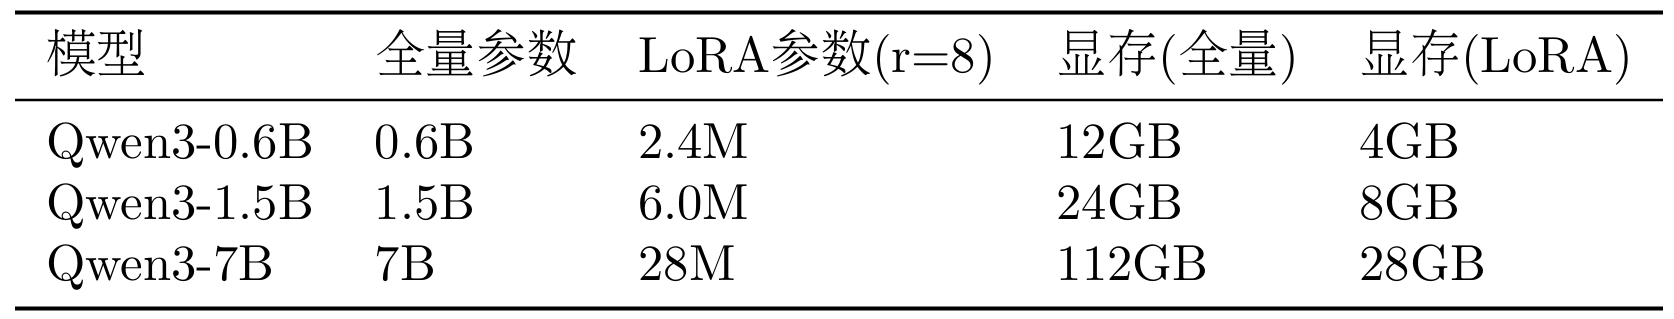
直接微调整个模型需要大量的计算资源和显存。对于 Qwen3-0.6B(0.6B 参数),全量微调需要约 12GB 显存(FP16)或 24GB 显存(FP32)。对于更大的模型(如 7B、13B),全量微调几乎不可能在消费级 GPU 上进行。
LoRA(Low-Rank Adaptation)[3]是一种参数高效微调方法,它只训练少量的额外参数,而保持原模型参数冻结。LoRA 的核心思想是:模型微调时的参数变化可以用低秩矩阵表示。
假设原模型的权重矩阵为 ,微调后的权重为 。LoRA 假设 可以分解为两个低秩矩阵的乘积:
其中 , , 是秩(rank)。
前向传播时,输出为:
原模型参数 保持冻结,只训练 和 。
参数量对比:原模型参数量为 ,LoRA 参数量为 。当 时,LoRA 参数量远小于原模型。例如,对于 的情况,原模型参数量为 ,LoRA 参数量为 ,参数量减少了 256 倍!
因此可以总结 LoRA 的优势:显存占用大幅降低、训练速度更快、易于部署、防止过拟合。不过训练的效果通常情况会比全量调参更差一些。
如表 11.5 所示,LoRA 在不同模型规模下的效果对比。
表 11.5 LoRA vs 全量微调对比
LoRA 的关键超参数包括:秩(rank,r),控制 LoRA 矩阵的秩,越大表达能力越强,但参数量也越多,典型值为 4-64,默认 8;Alpha(),LoRA 的缩放因子,实际更新为 ,控制 LoRA 的影响强度,典型值等于 rank;目标模块(target_modules),指定哪些层应用 LoRA,通常选择注意力层(q_proj, k_proj, v_proj, o_proj),也可以包括 MLP 层(gate_proj, up_proj, down_proj)。
11.3.3 SFT 训练实战
现在让我们使用 HelloAgents 进行 SFT 训练。完整的训练流程包括:准备数据集、配置 LoRA、设置训练参数、开始训练、保存模型。
基础训练示例:
from hello_agents.tools import RLTrainingTool

# 创建训练工具
rl_tool = RLTrainingTool()

# SFT训练
result = rl_tool.run({
    # 训练配置
    "action": "train",
    "algorithm": "sft",

    # 模型配置
    "model_name": "Qwen/Qwen3-0.6B",
    "output_dir": "./models/sft_model",

    # 数据配置
    "max_samples": 100,     # 使用100个样本快速测试

    # 训练参数
    "num_epochs": 3,        # 训练3轮
    "batch_size": 4,        # 批次大小
    "learning_rate": 5e-5,  # 学习率

    # LoRA配置
    "use_lora": True,       # 使用LoRA
    "lora_rank": 8,         # LoRA秩
    "lora_alpha": 16,       # LoRA alpha
})

print(f"\n✓ 训练完成!")
print(f"  - 模型保存路径: {result['model_path']}")
print(f"  - 训练样本数: {result['num_samples']}")
print(f"  - 训练轮数: {result['num_epochs']}")
print(f"  - 最终损失: {result['final_loss']:.4f}")
如果训练过程中损失逐渐下降,说明模型正在学习。
(1)训练参数详解
让我们详细了解各个训练参数的含义和调优建议。
数据参数:
max_samples: 使用的训练样本数量。快速测试时可以用 100-1000 个样本,完整训练建议使用全部数据(7473 个样本)。更多数据通常带来更好的效果,但训练时间也更长。split: 数据集划分,默认"train"。可以设置为"train[:1000]"只使用前 1000 个样本。
训练参数:
num_epochs: 训练轮数。1 轮表示遍历整个数据集一次。太少(1-2 轮)可能欠拟合,太多(>10 轮)可能过拟合。建议从 3 轮开始,观察损失曲线调整。batch_size: 每次更新使用的样本数。越大训练越稳定,但显存占用越高。建议根据显存调整:4GB 显存用 batch_size=1-2,8GB 显存用 batch_size=4-8,16GB 显存用 batch_size=8-16。learning_rate: 学习率,控制参数更新的步长。太小(1e-6)收敛慢,太大(1e-3)可能不收敛。SFT 推荐 5e-5,LoRA 可以稍大(1e-4)。
LoRA 参数:
use_lora: 是否使用 LoRA。建议始终开启,除非有充足的显存。lora_rank: LoRA 秩,控制表达能力。4-8 适合小任务,16-32 适合复杂任务,64 适合大规模微调。lora_alpha: LoRA 缩放因子,通常设置为 rank 的 2 倍。rank=8 时,alpha=16;rank=16 时,alpha=32。
优化器参数:
optimizer: 优化器类型,默认"adamw"。AdamW 是最常用的选择,也可以尝试"sgd"或"adafactor"等。weight_decay: 权重衰减,防止过拟合。默认 0.01,可以尝试 0.001-0.1。warmup_ratio: 学习率预热比例。前 warmup_ratio 的步数学习率线性增加,然后线性衰减。默认 0.1(前 10%步数预热)。
(2)完整训练示例
让我们进行一次完整的 SFT 训练,使用全部数据和最佳实践:
from hello_agents.tools import RLTrainingTool

rl_tool = RLTrainingTool()

# 完整SFT训练
result = rl_tool.run({
    "action": "train",
    "algorithm": "sft",

    # 模型配置
    "model_name": "Qwen/Qwen3-0.6B",
    "output_dir": "./models/sft_full",

    # 数据配置
    "max_samples": None,    # 使用全部数据(7473个样本)

    # 训练参数
    "num_epochs": 3,
    "batch_size": 8,
    "learning_rate": 5e-5,
    "warmup_ratio": 0.1,
    "weight_decay": 0.01,

    # LoRA配置
    "use_lora": True,
    "lora_rank": 16,        # 使用更大的rank
    "lora_alpha": 32,
    "lora_target_modules": ["q_proj", "k_proj", "v_proj", "o_proj"],

    # 其他配置
    "save_steps": 500,      # 每500步保存一次
    "logging_steps": 100,   # 每100步记录一次
    "eval_steps": 500,      # 每500步评估一次
})

print(f"训练完成! 模型保存在: {result['model_path']}")
这个配置适合在 8GB 显存的 GPU 上训练,预计耗时 30-60 分钟。
(3)训练监控和调试
在训练过程中,我们需要监控三个关键指标。损失(Loss)应该逐渐下降,如果不下降可能是学习率太小或数据有问题,如果下降后又上升则可能是学习率太大或出现过拟合。梯度范数(Gradient Norm)应该在 0.1-10 的合理范围内,过大(>100)说明出现梯度爆炸需要降低学习率,过小(<0.01)说明梯度消失需要检查模型配置。学习率(Learning Rate)应该按照 warmup 策略变化,前 10%步数线性增加,然后线性衰减到 0。
训练中常见的问题及解决方案:显存不足时可以减小 batch_size 或 max_length,使用梯度累积或更小的模型;训练速度慢时可以增大 batch_size,减少 logging 频率,或使用混合精度训练;损失不下降时可以增大学习率,检查数据格式,或增加训练轮数;过拟合时可以增大 weight_decay,减少训练轮数,或使用更多数据。
11.3.4 模型评估
训练完成后,我们需要评估模型的效果。评估指标包括:
-
准确率(Accuracy):答案完全正确的比例,最直接的指标,范围 0-1,越高越好。
-
平均奖励(Average Reward):所有样本的平均奖励,综合考虑准确率、长度、步骤等因素,范围取决于奖励函数设计。
-
推理质量(Reasoning Quality):推理过程的清晰度和逻辑性,需要人工评估或使用专门的评估模型。
使用 HelloAgents 评估模型:
from hello_agents.tools import RLTrainingTool

rl_tool = RLTrainingTool()

# 评估SFT模型
eval_result = rl_tool.run({
    "action": "evaluate",
    "model_path": "./models/sft_full",
    "max_samples": 100,     # 在100个测试样本上评估
    "use_lora": True,
})

eval_data = json.loads(eval_result)
print(f"\n评估结果:")
print(f"  - 准确率: {eval_data['accuracy']}")
print(f"  - 平均奖励: {eval_data['average_reward']}")
print(f"  - 测试样本数: {eval_data['num_samples']}")
对于 Qwen3-0.6B 这样的小模型,SFT 后在 GSM8K 上达到 40-50%的准确率是正常的。通过强化学习,我们可以进一步提升到 60-70%。
为了更好地理解 SFT 的效果,我们可以对比不同阶段的模型:
# 评估预训练模型(未经SFT)
base_result = rl_tool.run({
    "action": "evaluate",
    "model_path": "Qwen/Qwen3-0.6B",
    "max_samples": 100,
    "use_lora": False,
})
base_data = json.loads(base_result)

# 评估SFT模型
sft_result = rl_tool.run({
    "action": "evaluate",
    "model_path": "./models/sft_full",
    "max_samples": 100,
    "use_lora": True,
})
sft_data = json.loads(sft_result)

# 对比结果
print("模型对比:")
print(f"预训练模型准确率: {base_data['accuracy']}")
print(f"SFT模型准确率: {sft_data['accuracy']}"
在本节中,我们学习了 SFT 的重要性(学习格式、建立基线)、LoRA 原理(低秩分解、参数高效)、SFT 训练实战(参数配置、训练监控)、模型评估(准确率、对比分析)。