现在,让我们将 ContextBuilder、NoteTool 和 TerminalTool 整合起来,构建一个完整的长程智能体——代码库维护助手。这个助手能够:
- 探索和理解代码库结构
- 记录发现的问题和改进点
- 追踪长期的重构任务
- 在上下文窗口限制下保持连贯性
9.6.1 场景设定与需求分析
业务场景
假设我们正在维护一个中型 Python Web 应用,这个代码库包含约 50 个 Python 文件,使用 Flask 框架构建,涵盖数据模型、业务逻辑、API 接口等多个模块,同时存在一些技术债务需要逐步清理。在这样的场景下,我们需要一个智能助手来帮助我们探索代码库,理解项目结构、依赖关系和代码风格;识别代码中的问题,比如代码重复、复杂度过高、缺少测试等;追踪任务进度,记录待办事项、已完成工作和遇到的阻塞;并基于历史上下文提供连贯的重构建议。
挑战与解决方案
这个场景面临几个典型的长程任务挑战。首先是信息量超出上下文窗口的问题,整个代码库可能包含数万行代码,无法一次性放入上下文窗口,我们通过使用 TerminalTool 进行即时、按需的代码探索来解决这个问题,只在需要时查看具体文件。其次是跨会话的状态管理挑战,重构任务可能持续数天,需要跨多个会话保持进度,我们使用 NoteTool 记录阶段性进展、待办事项和关键决策来应对。最后是上下文质量与相关性的问题,每次对话需要回顾相关的历史信息,但不能被无关信息淹没,我们通过 ContextBuilder 智能筛选和组织上下文,确保高信号密度。
9.6.2 系统架构设计
我们的代码库维护助手采用三层架构,如图9.3所示:
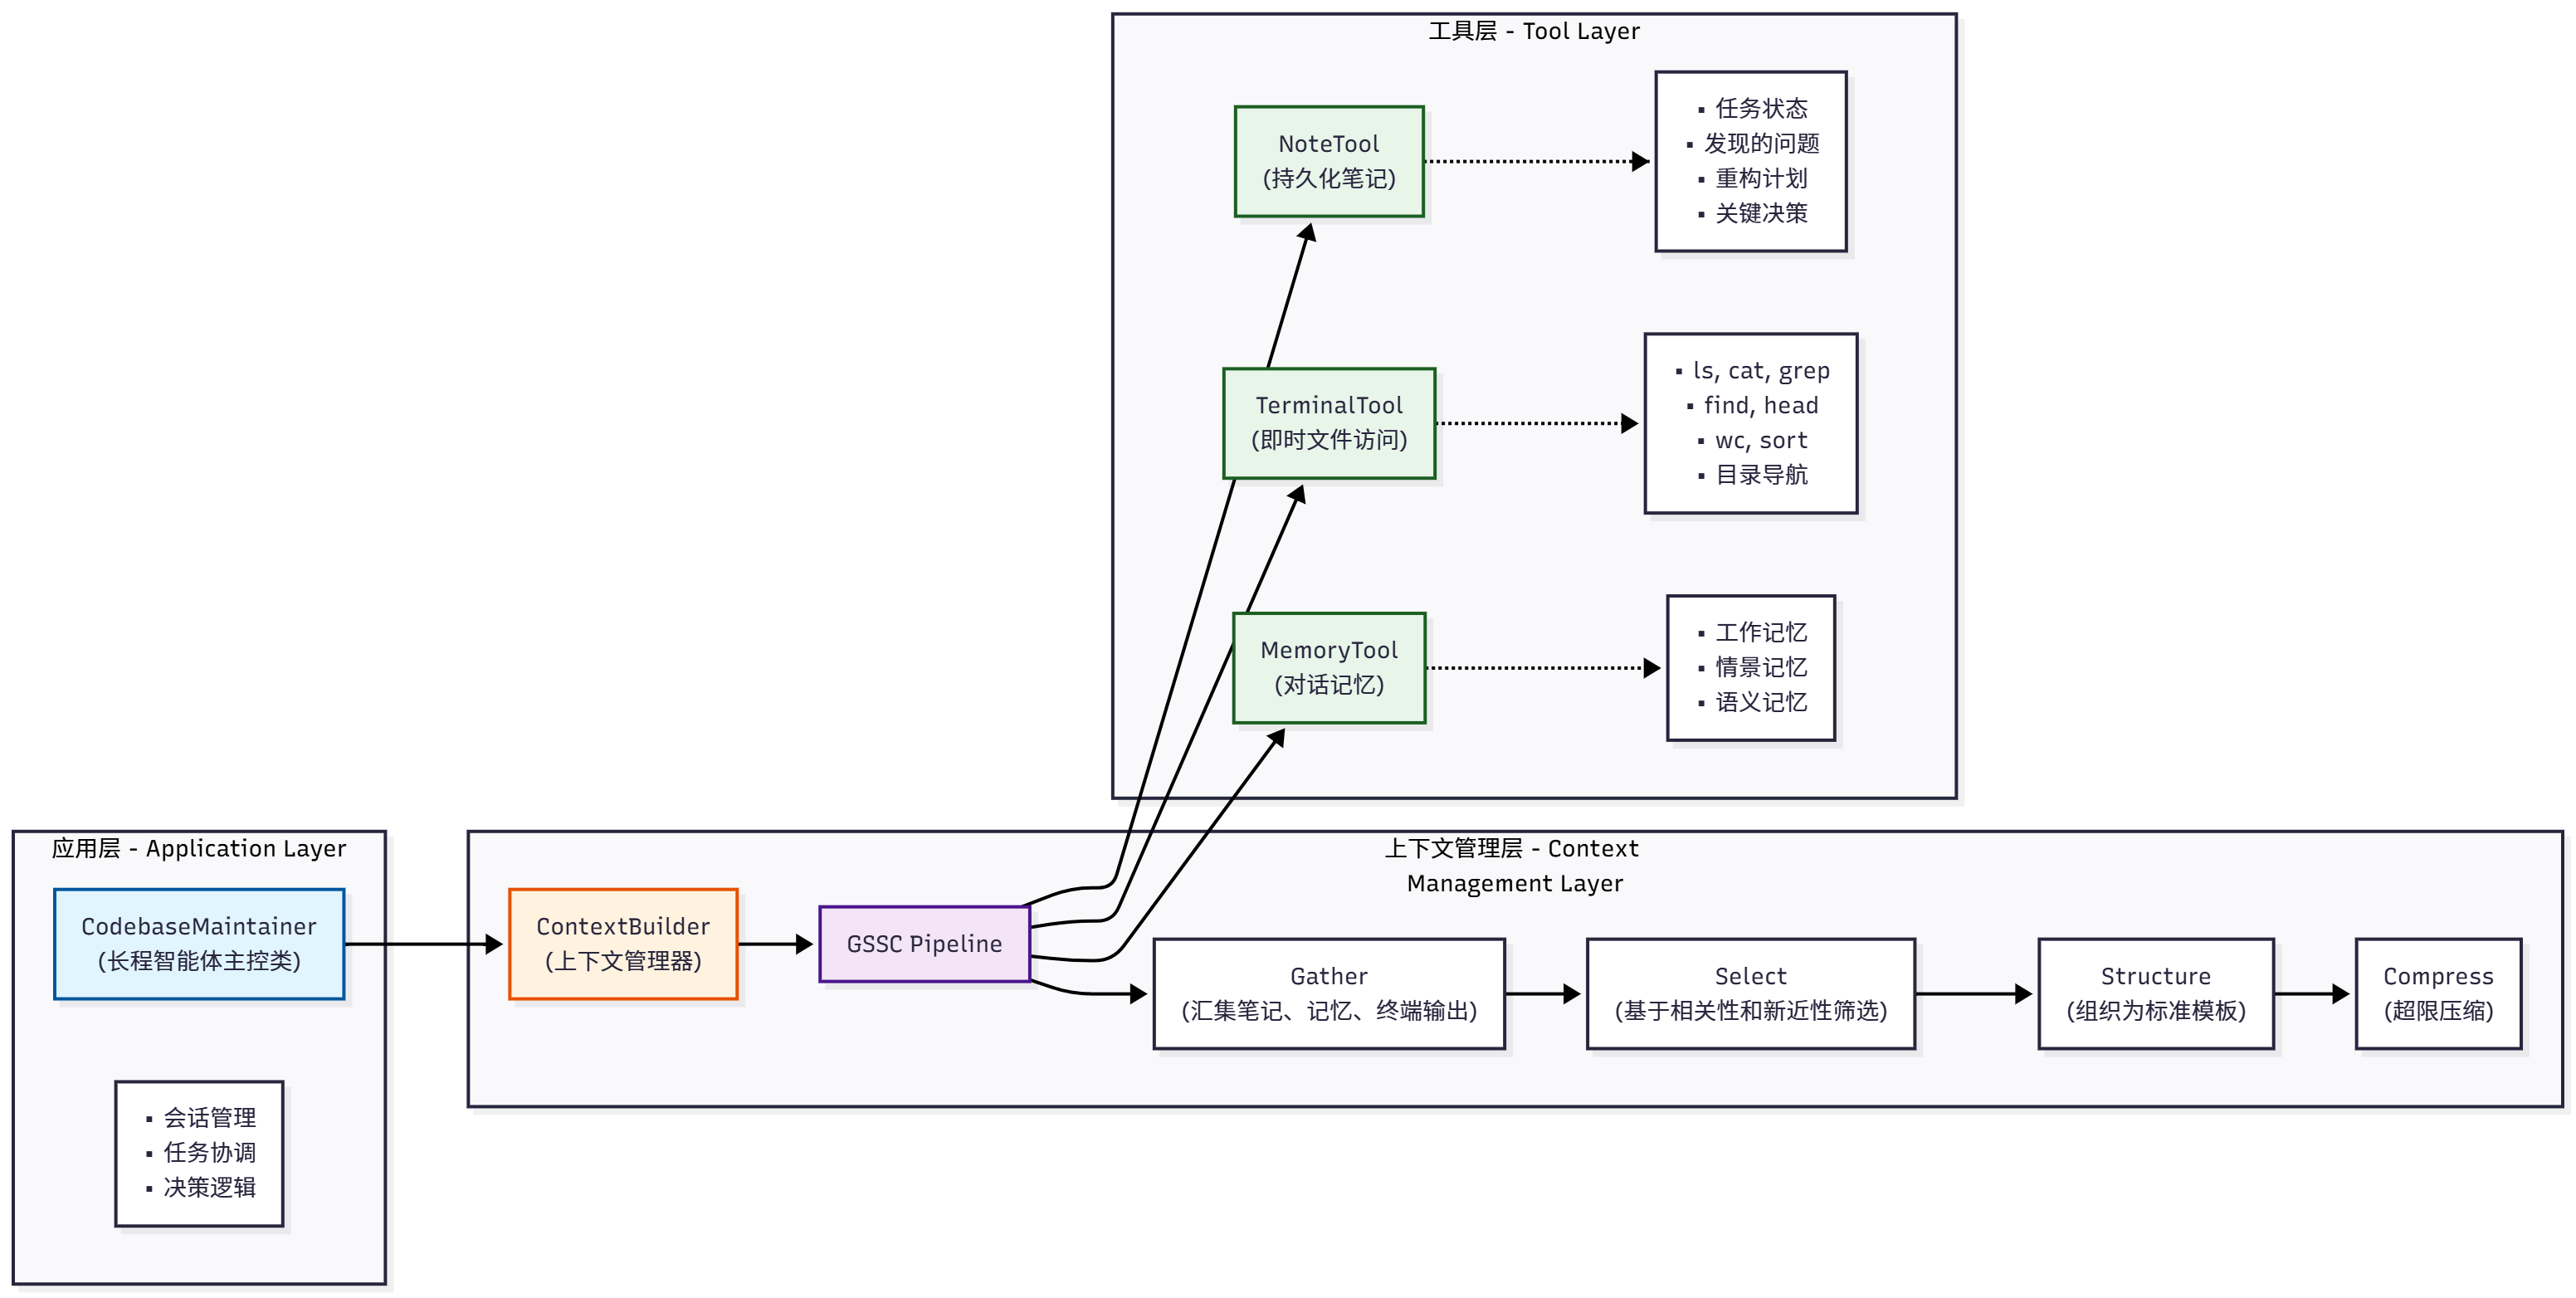
图 9.3 代码库维护助手三层架构
9.6.3 核心实现
现在让我们实现这个系统的核心类:
from typing import Dict, Any, List, Optional
from datetime import datetime
import json

from hello_agents import SimpleAgent, HelloAgentsLLM
from hello_agents.context import ContextBuilder, ContextConfig, ContextPacket
from hello_agents.tools import MemoryTool, NoteTool, TerminalTool
from hello_agents.core.message import Message


class CodebaseMaintainer:
    """代码库维护助手 - 长程智能体示例

    整合 ContextBuilder + NoteTool + TerminalTool + MemoryTool
    实现跨会话的代码库维护任务管理
    """

    def __init__(
        self,
        project_name: str,
        codebase_path: str,
        llm: Optional[HelloAgentsLLM] = None
    ):
        self.project_name = project_name
        self.codebase_path = codebase_path
        self.session_id = f"session_{datetime.now().strftime('%Y%m%d_%H%M%S')}"

        # 初始化 LLM
        self.llm = llm or HelloAgentsLLM()

        # 初始化工具
        self.memory_tool = MemoryTool(user_id=project_name)
        self.note_tool = NoteTool(workspace=f"./{project_name}_notes")
        self.terminal_tool = TerminalTool(workspace=codebase_path, timeout=60)

        # 初始化上下文构建器
        self.context_builder = ContextBuilder(
            memory_tool=self.memory_tool,
            rag_tool=None,  # 本案例不使用 RAG
            config=ContextConfig(
                max_tokens=4000,
                reserve_ratio=0.15,
                min_relevance=0.2,
                enable_compression=True
            )
        )

        # 对话历史
        self.conversation_history: List[Message] = []

        # 统计信息
        self.stats = {
            "session_start": datetime.now(),
            "commands_executed": 0,
            "notes_created": 0,
            "issues_found": 0
        }

        print(f"✅ 代码库维护助手已初始化: {project_name}")
        print(f"📁 工作目录: {codebase_path}")
        print(f"🆔 会话ID: {self.session_id}")

    def run(self, user_input: str, mode: str = "auto") -> str:
        """运行助手

        Args:
            user_input: 用户输入
            mode: 运行模式
                - "auto": 自动决策是否使用工具
                - "explore": 侧重代码探索
                - "analyze": 侧重问题分析
                - "plan": 侧重任务规划

        Returns:
            str: 助手的回答
        """
        print(f"\n{'='*80}")
        print(f"👤 用户: {user_input}")
        print(f"{'='*80}\n")

        # 第一步:根据模式执行预处理
        pre_context = self._preprocess_by_mode(user_input, mode)

        # 第二步:检索相关笔记
        relevant_notes = self._retrieve_relevant_notes(user_input)
        note_packets = self._notes_to_packets(relevant_notes)

        # 第三步:构建优化的上下文
        context = self.context_builder.build(
            user_query=user_input,
            conversation_history=self.conversation_history,
            system_instructions=self._build_system_instructions(mode),
            custom_packets=note_packets + pre_context
        )

        # 第四步:调用 LLM
        print("🤖 正在思考...")
        response = self.llm.invoke(context)

        # 第五步:后处理
        self._postprocess_response(user_input, response)

        # 第六步:更新对话历史
        self._update_history(user_input, response)

        print(f"\n🤖 助手: {response}\n")
        print(f"{'='*80}\n")

        return response

    def _preprocess_by_mode(
        self,
        user_input: str,
        mode: str
    ) -> List[ContextPacket]:
        """根据模式执行预处理,收集相关信息"""
        packets = []

        if mode == "explore" or mode == "auto":
            # 探索模式:自动查看项目结构
            print("🔍 探索代码库结构...")

            structure = self.terminal_tool.run({"command": "find . -type f -name '*.py' | head -n 20"})
            self.stats["commands_executed"] += 1

            packets.append(ContextPacket(
                content=f"[代码库结构]\n{structure}",
                timestamp=datetime.now(),
                token_count=len(structure) // 4,
                relevance_score=0.6,
                metadata={"type": "code_structure", "source": "terminal"}
            ))

        if mode == "analyze":
            # 分析模式:检查代码复杂度和问题
            print("📊 分析代码质量...")

            # 统计代码行数
            loc = self.terminal_tool.run({"command": "find . -name '*.py' -exec wc -l {} + | tail -n 1"})

            # 查找 TODO 和 FIXME
            todos = self.terminal_tool.run({"command": "grep -rn 'TODO\\|FIXME' --include='*.py' | head -n 10"})

            self.stats["commands_executed"] += 2

            packets.append(ContextPacket(
                content=f"[代码统计]\n{loc}\n\n[待办事项]\n{todos}",
                timestamp=datetime.now(),
                token_count=(len(loc) + len(todos)) // 4,
                relevance_score=0.7,
                metadata={"type": "code_analysis", "source": "terminal"}
            ))

        if mode == "plan":
            # 规划模式:加载最近的笔记
            print("📋 加载任务规划...")

            task_notes = self.note_tool.run({
                "action": "list",
                "note_type": "task_state",
                "limit": 3
            })

            if task_notes:
                content = "\n".join([f"- {note['title']}" for note in task_notes])
                packets.append(ContextPacket(
                    content=f"[当前任务]\n{content}",
                    timestamp=datetime.now(),
                    token_count=len(content) // 4,
                    relevance_score=0.8,
                    metadata={"type": "task_plan", "source": "notes"}
                ))

        return packets

    def _retrieve_relevant_notes(self, query: str, limit: int = 3) -> List[Dict]:
        """检索相关笔记"""
        try:
            # 优先检索 blocker
            blockers = self.note_tool.run({
                "action": "list",
                "note_type": "blocker",
                "limit": 2
            })

            # 搜索相关笔记
            search_results = self.note_tool.run({
                "action": "search",
                "query": query,
                "limit": limit
            })

            # 合并去重
            all_notes = {note.get('note_id') or note.get('id'): note for note in (blockers or []) + (search_results or [])}
            return list(all_notes.values())[:limit]

        except Exception as e:
            print(f"[WARNING] 笔记检索失败: {e}")
            return []

    def _notes_to_packets(self, notes: List[Dict]) -> List[ContextPacket]:
        """将笔记转换为上下文包"""
        packets = []

        for note in notes:
            # 根据笔记类型设置不同的相关性分数
            relevance_map = {
                "blocker": 0.9,
                "action": 0.8,
                "task_state": 0.75,
                "conclusion": 0.7
            }

            note_type = note.get('type', 'general')
            relevance = relevance_map.get(note_type, 0.6)

            content = f"[笔记:{note.get('title', 'Untitled')}]\n类型: {note_type}\n\n{note.get('content', '')}"

            packets.append(ContextPacket(
                content=content,
                timestamp=datetime.fromisoformat(note.get('updated_at', datetime.now().isoformat())),
                token_count=len(content) // 4,
                relevance_score=relevance,
                metadata={
                    "type": "note",
                    "note_type": note_type,
                    "note_id": note.get('note_id') or note.get('id')
                }
            ))

        return packets

    def _build_system_instructions(self, mode: str) -> str:
        """构建系统指令"""
        base_instructions = f"""你是 {self.project_name} 项目的代码库维护助手。

你的核心能力:
1. 使用 TerminalTool 探索代码库(ls, cat, grep, find等)
2. 使用 NoteTool 记录发现和任务
3. 基于历史笔记提供连贯的建议

当前会话ID: {self.session_id}
"""

        mode_specific = {
            "explore": """
当前模式: 探索代码库

你应该:
- 主动使用 terminal 命令了解代码结构
- 识别关键模块和文件
- 记录项目架构到笔记
""",
            "analyze": """
当前模式: 分析代码质量

你应该:
- 查找代码问题(重复、复杂度、TODO等)
- 评估代码质量
- 将发现的问题记录为 blocker 或 action 笔记
""",
            "plan": """
当前模式: 任务规划

你应该:
- 回顾历史笔记和任务
- 制定下一步行动计划
- 更新任务状态笔记
""",
            "auto": """
当前模式: 自动决策

你应该:
- 根据用户需求灵活选择策略
- 在需要时使用工具
- 保持回答的专业性和实用性
"""
        }

        return base_instructions + mode_specific.get(mode, mode_specific["auto"])

    def _postprocess_response(self, user_input: str, response: str):
        """后处理:分析回答,自动记录重要信息"""

        # 如果发现问题,自动创建 blocker 笔记
        if any(keyword in response.lower() for keyword in ["问题", "bug", "错误", "阻塞"]):
            try:
                self.note_tool.run({
                    "action": "create",
                    "title": f"发现问题: {user_input[:30]}...",
                    "content": f"## 用户输入\n{user_input}\n\n## 问题分析\n{response[:500]}...",
                    "note_type": "blocker",
                    "tags": [self.project_name, "auto_detected", self.session_id]
                })
                self.stats["notes_created"] += 1
                self.stats["issues_found"] += 1
                print("📝 已自动创建问题笔记")
            except Exception as e:
                print(f"[WARNING] 创建笔记失败: {e}")

        # 如果是任务规划,自动创建 action 笔记
        elif any(keyword in user_input.lower() for keyword in ["计划", "下一步", "任务", "todo"]):
            try:
                self.note_tool.run({
                    "action": "create",
                    "title": f"任务规划: {user_input[:30]}...",
                    "content": f"## 讨论\n{user_input}\n\n## 行动计划\n{response[:500]}...",
                    "note_type": "action",
                    "tags": [self.project_name, "planning", self.session_id]
                })
                self.stats["notes_created"] += 1
                print("📝 已自动创建行动计划笔记")
            except Exception as e:
                print(f"[WARNING] 创建笔记失败: {e}")

    def _update_history(self, user_input: str, response: str):
        """更新对话历史"""
        self.conversation_history.append(
            Message(content=user_input, role="user", timestamp=datetime.now())
        )
        self.conversation_history.append(
            Message(content=response, role="assistant", timestamp=datetime.now())
        )

        # 限制历史长度(保留最近10轮对话)
        if len(self.conversation_history) > 20:
            self.conversation_history = self.conversation_history[-20:]

    # === 便捷方法 ===

    def explore(self, target: str = ".") -> str:
        """探索代码库"""
        return self.run(f"请探索 {target} 的代码结构", mode="explore")

    def analyze(self, focus: str = "") -> str:
        """分析代码质量"""
        query = f"请分析代码质量" + (f",重点关注{focus}" if focus else "")
        return self.run(query, mode="analyze")

    def plan_next_steps(self) -> str:
        """规划下一步任务"""
        return self.run("根据当前进度,规划下一步任务", mode="plan")

    def execute_command(self, command: str) -> str:
        """执行终端命令"""
        result = self.terminal_tool.run({"command": command})
        self.stats["commands_executed"] += 1
        return result

    def create_note(
        self,
        title: str,
        content: str,
        note_type: str = "general",
        tags: List[str] = None
    ) -> str:
        """创建笔记"""
        result = self.note_tool.run({
            "action": "create",
            "title": title,
            "content": content,
            "note_type": note_type,
            "tags": tags or [self.project_name]
        })
        self.stats["notes_created"] += 1
        return result

    def get_stats(self) -> Dict[str, Any]:
        """获取统计信息"""
        duration = (datetime.now() - self.stats["session_start"]).total_seconds()

        # 获取笔记摘要
        try:
            note_summary = self.note_tool.run({"action": "summary"})
        except:
            note_summary = {}

        return {
            "session_info": {
                "session_id": self.session_id,
                "project": self.project_name,
                "duration_seconds": duration
            },
            "activity": {
                "commands_executed": self.stats["commands_executed"],
                "notes_created": self.stats["notes_created"],
                "issues_found": self.stats["issues_found"]
            },
            "notes": note_summary
        }

    def generate_report(self, save_to_file: bool = True) -> Dict[str, Any]:
        """生成会话报告"""
        report = self.get_stats()

        if save_to_file:
            report_file = f"maintainer_report_{self.session_id}.json"
            with open(report_file, 'w', encoding='utf-8') as f:
                json.dump(report, f, ensure_ascii=False, indent=2, default=str)
            report["report_file"] = report_file
            print(f"📄 报告已保存: {report_file}")

        return report
9.6.4 完整使用示例
现在让我们通过一个完整的使用场景,展示这个长程智能体的工作流程:
# ========== 初始化助手 ==========

from hello_agents import HelloAgentsLLM

maintainer = CodebaseMaintainer(
    project_name="my_flask_app",
    codebase_path="./my_flask_app",
    llm=HelloAgentsLLM()
)


# ========== 第一天:探索代码库 ==========
# 1. 初步探索
response = maintainer.explore()
"""
🔍 探索代码库结构...
🤖 正在思考...

🤖 助手: 我已经扫描了代码库,这是一个 Flask Web 应用,主要包含以下模块:

📁 项目结构:
- app/
  ├── models/      # 数据模型(User, Product, Order等)
  ├── routes/      # API路由
  ├── services/    # 业务逻辑
  └── utils/       # 工具函数
- tests/           # 测试文件
- migrations/      # 数据库迁移
- config.py        # 配置文件

总计约 3,500 行 Python 代码。

建议下一步:
1. 查看核心模型定义
2. 检查路由和API设计
3. 评估测试覆盖率
"""

# 2. 深入分析某个模块
response = maintainer.run("请分析 app/models/ 目录下的数据模型设计")
"""
🤖 助手: 我查看了 app/models/ 目录,发现以下数据模型:

1. User (user.py)
   - 字段: id, username, email, password_hash, created_at
   - 关系: 一对多 Order
   - 问题: ⚠️ 缺少索引,email 字段未设置唯一约束

2. Product (product.py)
   - 字段: id, name, description, price, stock
   - 问题: ✅ 设计合理

3. Order (order.py)
   - 字段: id, user_id, product_id, quantity, status
   - 问题: ⚠️ 缺少创建时间字段,不利于数据分析

建议:
1. 为 User.email 添加唯一约束
2. 为 Order 添加 created_at 和 updated_at 字段
3. 考虑添加软删除支持

我已将这些问题记录为 blocker 笔记。
"""
# [自动创建了 blocker 笔记]


# ========== 第二天:分析代码质量 ==========

# 1. 整体质量分析
response = maintainer.analyze()
"""
📊 分析代码质量...
🤖 正在思考...

🤖 助手: 代码质量分析报告:

📊 代码统计:
- 总行数: 3,542 行
- 平均文件长度: 约 150 行
- 最大文件: services/order_service.py (456 行)

⚠️ 发现的问题:

1. 代码重复 (HIGH):
   - user_service.py 和 product_service.py 有相似的 CRUD 逻辑
   - 建议: 提取基类 BaseService

2. 复杂度过高 (MEDIUM):
   - order_service.py::process_order 方法有 8 层嵌套
   - 建议: 拆分为多个小方法

3. 缺少测试 (HIGH):
   - 测试覆盖率仅 45%
   - services/ 目录完全没有测试

4. TODO/FIXME (12 个):
   - 大部分是"稍后优化"类的注释
   - 建议: 清理或转化为正式任务

我已将这些问题记录为笔记,并标记优先级。
"""
# [自动创建了多个 blocker 笔记]

# 2. 查看具体问题
response = maintainer.run("请查看 order_service.py 的 process_order 方法,给出重构建议")
"""
🤖 助手: 我查看了 process_order 方法的代码:

【原始代码】
def process_order(self, order_id):
    order = Order.query.get(order_id)
    if order:
        if order.status == 'pending':
            product = Product.query.get(order.product_id)
            if product:
                if product.stock >= order.quantity:
                    # ... 8 层嵌套继续 ...

【问题分析】
1. 过深的嵌套导致可读性差
2. 缺少错误处理
3. 业务逻辑与数据访问混在一起

【重构建议】
def process_order(self, order_id):
    # 1. 早返回模式,减少嵌套
    order = self._get_order(order_id)
    if not order or order.status != 'pending':
        return False

    # 2. 提取方法,单一职责
    if not self._check_stock(order):
        return False

    # 3. 使用事务确保一致性
    with db.transaction():
        self._update_stock(order)
        self._update_order_status(order, 'processing')

    return True

【下一步】
1. 我已创建重构计划笔记
2. 建议先编写测试用例
3. 逐步重构,保持功能不变
"""
# [自动创建了 action 笔记]


# ========== 第三天:规划重构任务 ==========

# 1. 回顾进度
response = maintainer.plan_next_steps()
"""
📋 加载任务规划...
🤖 正在思考...

🤖 助手: 基于前两天的探索和分析,我整理了重构任务优先级:

🔴 高优先级 (本周完成):
1. [blocker] User.email 添加唯一约束
   - 风险: 低,只是数据库迁移
   - 工作量: 1小时

2. [blocker] 提取 BaseService 减少代码重复
   - 风险: 中,影响多个服务类
   - 工作量: 半天

3. [blocker] 重构 process_order 方法
   - 风险: 高,核心业务逻辑
   - 工作量: 1天(包括编写测试)

🟡 中优先级 (下周):
4. 为 services/ 添加单元测试
5. 清理 TODO 注释
6. 为 Order 添加时间字段

🟢 低优先级 (待定):
7. 性能优化
8. 文档更新

建议:
- 本周先解决数据模型问题(任务1、6)
- 下周进行代码重构(任务2、3)
- 持续增加测试覆盖率(任务4)

我已更新任务状态笔记,您可以随时查看进度。
"""

# 2. 手动创建详细的重构计划
maintainer.create_note(
    title="本周重构计划 - Week 1",
    content="""## 目标
完成数据模型层的优化

## 任务清单
- [ ] 为 User.email 添加唯一约束
- [ ] 为 Order 添加 created_at, updated_at 字段
- [ ] 编写数据库迁移脚本
- [ ] 更新相关测试用例

## 时间安排
- 周一: 设计迁移脚本
- 周二-周三: 执行迁移并测试
- 周四: 更新测试用例
- 周五: Code Review

## 风险
- 数据库迁移可能影响线上环境,需要在非高峰期执行
- 现有数据中可能存在重复email,需要先清理
""",
    note_type="task_state",
    tags=["refactoring", "week1", "high_priority"]
)

print("✅ 已创建详细的重构计划")


# ========== 一周后:检查进度 ==========

# 查看笔记摘要
summary = maintainer.note_tool.run({"action": "summary"})
print("📊 笔记摘要:")
print(json.dumps(summary, indent=2, ensure_ascii=False))
"""
{
  "total_notes": 8,
  "type_distribution": {
    "blocker": 3,
    "action": 2,
    "task_state": 2,
    "conclusion": 1
  },
  "recent_notes": [
    {
      "id": "note_20250119_160000_7",
      "title": "本周重构计划 - Week 1",
      "type": "task_state",
      "updated_at": "2025-01-19T16:00:00"
    },
    ...
  ]
}
"""

# 生成完整报告
report = maintainer.generate_report()
print("\n📄 会话报告:")
print(json.dumps(report, indent=2, ensure_ascii=False))
"""
{
  "session_info": {
    "session_id": "session_20250119_150000",
    "project": "my_flask_app",
    "duration_seconds": 172800  # 2天
  },
  "activity": {
    "commands_executed": 24,
    "notes_created": 8,
    "issues_found": 3
  },
  "notes": { ... }
}
"""
9.6.5 运行效果分析
通过这个完整的案例,我们可以看到长程智能体的几个关键特性。首先是跨会话的连贯性,智能体通过 NoteTool 保持了跨多天、多个会话的任务连贯性,第一天探索的问题在第二天分析时被自动考虑,第三天规划时能够综合前两天的所有发现,一周后检查时完整的历史都被保留。其次是智能的上下文管理,ContextBuilder 确保每次对话都有高质量的上下文,自动汇集相关笔记(特别是 blocker 类型),根据对话模式动态调整预处理策略,在 token 预算内选择最相关的信息。
第三个特性是即时的文件系统访问,TerminalTool 支持灵活的代码探索,无需预先索引整个代码库,可以即时查看具体文件内容,支持复杂的文本处理(grep、awk等)。第四是自动化的知识管理,系统自动化地管理发现的知识,发现问题时自动创建 blocker 笔记,讨论计划时自动创建 action 笔记,关键信息自动存储到记忆系统。最后是人机协作,这个系统支持灵活的人机协作模式,智能体可以自动化地完成探索和分析,人类可以通过笔记系统进行干预和指导,支持手动创建详细的计划笔记。
这个基础框架可以进一步扩展,比如集成 RAGTool 为代码库建立向量索引结合语义检索,拆分为专门的探索者、分析者、规划者实现多智能体协作,集成测试工具自动验证重构结果,通过 TerminalTool 执行 git 命令追踪代码变更,或者使用 Gradio/Streamlit 构建可视化界面。