14.2.1 什么是 TODO 驱动的研究
传统的搜索引擎只能回答单个问题,而深度研究需要回答一系列相关的问题。TODO 驱动的研究范式将复杂的研究主题分解为多个子任务(TODO),逐个执行并整合结果。
这种范式的核心思想是:将"研究"这个复杂任务转化为"规划→执行→整合"的流程。
让我们通过一个例子来理解这个转变。假设你想研究"Datawhale 是一个什么样的组织?",传统的搜索方式是:
用户输入:Datawhale是一个什么样的组织?
搜索引擎:返回10-20个链接
用户:逐个点开链接,阅读内容,记录笔记
结果:碎片化的信息,缺少系统性
这种方式的问题在于每个链接只涵盖主题的一个方面、缺少系统性结构,需要手动整理和总结。
TODO 驱动方式:系统化研究
用户输入:Datawhale是一个什么样的组织?

系统规划:
  ├─ TODO 1:Datawhale的基本信息(组织定位)
  ├─ TODO 2:Datawhale的主要项目(核心内容)
  ├─ TODO 3:Datawhale的社区文化(价值观)
  └─ TODO 4:Datawhale的影响力(社会贡献)

系统执行:
  对每个TODO:
    1. 搜索相关资料
    2. 总结关键信息
    3. 记录来源引用

系统整合:
  生成结构化报告:
    ├─ 第一部分:组织定位(来自TODO 1)
    ├─ 第二部分:核心内容(来自TODO 2)
    ├─ 第三部分:价值观(来自TODO 3)
    ├─ 第四部分:社会贡献(来自TODO 4)
    └─ 参考文献:所有来源引用
这种方式的优势在于将复杂主题分解为清晰的子问题,每个子任务的搜索结果和总结都被记录下来,方便追溯。同时,系统化的研究流程避免了遗漏重要信息,可以轻松添加新的子任务或调整执行顺序。
一个完整的 TODO 驱动研究系统包含三个核心要素:
(1)智能规划器(TODO Planner):负责将研究主题分解为子任务。一个好的规划器需要理解主题的关键方面和研究目标,将主题分解为 3-5 个子任务(太少覆盖不全,太多会冗余),并为每个子任务设计合适的搜索查询。
(2)任务执行器(Task Executor):负责执行每个子任务。执行器需要使用搜索引擎获取相关资料,提取关键信息并去除冗余内容,同时保存所有来源引用以方便验证。
(3)报告生成器(Report Writer):负责整合所有子任务的结果。生成器需要按照逻辑顺序组织内容,合并重复的信息,并为每个观点添加来源引用。
在我们的案例里,TODO 驱动的研究流程如图 14.5 所示:
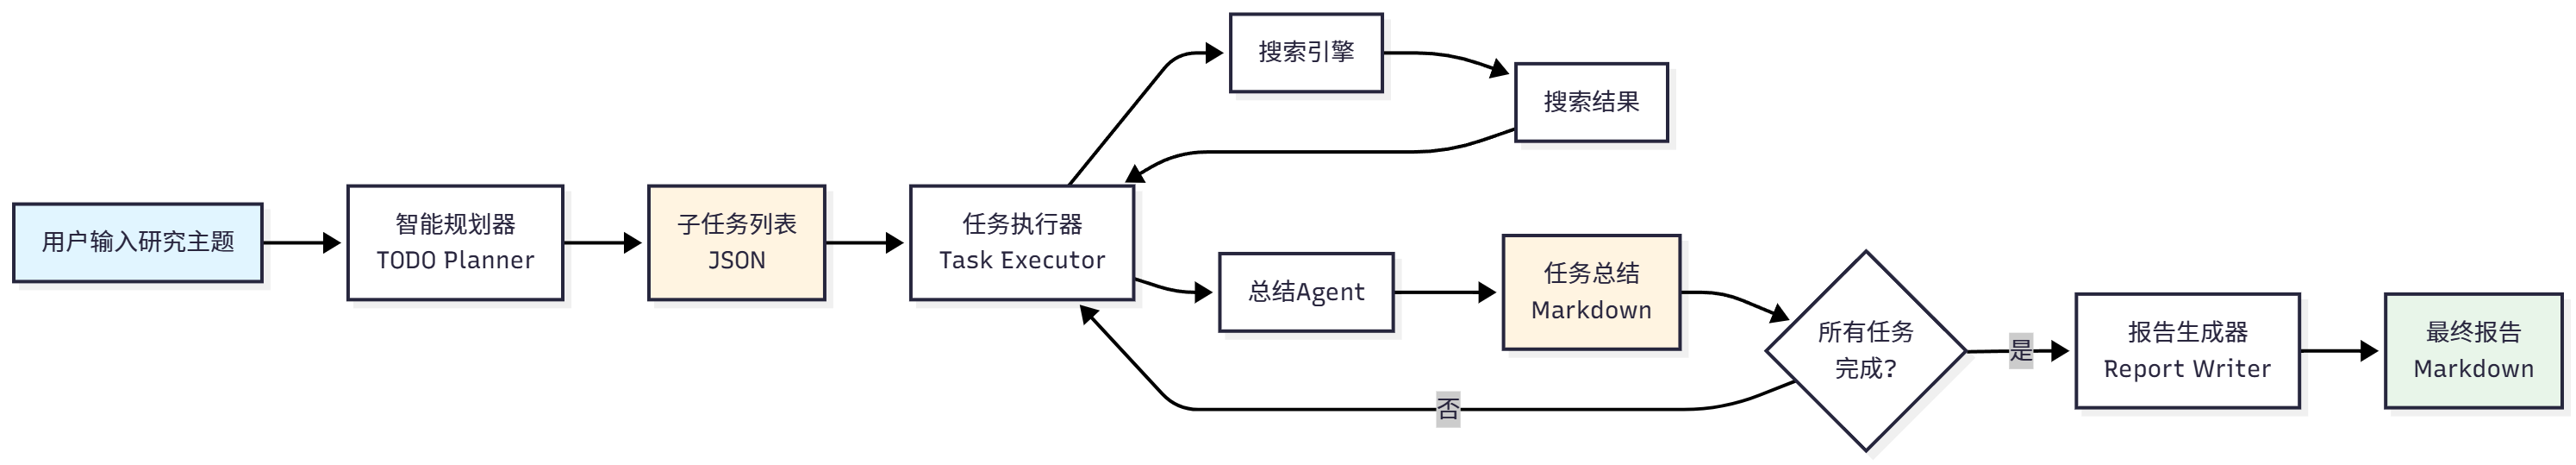
图 14.5 TODO 驱动的研究流程
整个流程是线性的,但每个阶段都有明确的输入和输出。这种设计使得系统易于理解和调试。
14.2.2 三阶段研究流程
TODO 驱动的研究流程分为三个阶段:规划(Planning)、执行(Execution)、报告(Reporting)。每个阶段都有专门的 Agent 负责。
(1)阶段 1:规划
规划阶段的目标是将研究主题分解为 3-5 个子任务。系统接收研究主题和当前日期作为输入,输出 JSON 格式的子任务列表。每个子任务包含三个字段:title(任务标题)、intent(研究意图)和 query(搜索查询)。
研究规划 Agent 会根据主题特点采用不同的分解策略,通常从基础概念入手,然后了解技术现状、实际应用和发展趋势,必要时还会进行对比分析。例如,对于"Datawhale 是一个什么样的组织?",规划 Agent 可能生成以下子任务:
[
  {
    "title": "Datawhale的基本信息",
    "intent": "了解Datawhale的组织定位、成立时间、发展历程",
    "query": "Datawhale organization introduction history 2024"
  },
  {
    "title": "Datawhale的主要项目",
    "intent": "了解Datawhale的核心开源项目和教程",
    "query": "Datawhale projects tutorials open source 2024"
  },
......
]
一个好的规划应该覆盖全面、逻辑清晰、查询精准、条目数量适中。
(2)阶段 2:执行
执行阶段逐个执行每个子任务,搜索并总结相关资料。系统接收子任务列表和搜索引擎配置作为输入,输出每个子任务的总结(Markdown 格式)和来源引用列表。执行流程如下:
对于每个子任务,执行器会:
-
搜索资料:使用配置的搜索引擎执行搜索
search_results = search_tool.run({ "input": task.query, "backend": "tavily", "mode": "structured", "max_results": 5 }) -
获取搜索结果:提取标题、URL、摘要
{ "results": [ { "title": "What is a Multimodal Model?", "url": "https://example.com/multimodal-model", "snippet": "A multimodal model is an AI model that can process multiple types of data..." }, ... ] } -
调用总结 Agent:总结搜索结果
summary = summarizer_agent.run( task=task, search_results=search_results ) -
记录总结和来源:保存到 NoteTool
note_tool.run({
    "action": "create",
    "title": task.title,
    "content": f"## {task.title}\n\n{summary}\n\n## 来源\n{sources}",
    "tags": ["research", "summary"]
})
任务总结 Agent 会从每个搜索结果中提取核心观点,合并相似信息,保留重要的数字、日期、名称等关键数据,并为每个观点添加来源引用。例如,对于"Datawhale 的基本信息"的搜索结果,总结 Agent 可能生成:
## Datawhale的基本信息

Datawhale是一个专注于数据科学与AI领域的开源组织,成立于2018年[1]。组织的核心使命是"for the learner,和学习者一起成长",致力于构建一个纯粹的学习社区[2]。

**核心定位:**

1. **开源教育平台**:提供高质量的AI和数据科学学习资源[1]
2. **学习者社区**:汇聚了数万名AI学习者和实践者[3]
3. **知识共享**:倡导开源精神,所有内容完全免费开放[2]

**发展历程:**

- **2018年**:Datawhale成立,发布首个开源教程[1]
- **2020年**:成为国内领先的AI学习社区之一[3]
- **2024年**:累计发布50+开源项目,影响10万+学习者[4]

## 来源

[1] https://github.com/datawhalechina
[2] https://datawhale.club/about
[3] https://www.zhihu.com/org/datawhale
[4] https://datawhale.cn
在执行过程中,系统会实时推送进度信息到前端:
{
  "type": "status",
  "message": "正在搜索:Datawhale的基本信息"
}
{
  "type": "status",
  "message": "正在总结搜索结果..."
}
{
  "type": "task",
  "task": {
    "id": 1,
    "title": "Datawhale的基本信息",
    "status": "completed"
  }
}
(3)阶段 3:报告
报告阶段的目标是整合所有子任务的总结,生成最终报告。系统接收所有子任务的总结和研究主题作为输入,输出 Markdown 格式的最终报告。报告包含标题、概述、各个子任务的详细分析、总结和参考文献五个部分。例如,对于"Datawhale 是一个什么样的组织?",最终报告可能是:
# Datawhale是一个什么样的组织?

## 概述

本报告系统地研究了Datawhale这个开源组织,涵盖基本信息、主要项目、社区文化和影响力四个方面。

## 1. Datawhale的基本信息

Datawhale是一个专注于数据科学与AI领域的开源组织,成立于2018年...

(此处插入子任务1的总结)

## 2. Datawhale的主要项目

Datawhale发布了多个高质量的开源教程,包括Hello-Agents、Joyful-Pandas等...

(此处插入子任务2的总结)
......
## 总结

通过本次研究,我们了解了Datawhale的组织定位、核心项目、社区文化和社会贡献。Datawhale是一个纯粹的学习社区,为AI教育做出了重要贡献。

## 参考文献

[1] https://github.com/datawhalechina
[2] https://datawhale.club/about
...
报告生成 Agent 会按照子任务的逻辑顺序组织内容,在开头添加简要概述,合并重复的信息,统一 Markdown 格式,并将所有来源引用整理到参考文献部分。