在本章中,以第三章掌握的大语言模型知识为基础,我们通过“亲手造轮子”的方式,从零开始编码实现了三种业界经典的智能体构建范式:ReAct、Plan-and-Solve 与 Reflection。我们不仅探索了它们的核心工作原理,还通过具体的实战案例,深入了解了各自的优势、局限与适用场景。
核心知识点回顾:
- ReAct:我们构建了一个能与外部世界交互的 ReAct 智能体。通过“思考-行动-观察”的动态循环,它成功地利用搜索引擎回答了自身知识库无法覆盖的实时性问题。其核心优势在于环境适应性和动态纠错能力,使其成为处理探索性、需要外部工具输入的任务的首选。
- Plan-and-Solve:我们实现了一个先规划后执行的 Plan-and-Solve 智能体,并利用它解决了需要多步推理的数学应用题。它将复杂的任务分解为清晰的步骤,然后逐一执行。其核心优势在于结构性和稳定性,特别适合处理逻辑路径确定、内部推理密集的任务。
- Reflection (自我反思与迭代):我们构建了一个具备自我优化能力的 Reflection 智能体。通过引入“执行-反思-优化”的迭代循环,它成功地将一个效率较低的初始代码方案,优化为了一个算法上更优的高性能版本。其核心价值在于能显著提升解决方案的质量,适用于对结果的准确性和可靠性有极高要求的场景。
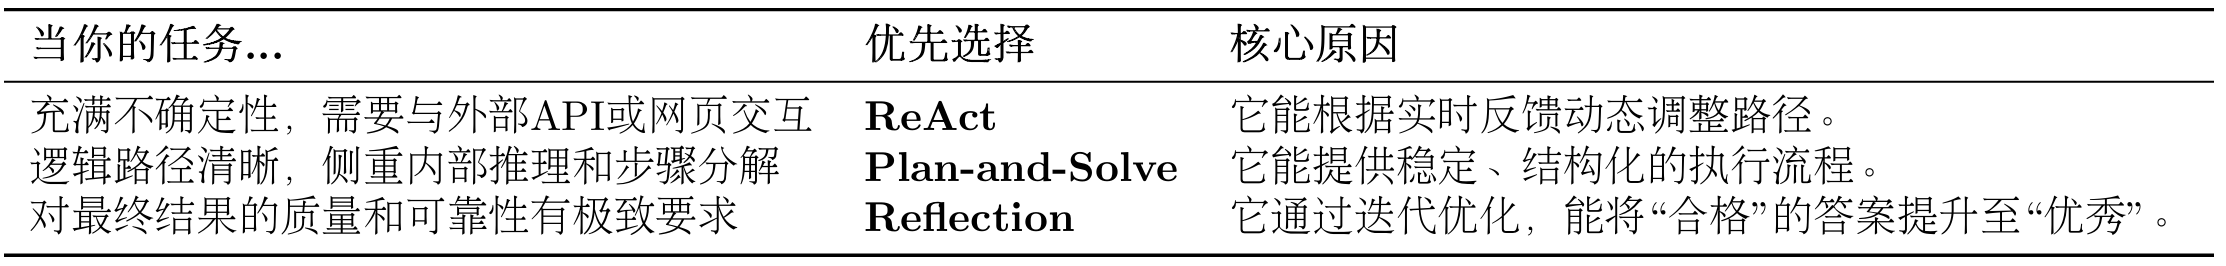
本章探讨的三种范式,代表了智能体解决问题的三种不同策略,如表4.1所示。在实际应用中,选择哪一种,取决于任务的核心需求:
表 4.1 不同 Agent Loop 的选择策略
至此,我们已经掌握了构建单个智能体的核心技术。为了过渡知识,以及对实际应用更加深入。下一节我们将会探索不同低代码平台的使用方式以及轻代码构建agent的方案。