8.1.1 人类记忆系统的启发
在构建智能体的记忆系统之前,让我们先从认知科学的角度理解人类是如何处理和存储信息的。人类记忆是一个多层级的认知系统,它不仅能存储信息,还能根据重要性、时间和上下文对信息进行分类和整理。认知心理学为理解记忆的结构和过程提供了经典的理论框架[1],如图8.1所示。
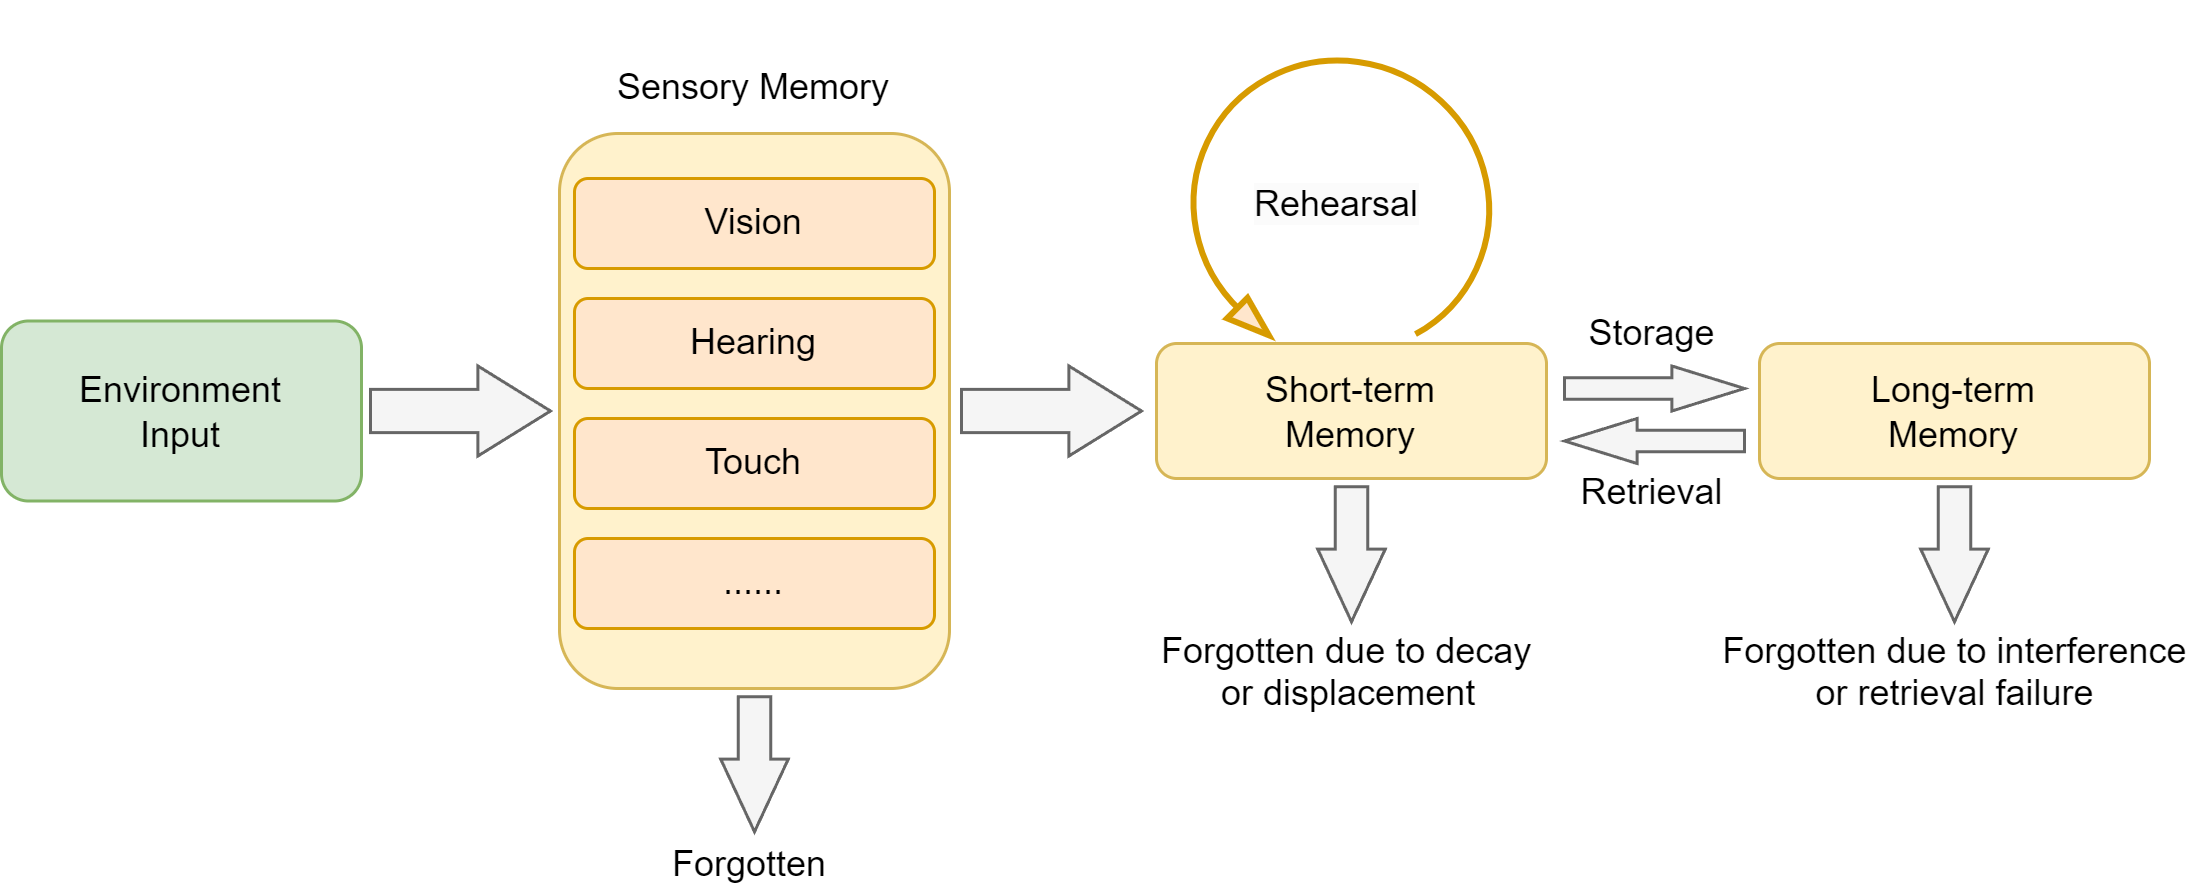
图 8.1 人类记忆系统的层次结构
根据认知心理学的研究,人类记忆可以分为以下几个层次:
- 感觉记忆(Sensory Memory):持续时间极短(0.5-3秒),容量巨大,负责暂时保存感官接收到的所有信息
- 工作记忆(Working Memory):持续时间短(15-30秒),容量有限(7±2个项目),负责当前任务的信息处理
- 长期记忆(Long-term Memory):持续时间长(可达终生),容量几乎无限,进一步分为:
- 程序性记忆:技能和习惯(如骑自行车)
- 陈述性记忆:可以用语言表达的知识,又分为:
- 语义记忆:一般知识和概念(如"巴黎是法国首都")
- 情景记忆:个人经历和事件(如"昨天的会议内容")
8.1.2 为何智能体需要记忆与RAG
借鉴人类记忆系统的设计,我们可以理解为什么智能体也需要类似的记忆能力。人类智能的一个重要特征就是能够记住过去的经历,从中学习,并将这些经验应用到新的情况中。同样,一个真正智能的智能体也需要具备记忆能力。对于基于LLM的智能体而言,通常面临两个根本性局限:对话状态的遗忘和内置知识的局限。
(1)局限一:无状态导致的对话遗忘
当前的大语言模型虽然强大,但设计上是无状态的。这意味着,每一次用户请求(或API调用)都是一次独立的、无关联的计算。模型本身不会自动“记住”上一次对话的内容。这带来了几个问题:
- 上下文丢失:在长对话中,早期的重要信息可能会因为上下文窗口限制而丢失
- 个性化缺失:Agent无法记住用户的偏好、习惯或特定需求
- 学习能力受限:无法从过往的成功或失败经验中学习改进
- 一致性问题:在多轮对话中可能出现前后矛盾的回答
让我们通过一个具体例子来理解这个问题:
# 第七章的Agent使用方式
from hello_agents import SimpleAgent, HelloAgentsLLM

agent = SimpleAgent(name="学习助手", llm=HelloAgentsLLM())

# 第一次对话
response1 = agent.run("我叫张三,正在学习Python,目前掌握了基础语法")
print(response1)  # "很好!Python基础语法是编程的重要基础..."

# 第二次对话(新的会话,例如重启程序后重新创建Agent)
agent = SimpleAgent(name="学习助手", llm=HelloAgentsLLM())
response2 = agent.run("你还记得我的学习进度吗?")
print(response2)  # "抱歉,我不知道您的学习进度..."
需要注意的是,第七章中的 SimpleAgent 会在同一个实例的 _history 中暂存当前对话,因此同一进程、同一实例内的连续对话可以携带最近上下文。但这种历史只是临时消息列表,不会跨会话持久化,也不能进行长期检索、遗忘和整合。
要解决这个问题,我们的框架需要引入记忆系统。
(2)局限二:模型内置知识的局限性
除了遗忘对话历史,LLM 的另一个核心局限在于其知识是静态的、有限的。这些知识完全来自于它的训练数据,并因此带来一系列问题:
- 知识时效性:大模型的训练数据有时间截止点,无法获取最新信息
- 专业领域知识:通用模型在特定领域的深度知识可能不足
- 事实准确性:通过检索验证,减少模型的幻觉问题
- 可解释性:提供信息来源,增强回答的可信度
为了克服这一局限,RAG技术应运而生。它的核心思想是在模型生成回答之前,先从一个外部知识库(如文档、数据库、API)中检索出最相关的信息,并将这些信息作为上下文一同提供给模型。
8.1.3 记忆与RAG系统架构设计
基于第七章建立的框架基础和认知科学的启发,我们设计了一个分层的记忆与RAG系统架构,如图8.2所示。这个架构不仅借鉴了人类记忆系统的层次结构,还充分考虑了工程实现的可扩展性。在实现上,我们将记忆和RAG设计为两个独立的工具:memory_tool负责存储和维护对话过程中的交互信息,rag_tool则负责从用户提供的知识库中检索相关信息作为上下文,并可将重要的检索结果自动存储到记忆系统中。
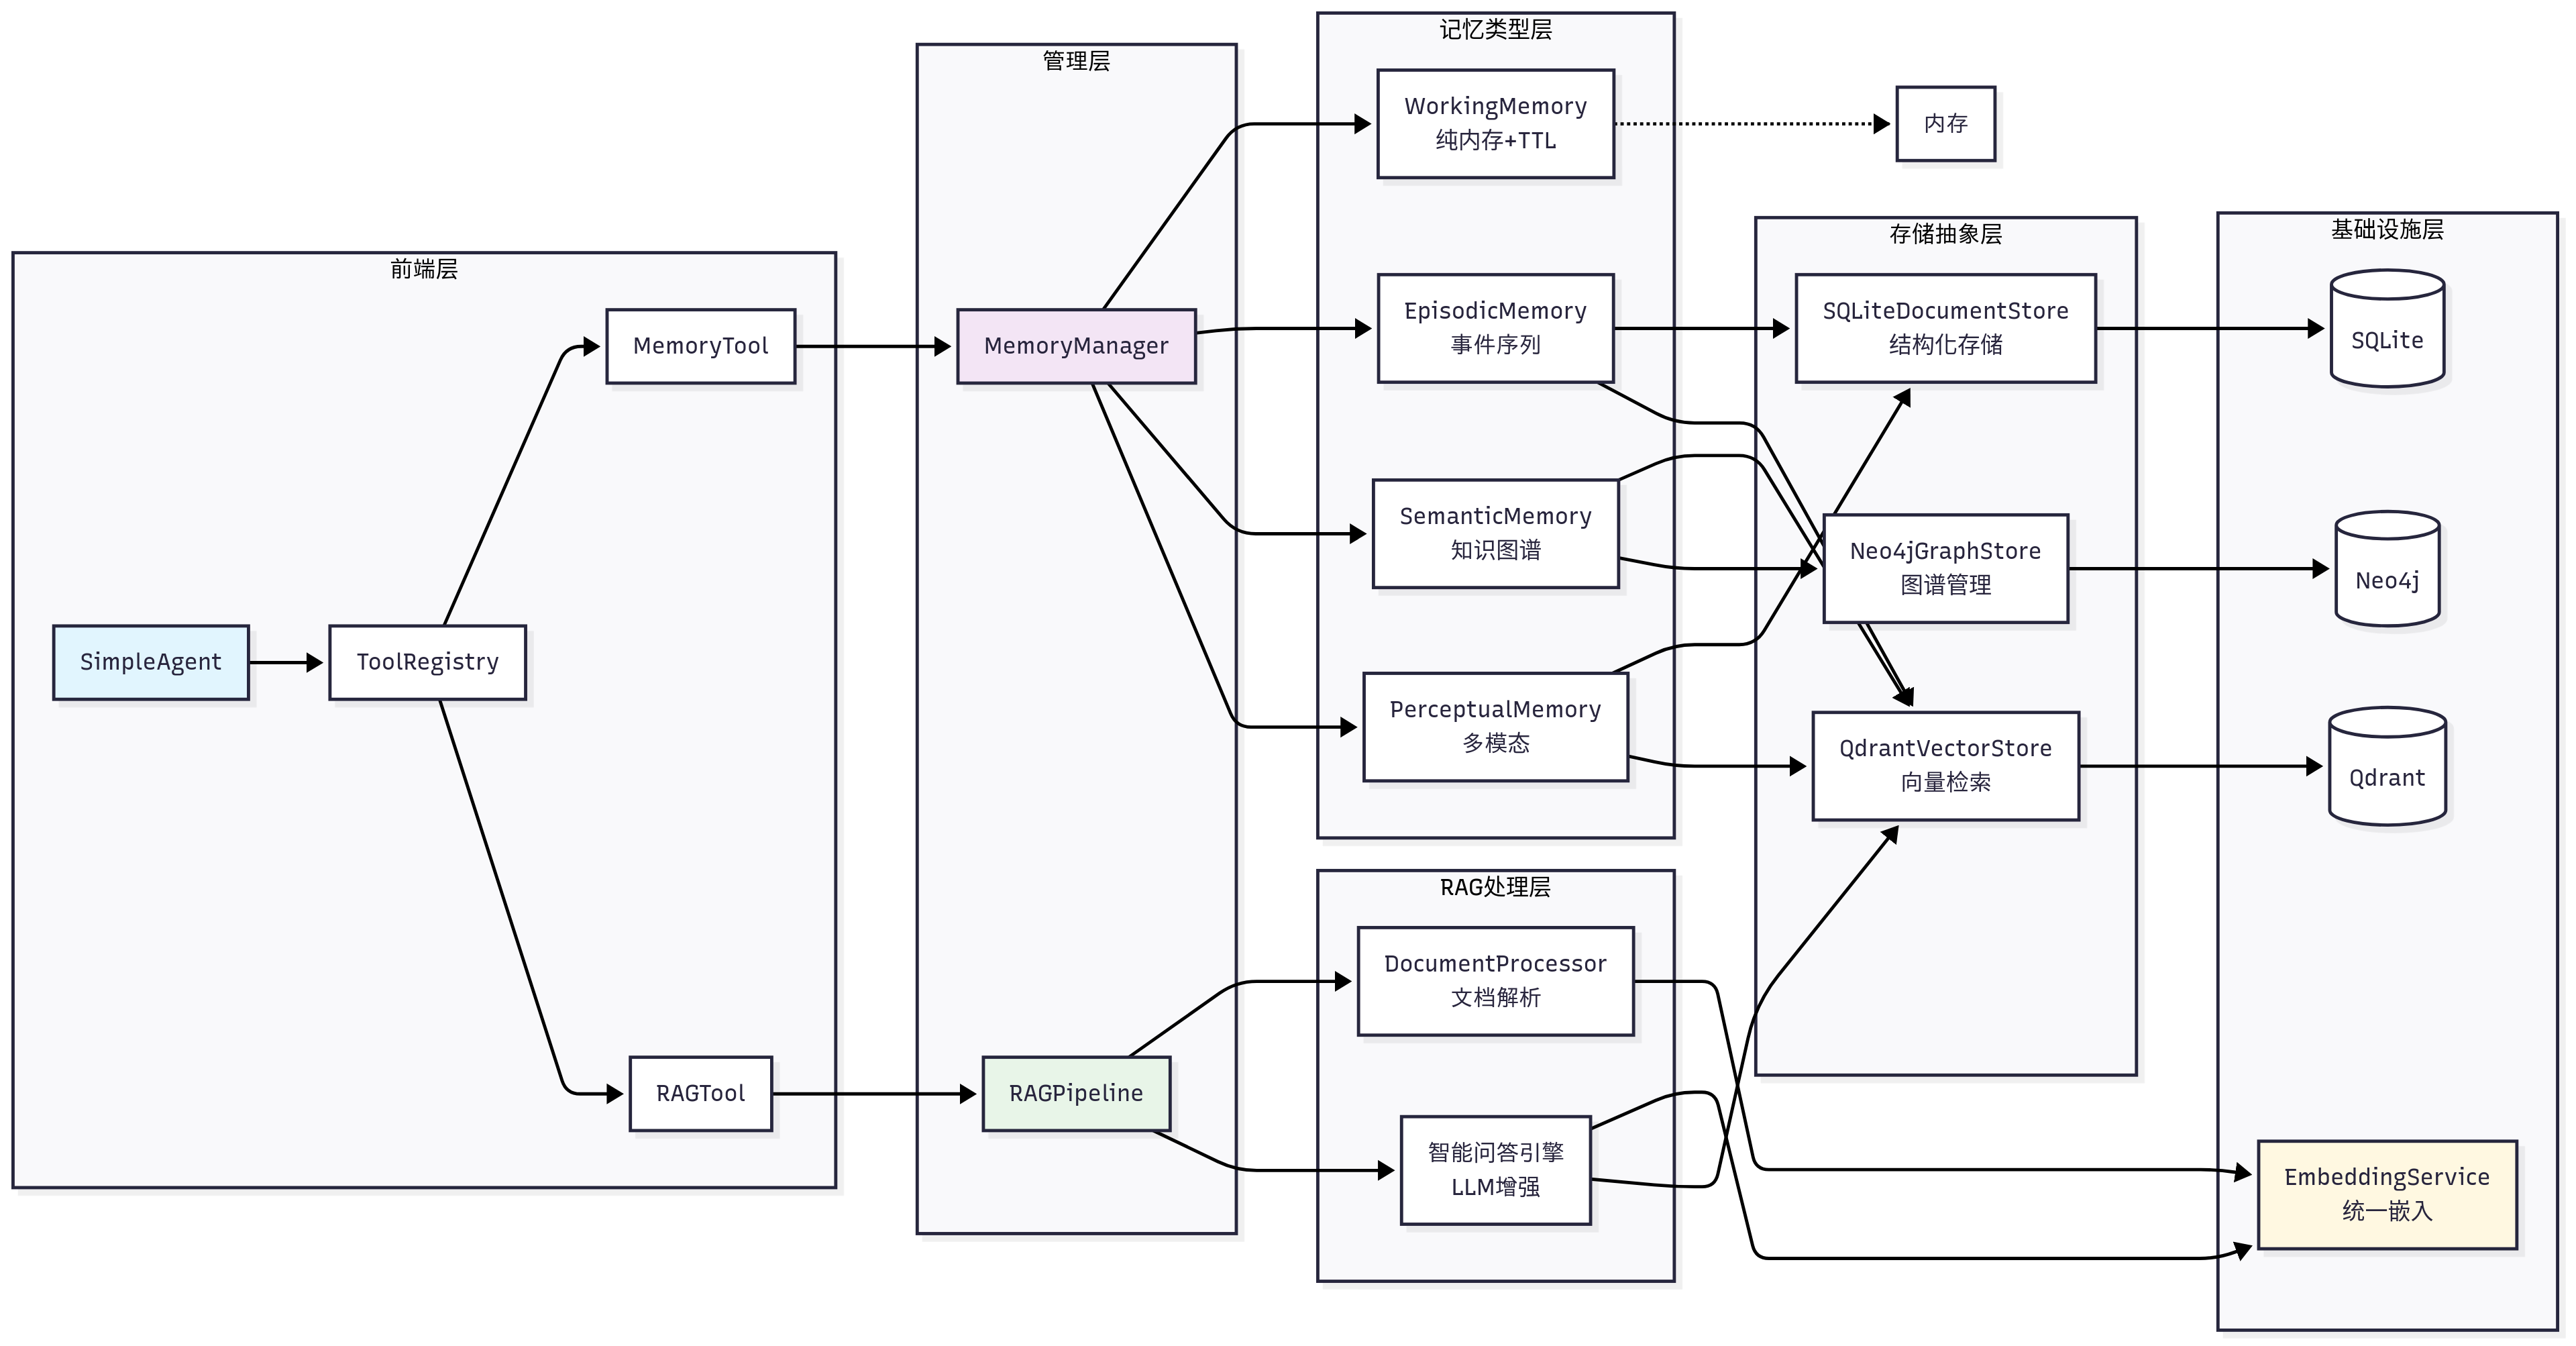
图 8.2 HelloAgents记忆与RAG系统整体架构
记忆系统采用了四层架构设计:
HelloAgents记忆系统
├── 基础设施层 (Infrastructure Layer)
│   ├── MemoryManager - 记忆管理器(统一调度和协调)
│   ├── MemoryItem - 记忆数据结构(标准化记忆项)
│   ├── MemoryConfig - 配置管理(系统参数设置)
│   └── BaseMemory - 记忆基类(通用接口定义)
├── 记忆类型层 (Memory Types Layer)
│   ├── WorkingMemory - 工作记忆(临时信息,TTL管理)
│   ├── EpisodicMemory - 情景记忆(具体事件,时间序列)
│   ├── SemanticMemory - 语义记忆(抽象知识,图谱关系)
│   └── PerceptualMemory - 感知记忆(多模态数据)
├── 存储后端层 (Storage Backend Layer)
│   ├── QdrantVectorStore - 向量存储(高性能语义检索)
│   ├── Neo4jGraphStore - 图存储(知识图谱管理)
│   └── SQLiteDocumentStore - 文档存储(结构化持久化)
└── 嵌入服务层 (Embedding Service Layer)
    ├── DashScopeEmbedding - 通义千问嵌入(云端API)
    ├── LocalTransformerEmbedding - 本地嵌入(离线部署)
    └── TFIDFEmbedding - TFIDF嵌入(轻量级兜底)
RAG系统专注于外部知识的获取和利用:
HelloAgents RAG系统
├── 文档处理层 (Document Processing Layer)
│   ├── DocumentProcessor - 文档处理器(多格式解析)
│   ├── Document - 文档对象(元数据管理)
│   └── Pipeline - RAG管道(端到端处理)
├── 嵌入表示层 (Embedding Layer)
│   └── 统一嵌入接口 - 复用记忆系统的嵌入服务
├── 向量存储层 (Vector Storage Layer)
│   └── QdrantVectorStore - 向量数据库(命名空间隔离)
└── 智能问答层 (Intelligent Q&A Layer)
    ├── 多策略检索 - 向量检索 + MQE + HyDE
    ├── 上下文构建 - 智能片段合并与截断
    └── LLM增强生成 - 基于上下文的准确问答
8.1.4 本章学习目标与快速体验
让我们先看看第八章的核心学习内容:
hello-agents/
├── hello_agents/
│   ├── memory/                   # 记忆系统模块
│   │   ├── base.py               # 基础数据结构(MemoryItem, MemoryConfig, BaseMemory)
│   │   ├── manager.py            # 记忆管理器(统一协调调度)
│   │   ├── embedding.py          # 统一嵌入服务(DashScope/Local/TFIDF)
│   │   ├── types/                # 记忆类型实现
│   │   │   ├── working.py        # 工作记忆(TTL管理,纯内存)
│   │   │   ├── episodic.py       # 情景记忆(事件序列,SQLite+Qdrant)
│   │   │   ├── semantic.py       # 语义记忆(知识图谱,Qdrant+Neo4j)
│   │   │   └── perceptual.py     # 感知记忆(多模态,SQLite+Qdrant)
│   │   ├── storage/              # 存储后端实现
│   │   │   ├── qdrant_store.py   # Qdrant向量存储(高性能向量检索)
│   │   │   ├── neo4j_store.py    # Neo4j图存储(知识图谱管理)
│   │   │   └── document_store.py # SQLite文档存储(结构化持久化)
│   │   └── rag/                  # RAG系统
│   │       ├── pipeline.py       # RAG管道(端到端处理)
│   │       └── document.py       # 文档处理器(多格式解析)
│   └── tools/builtin/            # 扩展内置工具
│       ├── memory_tool.py        # 记忆工具(Agent记忆能力)
│       └── rag_tool.py           # RAG工具(智能问答能力)
└──
快速开始:安装HelloAgents框架
为了让读者能够快速体验本章的完整功能,我们提供了可直接安装的Python包。你可以通过以下命令安装本章对应的版本:
# 0.2.0版本若遇到模型不可用,查看issue#320或切换0.2.9版本进行测试
pip install "hello-agents[all]==0.2.0"
python -m spacy download zh_core_web_sm
python -m spacy download en_core_web_sm
除此之外,还需要在.env配置图数据库,向量数据库,LLM以及Embedding方案的API。在教程中向量数据库采用Qdrant,图数据库采用Neo4J,Embedding首选百炼平台,若没有API可切换为本地部署模型方案。
# ================================
# Qdrant 向量数据库配置 - 获取API密钥:https://cloud.qdrant.io/
# ================================
# 使用Qdrant云服务 (推荐)
QDRANT_URL=https://your-cluster.qdrant.tech:6333
QDRANT_API_KEY=your_qdrant_api_key_here

# 或使用本地Qdrant (需要Docker)
# QDRANT_URL=http://localhost:6333
# QDRANT_API_KEY=

# Qdrant集合配置
QDRANT_COLLECTION=hello_agents_vectors
QDRANT_VECTOR_SIZE=384
QDRANT_DISTANCE=cosine
QDRANT_TIMEOUT=30

# ================================
# Neo4j 图数据库配置 - 获取API密钥:https://neo4j.com/cloud/aura/
# ================================
# 使用Neo4j Aura云服务 (推荐)
NEO4J_URI=neo4j+s://your-instance.databases.neo4j.io
NEO4J_USERNAME=neo4j
NEO4J_PASSWORD=your_neo4j_password_here

# 或使用本地Neo4j (需要Docker)
# NEO4J_URI=bolt://localhost:7687
# NEO4J_USERNAME=neo4j
# NEO4J_PASSWORD=hello-agents-password

# Neo4j连接配置
NEO4J_DATABASE=neo4j
NEO4J_MAX_CONNECTION_LIFETIME=3600
NEO4J_MAX_CONNECTION_POOL_SIZE=50
NEO4J_CONNECTION_TIMEOUT=60

# ==========================
# 嵌入(Embedding)配置示例 - 可从阿里云控制台获取:https://dashscope.aliyun.com/
# ==========================
# - 若为空,dashscope 默认 text-embedding-v3;local 默认 sentence-transformers/all-MiniLM-L6-v2
EMBED_MODEL_TYPE=dashscope
EMBED_MODEL_NAME=
EMBED_API_KEY=
EMBED_BASE_URL=
本章的学习可以采用两种方式:
- 体验式学习:直接使用
pip安装框架,运行示例代码,快速体验各种功能 - 深度学习:跟随本章内容,从零开始实现每个组件,深入理解框架的设计思想和实现细节
我们建议采用"先体验,后实现"的学习路径。在本章中,我们提供了完整的测试文件,你可以重写核心函数并运行测试,以检验你的实现是否正确。
遵循第七章确立的设计原则,我们将记忆和RAG能力封装为标准工具,而不是创建新的Agent类。在开始之前,让我们用30秒体验使用Hello-agents构建具有记忆和RAG能力的智能体!
# 配置好同级文件夹下.env中的大模型API
from hello_agents import SimpleAgent, HelloAgentsLLM, ToolRegistry
from hello_agents.tools import MemoryTool, RAGTool

# 创建LLM实例
llm = HelloAgentsLLM()

# 创建工具注册表
tool_registry = ToolRegistry()

# 添加记忆工具
memory_tool = MemoryTool(user_id="user123")
tool_registry.register_tool(memory_tool)

# 添加RAG工具
rag_tool = RAGTool(knowledge_base_path="./knowledge_base")
tool_registry.register_tool(rag_tool)

# 创建Agent并配置工具
agent = SimpleAgent(
    name="智能助手",
    llm=llm,
    system_prompt="你是一个有记忆和知识检索能力的AI助手",
    tool_registry=tool_registry
)

# 开始对话
response = agent.run("你好!请记住我叫张三,我是一名Python开发者")
print(response)
如果一切配置完毕,可以看到以下内容。
[OK] SQLite 数据库表和索引创建完成
[OK] SQLite 文档存储初始化完成: ./memory_data\memory.db
INFO:hello_agents.memory.storage.qdrant_store:✅ 成功连接到Qdrant云服务: https://0c517275-2ad0-4442-8309-11c36dc7e811.us-east-1-1.aws.cloud.qdrant.io:6333
INFO:hello_agents.memory.storage.qdrant_store:✅ 使用现有Qdrant集合: hello_agents_vectors
INFO:hello_agents.memory.types.semantic:✅ 嵌入模型就绪,维度: 1024
INFO:hello_agents.memory.types.semantic:✅ Qdrant向量数据库初始化完成
INFO:hello_agents.memory.storage.neo4j_store:✅ 成功连接到Neo4j云服务: neo4j+s://851b3a28.databases.neo4j.io      NFO:hello_agents.memory.types.semantic:✅ Neo4j图数据库初始化完成
INFO:hello_agents.memory.storage.neo4j_store:✅ Neo4j索引创建完成
INFO:hello_agents.memory.types.semantic:✅ Neo4j图数据库初始化完成
INFO:hello_agents.memory.types.semantic:🏥 数据库健康状态: Qdrant=✅, Neo4j=✅
INFO:hello_agents.memory.types.semantic:✅ 加载中文spaCy模型: zh_core_web_sm
INFO:hello_agents.memory.types.semantic:✅ 加载英文spaCy模型: en_core_web_sm
INFO:hello_agents.memory.types.semantic:📚 可用语言模型: 中文, 英文
INFO:hello_agents.memory.types.semantic:增强语义记忆初始化完成(使用Qdrant+Neo4j专业数据库)
INFO:hello_agents.memory.manager:MemoryManager初始化完成,启用记忆类型: ['working', 'episodic', 'semantic']
✅ 工具 'memory' 已注册。
INFO:hello_agents.memory.storage.qdrant_store:✅ 成功连接到Qdrant云服务: https://0c517275-2ad0-4442-8309-11c36dc7eNFO:hello_agents.memory.storage.qdrant_store:✅ 使用现有Qdrant集合: rag_knowledge_base
811.us-east-1-1.aws.cloud.qdrant.io:6333
INFO:hello_agents.memory.storage.qdrant_store:✅ 使用现有Qdrant集合: rag_knowledge_base
✅ RAG工具初始化成功: namespace=default, collection=rag_knowledge_base
✅ 工具 'rag' 已注册。
你好,张三!很高兴认识你。作为一名Python开发者,你一定对编程很有热情。如果你有任何技术问题或者需要讨论Python相关
的话题,随时可以找我。我会尽力帮助你。有什么我现在就能帮到你的吗?