在前面的章节中,我们详细介绍了HelloAgents的记忆系统和RAG系统的设计与实现。现在,让我们通过一个完整的实战案例,展示如何将这两个系统有机结合,构建一个智能文档问答助手。
8.4.1 案例背景与目标
在实际工作中,我们经常需要处理大量的技术文档、研究论文、产品手册等PDF文件。传统的文档阅读方式效率低下,难以快速定位关键信息,更无法建立知识间的关联。
本案例将基于Datawhale另外一门动手学大模型教程Happy-LLM的公测PDF文档Happy-LLM-0727.pdf为例,构建一个基于Gradio的Web应用,展示如何使用RAGTool和MemoryTool构建完整的交互式学习助手。PDF可在这个链接获取。
我们希望实现以下功能:
-
智能文档处理:使用MarkItDown实现PDF到Markdown的统一转换,基于Markdown结构的智能分块策略,高效的向量化和索引构建
-
高级检索问答:多查询扩展(MQE)提升召回率,假设文档嵌入(HyDE)改善检索精度,上下文感知的智能问答
-
多层次记忆管理:工作记忆管理当前学习任务和上下文,情景记忆记录学习事件和查询历史,语义记忆存储概念知识和理解,感知记忆处理文档特征和多模态信息
-
个性化学习支持:基于学习历史的个性化推荐,记忆整合和选择性遗忘,学习报告生成和进度追踪
为了更清晰地展示整个系统的工作流程,图8.6展示了五个步骤之间的关系和数据流动。五个步骤形成了一个完整的闭环:步骤1将PDF文档处理后的信息记录到记忆系统,步骤2的检索结果也会记录到记忆系统,步骤3展示记忆系统的完整功能(添加、检索、整合、遗忘),步骤4整合RAG和Memory提供智能路由,步骤5收集所有统计信息生成学习报告。

图 8.6 智能问答助手的五步执行流程
接下来,我们将展示如何实现这个Web应用。整个应用分为三个核心部分:
- 核心助手类(PDFLearningAssistant):封装RAGTool和MemoryTool的调用逻辑
- Gradio Web界面:提供友好的用户交互界面,这个部分可以参考示例代码学习
- 其他核心功能:笔记记录、学习回顾、统计查看和报告生成
8.4.2 核心助手类的实现
首先,我们实现核心的助手类PDFLearningAssistant,它封装了RAGTool和MemoryTool的调用逻辑。
(1)类的初始化
class PDFLearningAssistant:
    """智能文档问答助手"""

    def __init__(self, user_id: str = "default_user"):
        """初始化学习助手

        Args:
            user_id: 用户ID,用于隔离不同用户的数据
        """
        self.user_id = user_id
        self.session_id = f"session_{datetime.now().strftime('%Y%m%d_%H%M%S')}"

        # 初始化工具
        self.memory_tool = MemoryTool(user_id=user_id)
        self.rag_tool = RAGTool(rag_namespace=f"pdf_{user_id}")

        # 学习统计
        self.stats = {
            "session_start": datetime.now(),
            "documents_loaded": 0,
            "questions_asked": 0,
            "concepts_learned": 0
        }

        # 当前加载的文档
        self.current_document = None
在这个初始化过程中,我们做了几个关键的设计决策:
MemoryTool的初始化:通过user_id参数实现用户级别的记忆隔离。不同用户的学习记忆是完全独立的,每个用户都有自己的工作记忆、情景记忆、语义记忆和感知记忆空间。
RAGTool的初始化:通过rag_namespace参数实现知识库的命名空间隔离。使用f"pdf_{user_id}"作为命名空间,每个用户都有自己独立的PDF知识库。
会话管理:session_id用于追踪单次学习会话的完整过程,便于后续的学习历程回顾和分析。
统计信息:stats字典记录关键的学习指标,用于生成学习报告。
(2)加载PDF文档
def load_document(self, pdf_path: str) -> Dict[str, Any]:
    """加载PDF文档到知识库

    Args:
        pdf_path: PDF文件路径

    Returns:
        Dict: 包含success和message的结果
    """
    if not os.path.exists(pdf_path):
        return {"success": False, "message": f"文件不存在: {pdf_path}"}

    start_time = time.time()

    # 【RAGTool】处理PDF: MarkItDown转换 → 智能分块 → 向量化
    result = self.rag_tool.execute(
        "add_document",
        file_path=pdf_path,
        chunk_size=1000,
        chunk_overlap=200
    )

    process_time = time.time() - start_time

    if result.get("success", False):
        self.current_document = os.path.basename(pdf_path)
        self.stats["documents_loaded"] += 1

        # 【MemoryTool】记录到学习记忆
        self.memory_tool.execute(
            "add",
            content=f"加载了文档《{self.current_document}》",
            memory_type="episodic",
            importance=0.9,
            event_type="document_loaded",
            session_id=self.session_id
        )

        return {
            "success": True,
            "message": f"加载成功!(耗时: {process_time:.1f}秒)",
            "document": self.current_document
        }
    else:
        return {
            "success": False,
            "message": f"加载失败: {result.get('error', '未知错误')}"
        }
我们通过一行代码就能完成PDF的处理:
result = self.rag_tool.execute(
    "add_document",
    file_path=pdf_path,
    chunk_size=1000,
    chunk_overlap=200
)
这个调用会触发RAGTool的完整处理流程(MarkItDown转换、增强处理、智能分块、向量化存储),这些内部细节在8.3节已经详细介绍过。我们只需要关注:
- 操作类型:
"add_document"- 添加文档到知识库 - 文件路径:
file_path- PDF文件的路径 - 分块参数:
chunk_size=1000, chunk_overlap=200- 控制文本分块 - 返回结果:包含处理状态和统计信息的字典
文档加载成功后,我们使用MemoryTool记录到情景记忆:
self.memory_tool.execute(
    "add",
    content=f"加载了文档《{self.current_document}》",
    memory_type="episodic",
    importance=0.9,
    event_type="document_loaded",
    session_id=self.session_id
)
为什么用情景记忆? 因为这是一个具体的、有时间戳的事件,适合用情景记忆记录。session_id参数将这个事件关联到当前学习会话,便于后续回顾学习历程。
这个记忆记录为后续的个性化服务奠定了基础:
- 用户询问"我之前加载过哪些文档?" → 从情景记忆中检索
- 系统可以追踪用户的学习历程和文档使用情况
8.4.3 智能问答功能
文档加载完成后,用户就可以向文档提问了。我们实现一个ask方法来处理用户的问题:
def ask(self, question: str, use_advanced_search: bool = True) -> str:
    """向文档提问

    Args:
        question: 用户问题
        use_advanced_search: 是否使用高级检索(MQE + HyDE)

    Returns:
        str: 答案
    """
    if not self.current_document:
        return "⚠️ 请先加载文档!"

    # 【MemoryTool】记录问题到工作记忆
    self.memory_tool.execute(
        "add",
        content=f"提问: {question}",
        memory_type="working",
        importance=0.6,
        session_id=self.session_id
    )

    # 【RAGTool】使用高级检索获取答案
    answer = self.rag_tool.execute(
        "ask",
        question=question,
        limit=5,
        enable_advanced_search=use_advanced_search,
        enable_mqe=use_advanced_search,
        enable_hyde=use_advanced_search
    )

    # 【MemoryTool】记录到情景记忆
    self.memory_tool.execute(
        "add",
        content=f"关于'{question}'的学习",
        memory_type="episodic",
        importance=0.7,
        event_type="qa_interaction",
        session_id=self.session_id
    )

    self.stats["questions_asked"] += 1

    return answer
当我们调用self.rag_tool.execute("ask", ...)时,RAGTool内部执行了以下高级检索流程:
-
多查询扩展(MQE):
# 生成多样化查询
expanded_queries = self._generate_multi_queries(question)
# 例如,对于"什么是大语言模型?",可能生成:
# - "大语言模型的定义是什么?"
# - "请解释一下大语言模型"
# - "LLM是什么意思?"
MQE通过LLM生成语义等价但表述不同的查询,从多个角度理解用户意图,提升召回率30%-50%。
-
假设文档嵌入(HyDE):
- 生成假设答案文档,桥接查询和文档的语义鸿沟
- 使用假设答案的向量进行检索
这些高级检索技术的内部实现在8.3.5节已经详细介绍过。
8.4.4 其他核心功能
除了加载文档和智能问答,我们还需要实现笔记记录、学习回顾、统计查看和报告生成等功能:
def add_note(self, content: str, concept: Optional[str] = None):
    """添加学习笔记"""
    self.memory_tool.execute(
        "add",
        content=content,
        memory_type="semantic",
        importance=0.8,
        concept=concept or "general",
        session_id=self.session_id
    )
    self.stats["concepts_learned"] += 1

def recall(self, query: str, limit: int = 5) -> str:
    """回顾学习历程"""
    result = self.memory_tool.execute(
        "search",
        query=query,
        limit=limit
    )
    return result

def get_stats(self) -> Dict[str, Any]:
    """获取学习统计"""
    duration = (datetime.now() - self.stats["session_start"]).total_seconds()
    return {
        "会话时长": f"{duration:.0f}秒",
        "加载文档": self.stats["documents_loaded"],
        "提问次数": self.stats["questions_asked"],
        "学习笔记": self.stats["concepts_learned"],
        "当前文档": self.current_document or "未加载"
    }

def generate_report(self, save_to_file: bool = True) -> Dict[str, Any]:
    """生成学习报告"""
    memory_summary = self.memory_tool.execute("summary", limit=10)
    rag_stats = self.rag_tool.execute("stats")

    duration = (datetime.now() - self.stats["session_start"]).total_seconds()
    report = {
        "session_info": {
            "session_id": self.session_id,
            "user_id": self.user_id,
            "start_time": self.stats["session_start"].isoformat(),
            "duration_seconds": duration
        },
        "learning_metrics": {
            "documents_loaded": self.stats["documents_loaded"],
            "questions_asked": self.stats["questions_asked"],
            "concepts_learned": self.stats["concepts_learned"]
        },
        "memory_summary": memory_summary,
        "rag_status": rag_stats
    }

    if save_to_file:
        report_file = f"learning_report_{self.session_id}.json"
        with open(report_file, 'w', encoding='utf-8') as f:
            json.dump(report, f, ensure_ascii=False, indent=2, default=str)
        report["report_file"] = report_file

    return report
这些方法分别实现了:
- add_note:将学习笔记保存到语义记忆
- recall:从记忆系统中检索学习历程
- get_stats:获取当前会话的统计信息
- generate_report:生成详细的学习报告并保存为JSON文件
8.4.5 运行效果展示
接下来是运行效果展示,如图8.7所示,进入主页面后需要先初始化助手,也就是加载我们的数据库,模型,API之类的载入操作。后传入PDF文档,并点击加载文档。
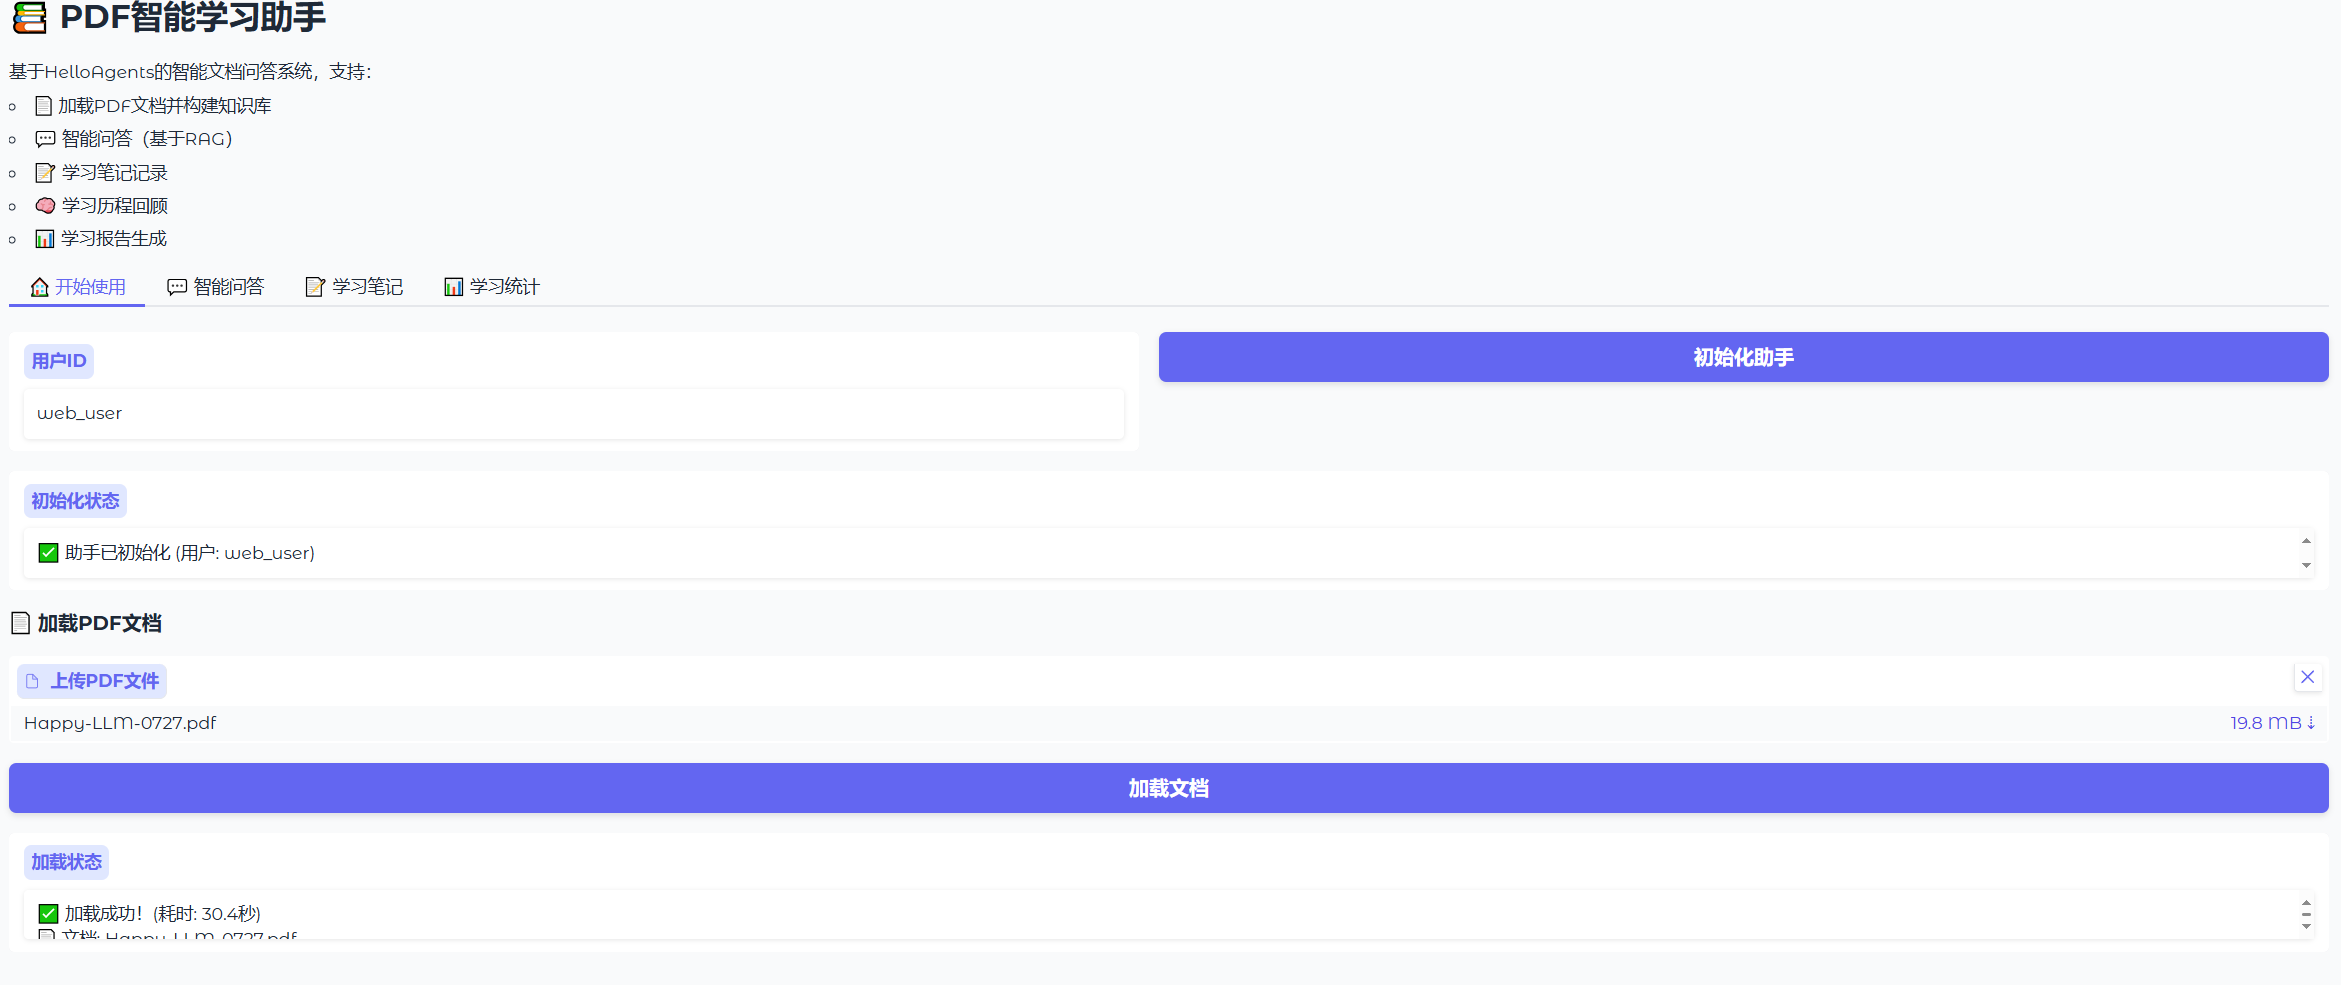
图 8.7 问答助手主页面
第一个功能是智能问答,将可以基于上传的文档进行检索,并返回参考来源和相关资料的相似度计算,这是RAG tool能力的体现,如图8.8所示。
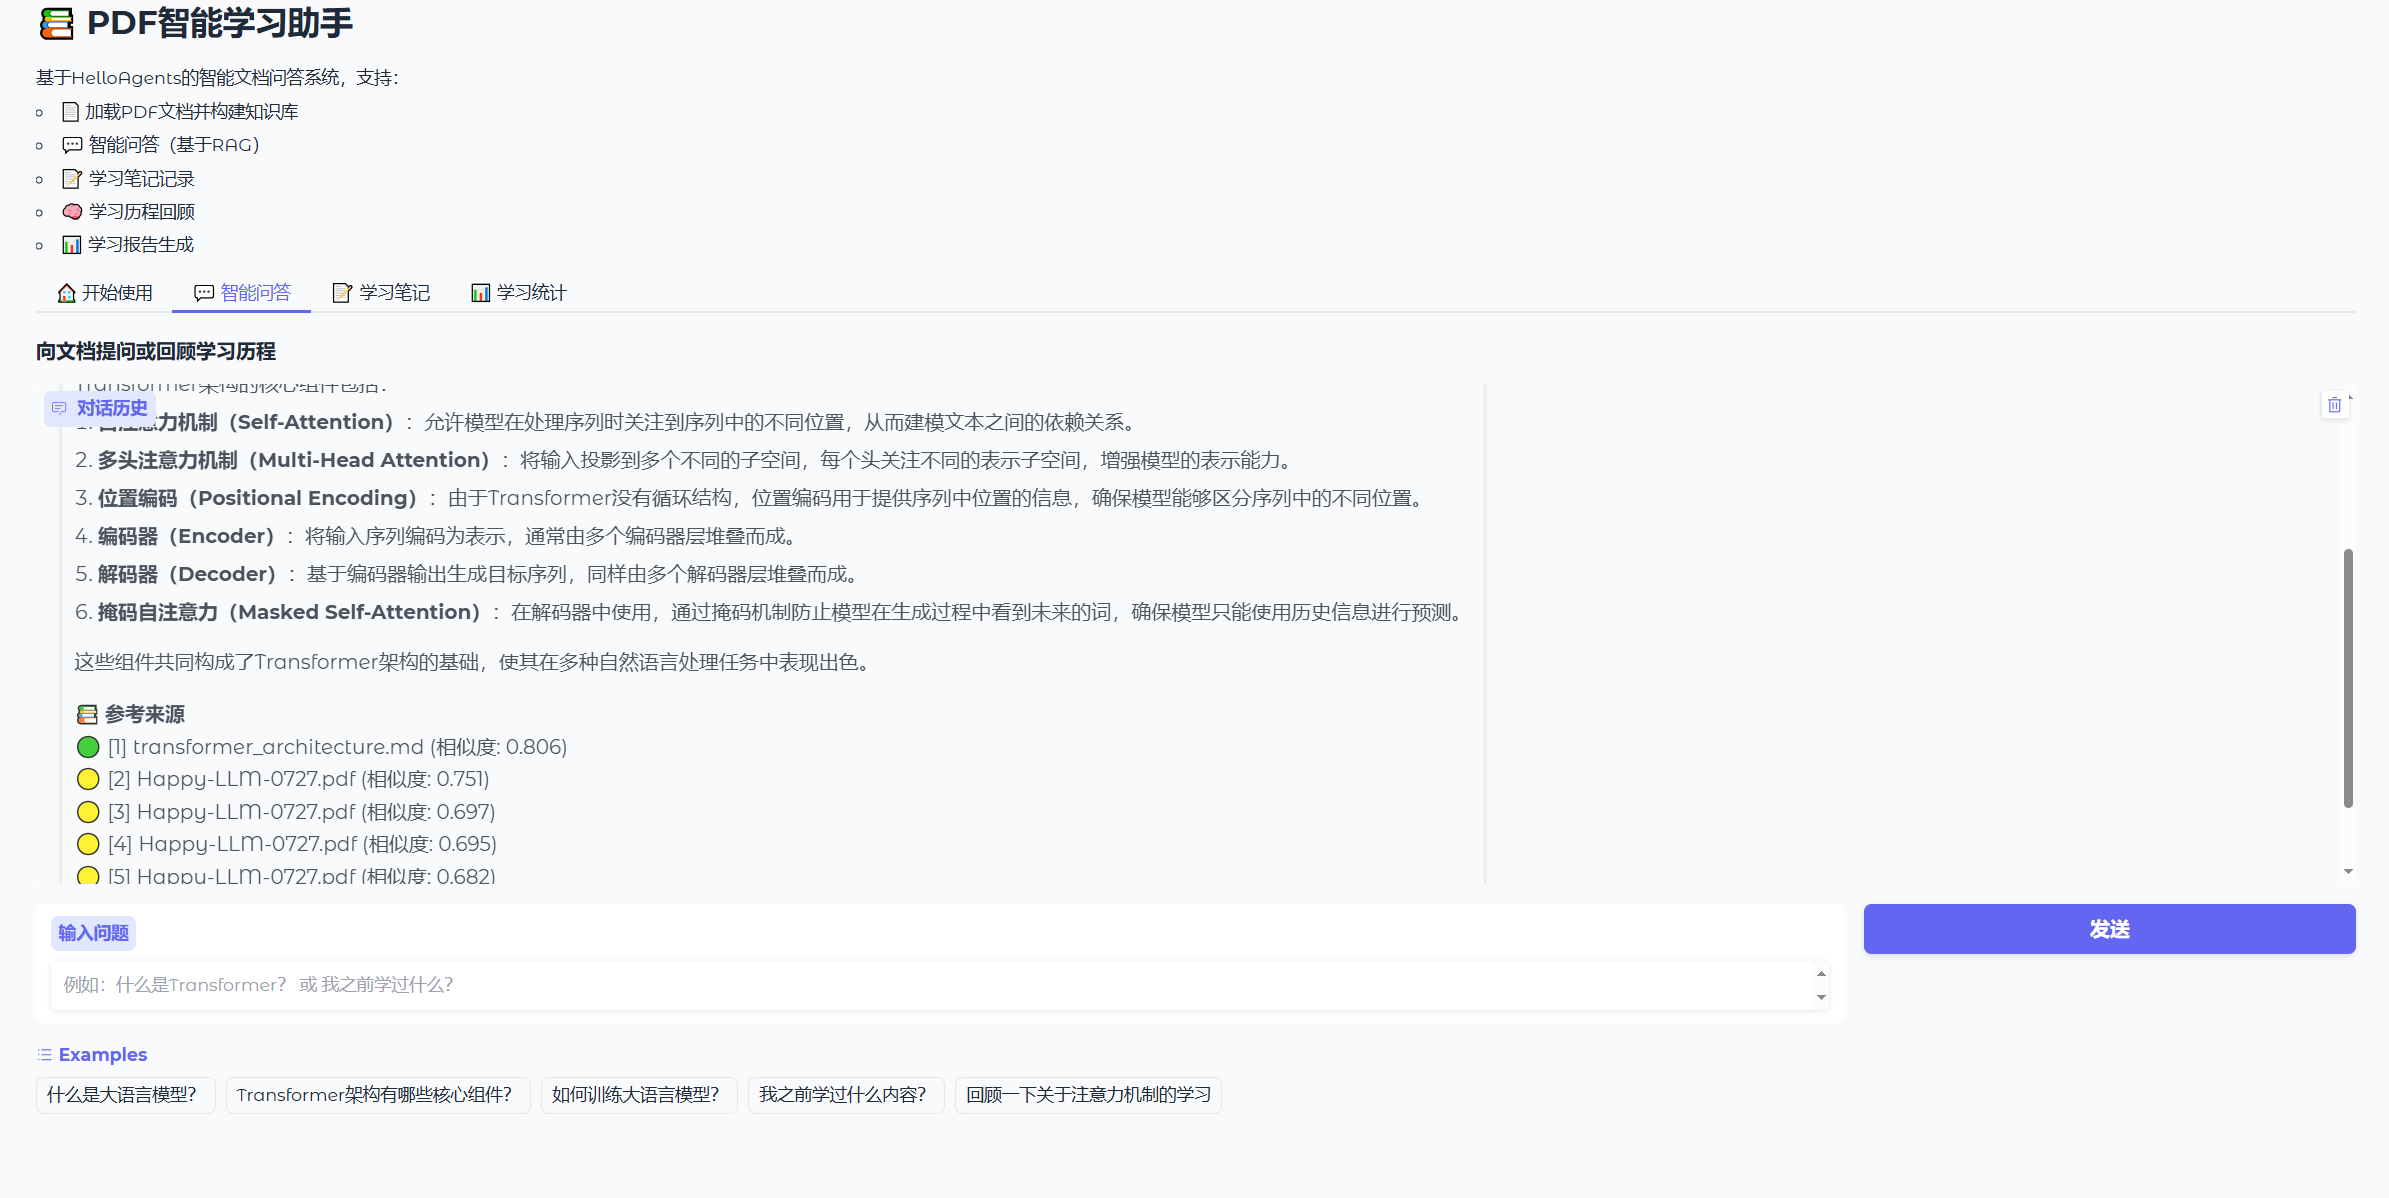
图 8.8 问答助手主页面
第二个功能是学习笔记,如图8.9所示,可以对于相关概念进行勾选,以及撰写笔记内容,这一部分运用到Memory tool,将会存放你的个人笔记在数据库内,方便统计和后续返回整体的学习报告。
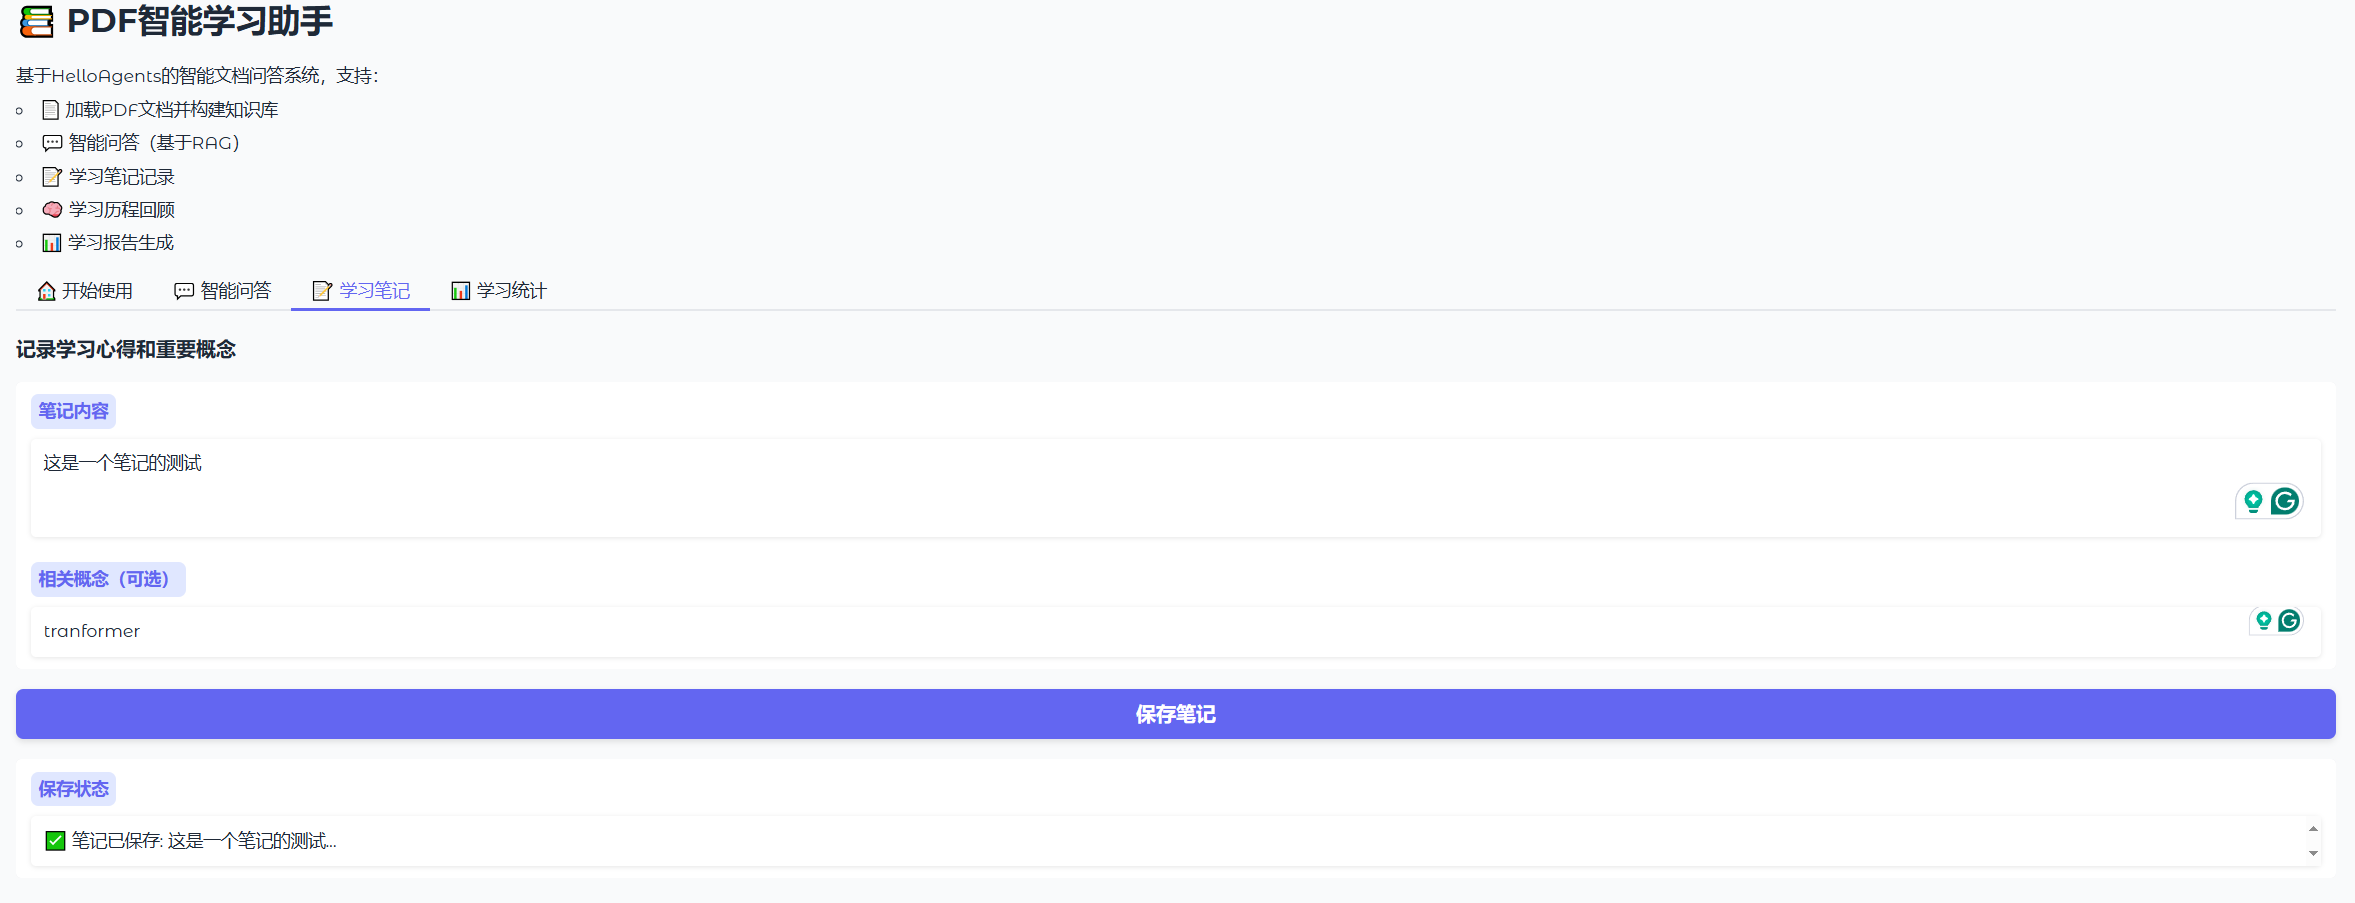
图 8.9 问答助手主页面
最后是学习进度的统计和报告的生成,如图8.10所示,我们将可以看到使用助手期间加载的文档数量,提问次数,和笔记数量,最终将我们的问答结果和笔记整理为一个JSON文档返回。
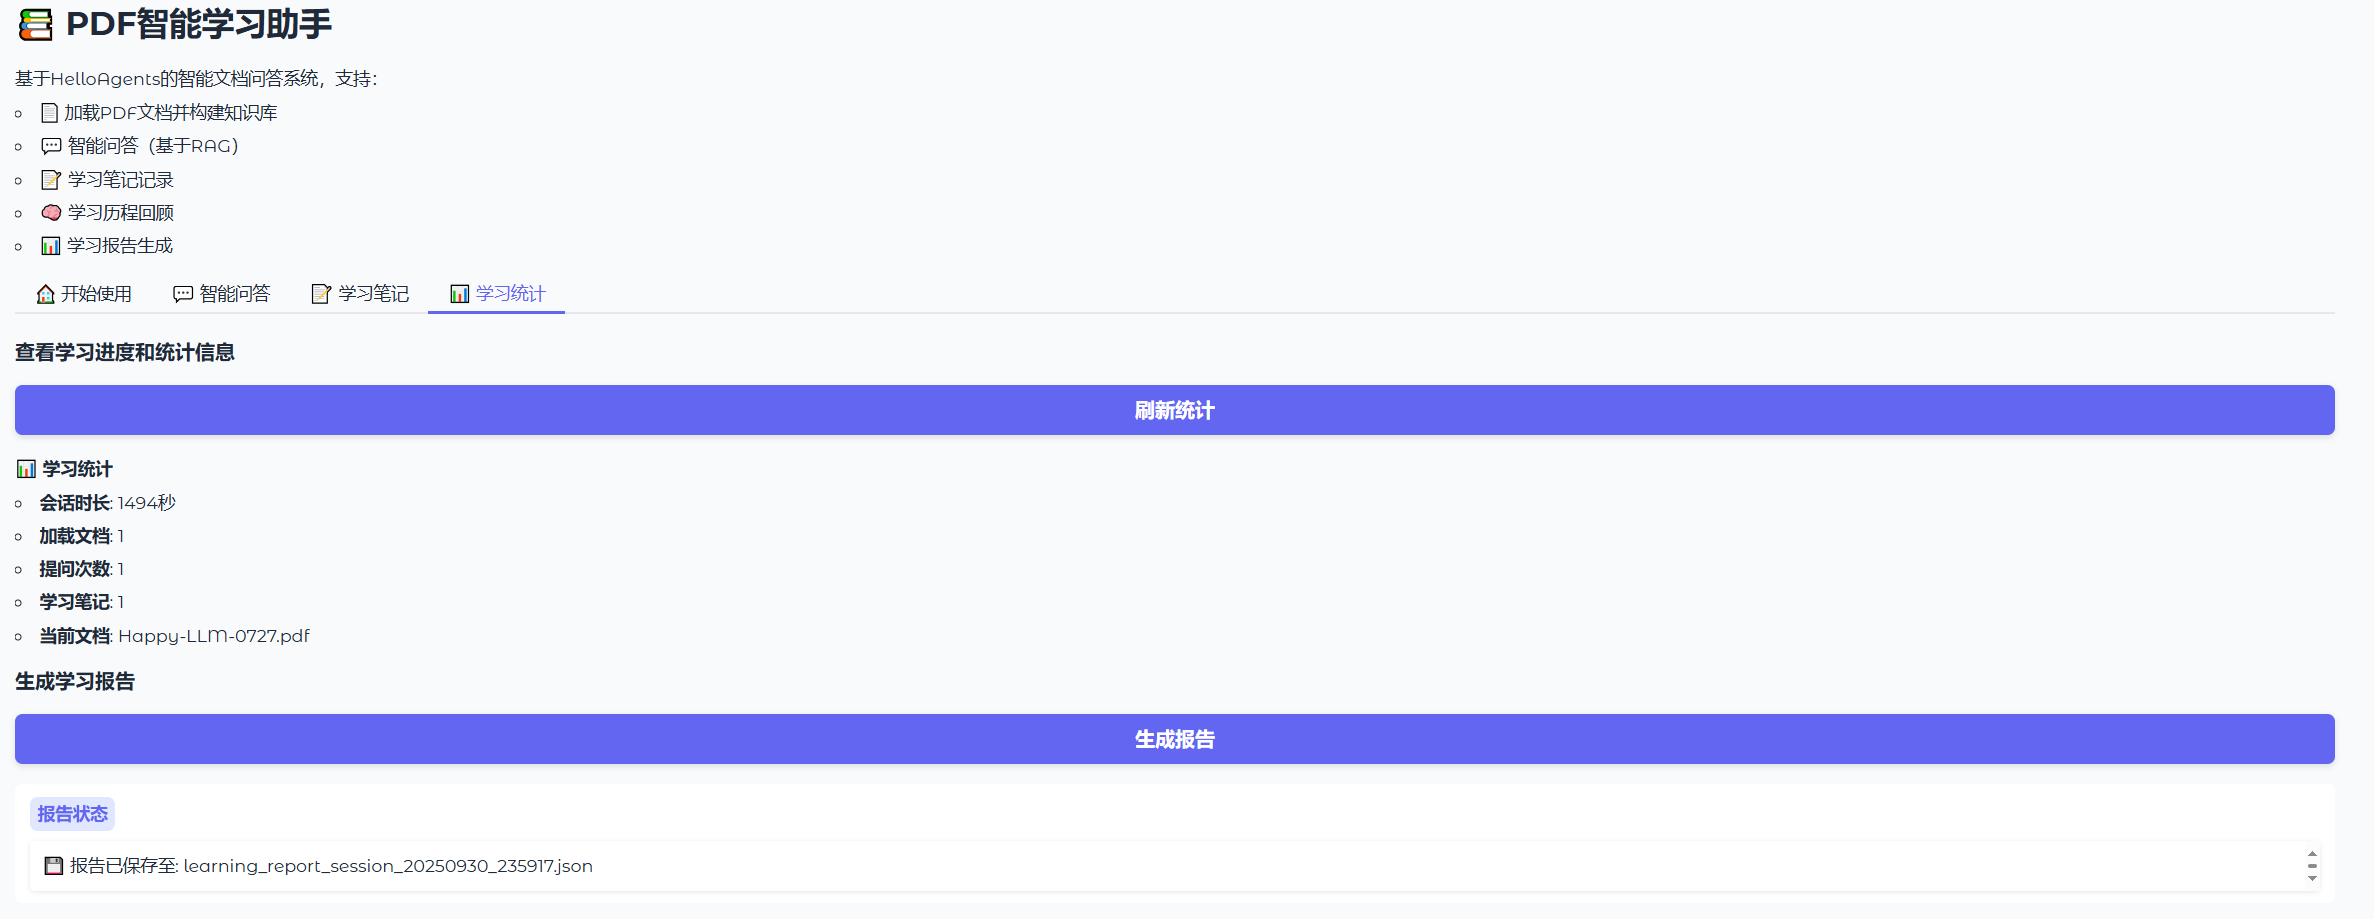
图 8.10 问答助手主页面
通过这个问答助手的案例,我们展示了如何使用RAGTool和MemoryTool构建一个完整的基于Web的智能文档问答系统。完整的代码可以在code/chapter8/11_Q&A_Assistant.py中找到。启动后访问 http://localhost:7860 即可使用这个智能学习助手。
建议读者亲自运行这个案例,体验RAG和Memory的能力,并在此基础上进行扩展和定制,构建符合自己需求的智能应用!