8.3.1 RAG的基础知识
在深入HelloAgents的RAG系统实现之前,让我们先了解RAG技术的基础概念、发展历程和核心原理。由于本文内容不是以RAG为基础进行创作,为此这里只帮读者快速梳理相关概念,以便更好地理解系统设计的技术选择和创新点。
(1)什么是RAG?
检索增强生成(Retrieval-Augmented Generation,RAG)是一种结合了信息检索和文本生成的技术。它的核心思想是:在生成回答之前,先从外部知识库中检索相关信息,然后将检索到的信息作为上下文提供给大语言模型,从而生成更准确、更可靠的回答。
因此,检索增强生成可以拆分为三个词汇。检索是指从知识库中查询相关内容;增强是将检索结果融入提示词,辅助模型生成;生成则输出兼具准确性与透明度的答案。
(2)基本工作流程
一个完整的RAG应用流程主要分为两大核心环节。在数据准备阶段,系统通过数据提取、文本分割和向量化,将外部知识构建成一个可检索的数据库。随后在应用阶段,系统会响应用户的提问,从数据库中检索相关信息,将其注入Prompt,并最终驱动大语言模型生成答案。
(3)发展历程
第一阶段:朴素RAG(Naive RAG, 2020-2021)。这是RAG技术的萌芽阶段,其流程直接而简单,通常被称为“检索-读取”(Retrieve-Read)模式。检索方式:主要依赖传统的关键词匹配算法,如TF-IDF或BM25。这些方法计算词频和文档频率来评估相关性,对字面匹配效果好,但难以理解语义上的相似性。生成模式:将检索到的文档内容不加处理地直接拼接到提示词的上下文中,然后送给生成模型。
第二阶段:高级RAG(Advanced RAG, 2022-2023)。随着向量数据库和文本嵌入技术的成熟,RAG进入了快速发展阶段。研究者和开发者们在“检索”和“生成”的各个环节引入了大量优化技术。检索方式:转向基于稠密嵌入(Dense Embedding)的语义检索。通过将文本转换为高维向量,模型能够理解和匹配语义上的相似性,而不仅仅是关键词。生成模式:引入了很多优化技术,例如查询重写,文档分块,重排序等。
第三阶段:模块化RAG(Modular RAG, 2023-至今)。在高级RAG的基础上,现代RAG系统进一步向着模块化、自动化和智能化的方向发展。系统的各个部分被设计成可插拔、可组合的独立模块,以适应更多样化和复杂的应用场景。检索方式:如混合检索,多查询扩展,假设性文档嵌入等。生成模式:思维链推理,自我反思与修正等。
8.3.2 RAG系统工作原理
在深入实现细节之前,可以通过流程图来梳理Helloagents的RAG系统完整工作流程:
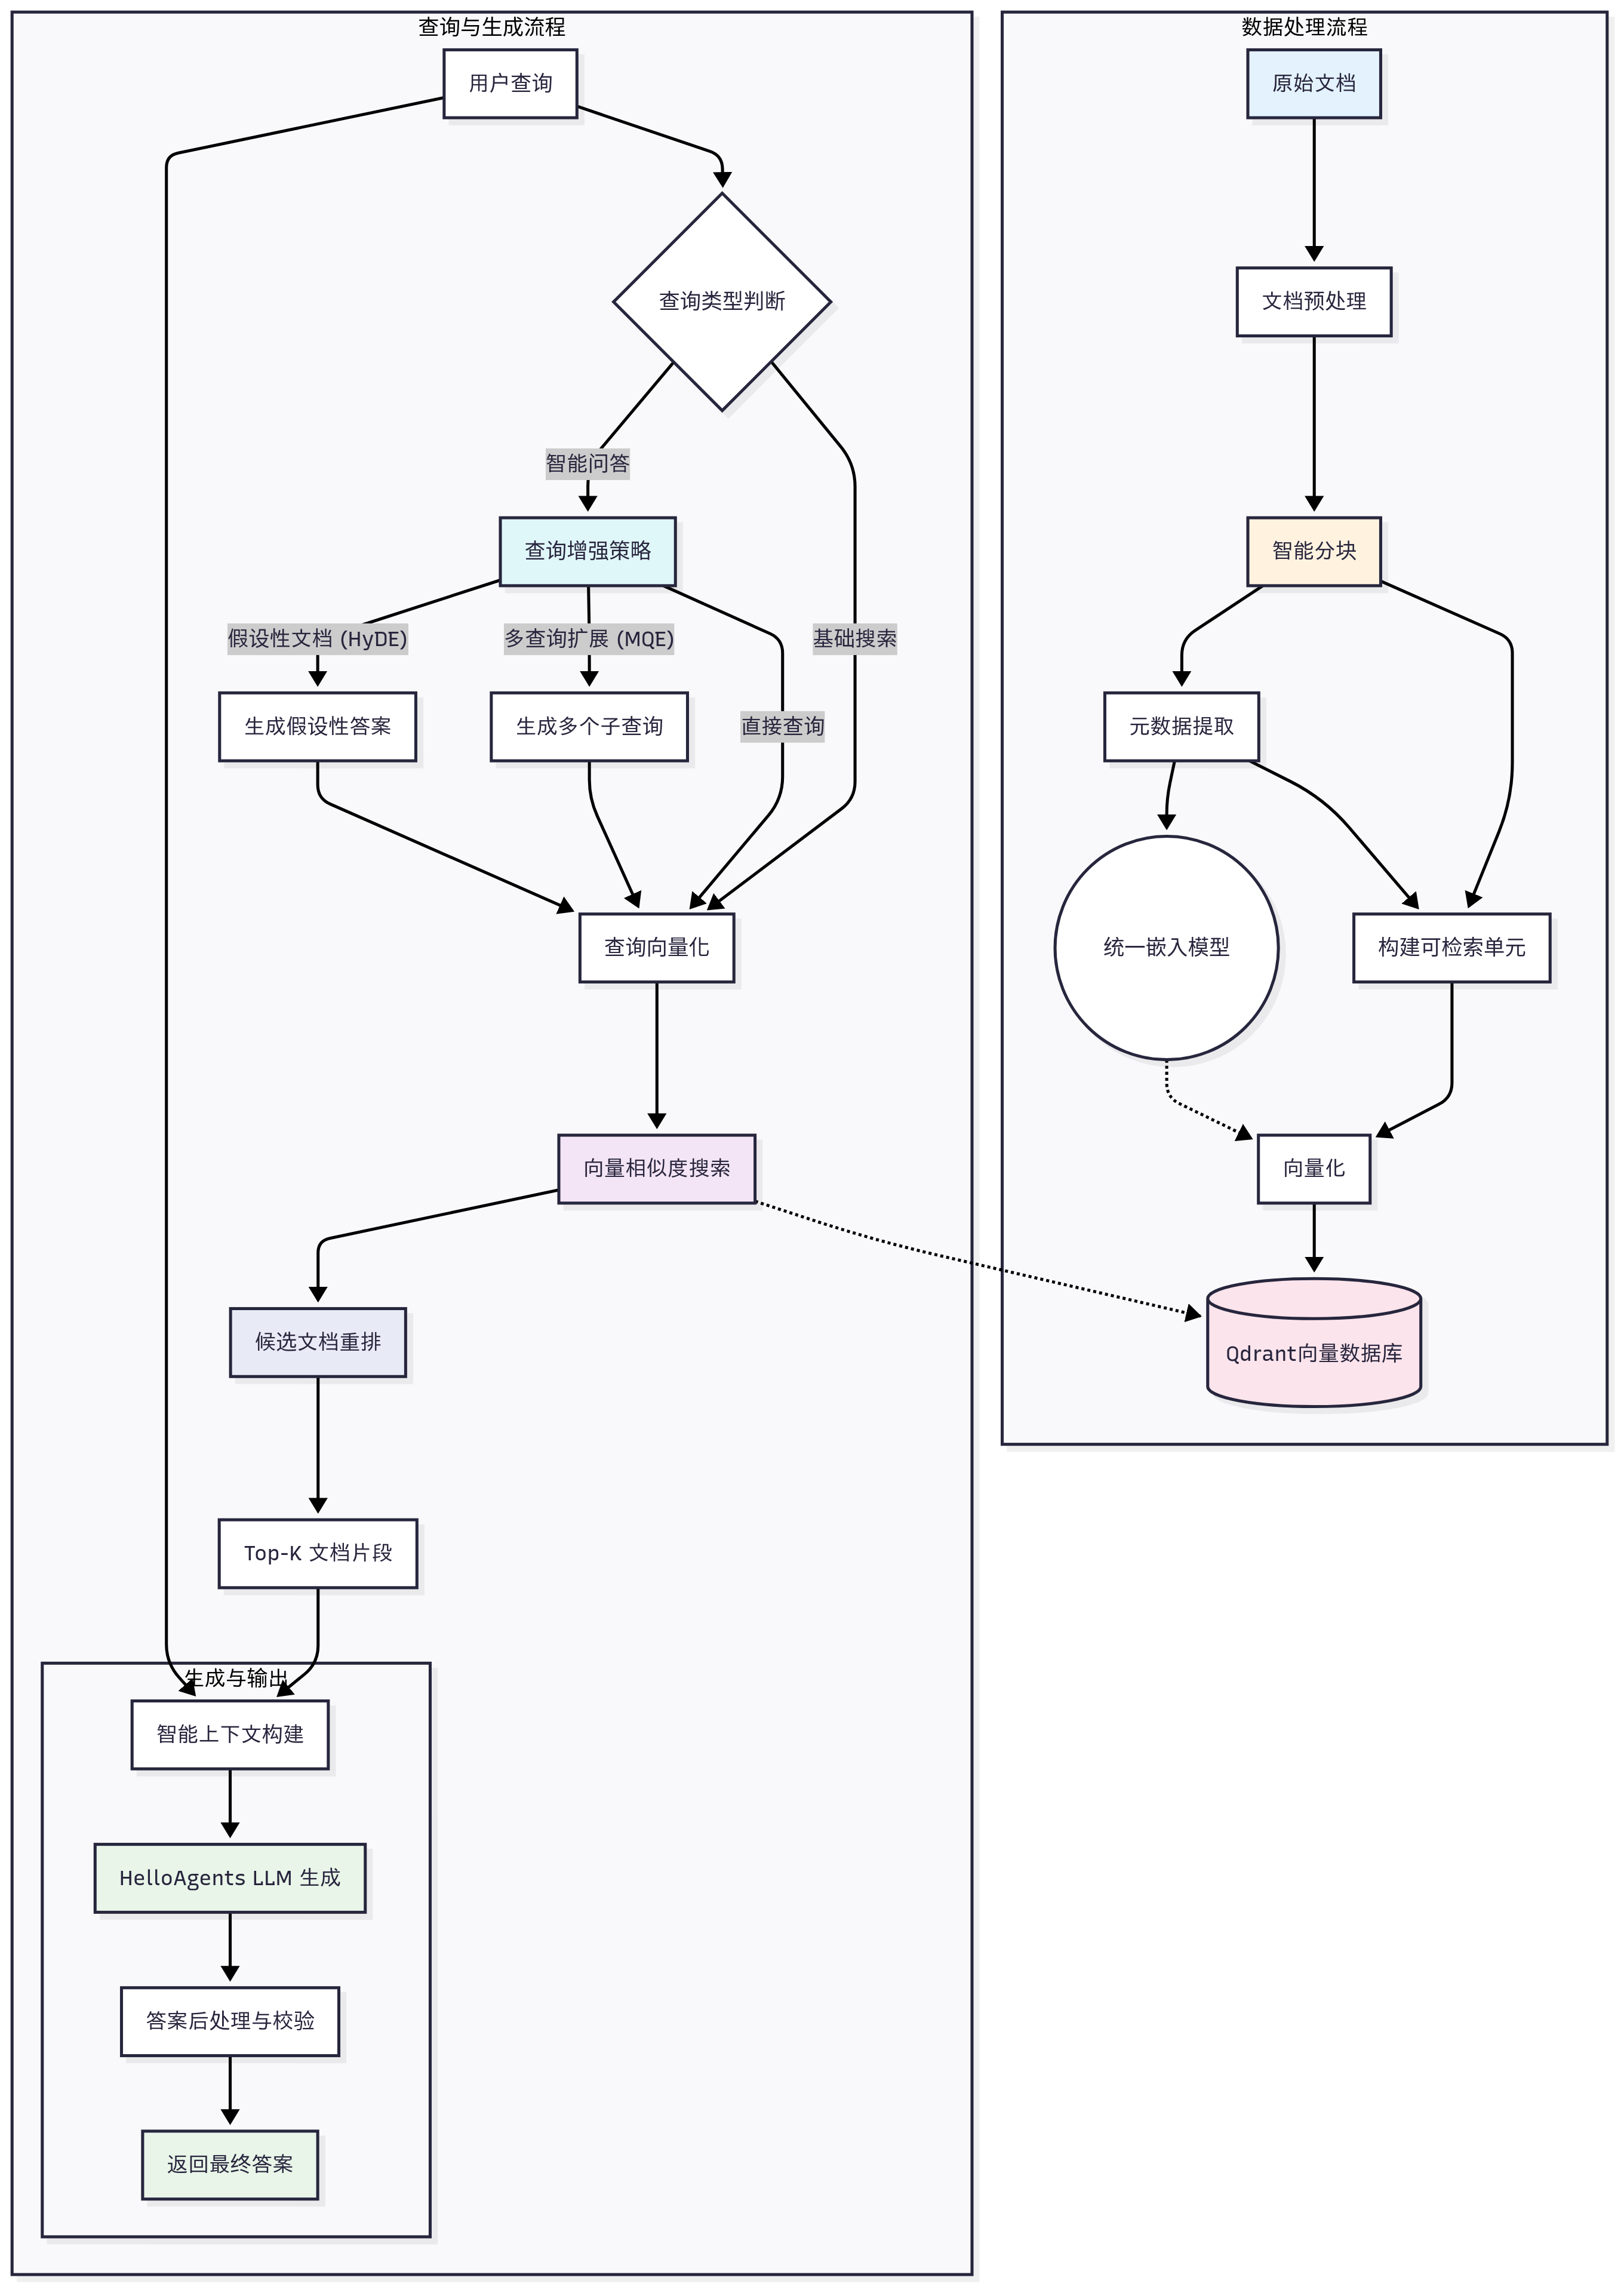
图 8.5 RAG系统的核心工作原理
如图8.5所示,展示了RAG系统的两个主要工作模式:
- 数据处理流程:处理和存储知识文档,在这里我们采取工具
Markitdown,设计思路是将传入的一切外部知识源统一转化为Markdown格式进行处理。 - 查询与生成流程:根据查询检索相关信息并生成回答。
8.3.3 快速体验:30秒上手RAG功能
让我们先快速体验一下RAG系统的基本功能:
from hello_agents import SimpleAgent, HelloAgentsLLM, ToolRegistry
from hello_agents.tools import RAGTool

# 创建LLM实例
llm = HelloAgentsLLM()

# 创建RAG工具
rag_tool = RAGTool(
    knowledge_base_path="./knowledge_base",
    collection_name="test_collection",
    rag_namespace="test"
)

tool_registry = ToolRegistry()
tool_registry.register_tool(rag_tool)

# 创建具有RAG能力的Agent
agent = SimpleAgent(name="知识助手", llm=llm, tool_registry=tool_registry)

# 体验RAG功能
# 添加第一个知识
result1 = rag_tool.execute("add_text",
    text="Python是一种高级编程语言,由Guido van Rossum于1991年首次发布。Python的设计哲学强调代码的可读性和简洁的语法。",
    document_id="python_intro")
print(f"知识1: {result1}")

# 添加第二个知识
result2 = rag_tool.execute("add_text",
    text="机器学习是人工智能的一个分支,通过算法让计算机从数据中学习模式。主要包括监督学习、无监督学习和强化学习三种类型。",
    document_id="ml_basics")
print(f"知识2: {result2}")

# 添加第三个知识
result3 = rag_tool.execute("add_text",
    text="RAG(检索增强生成)是一种结合信息检索和文本生成的AI技术。它通过检索相关知识来增强大语言模型的生成能力。",
    document_id="rag_concept")
print(f"知识3: {result3}")


print("\n=== 搜索知识 ===")
result = rag_tool.execute("search",
    query="Python编程语言的历史",
    limit=3,
    min_score=0.1
)
print(result)

print("\n=== 知识库统计 ===")
result = rag_tool.execute("stats")
print(result)
接下来,我们将深入探讨HelloAgents RAG系统的具体实现。
8.3.4 RAG系统架构设计
在这一节中,我们采取与记忆系统不同的方式讲解。因为Memory_tool是系统性的实现,而RAG在我们的设计中被定义为一种工具,可以梳理为一条pipeline。我们的RAG系统的核心架构可以概括为"五层七步"的设计模式:
用户层:RAGTool统一接口
  ↓
应用层:智能问答、搜索、管理
  ↓
处理层:文档解析、分块、向量化
  ↓
存储层:向量数据库、文档存储
  ↓
基础层:嵌入模型、LLM、数据库
这种分层设计的优势在于每一层都可以独立优化和替换,同时保持整体系统的稳定性。例如,可以轻松地将嵌入模型从sentence-transformers切换到百炼API,而不影响上层的业务逻辑。同样的,这些处理的流程代码是完全可复用的,也可以选取自己需要的部分放进自己的项目中。RAGTool作为RAG系统的统一入口,提供了简洁的API接口。
class RAGTool(Tool):
    """RAG工具

    提供完整的 RAG 能力:
    - 添加多格式文档(PDF、Office、图片、音频等)
    - 智能检索与召回
    - LLM 增强问答
    - 知识库管理
    """

    def __init__(
        self,
        knowledge_base_path: str = "./knowledge_base",
        qdrant_url: str = None,
        qdrant_api_key: str = None,
        collection_name: str = "rag_knowledge_base",
        rag_namespace: str = "default"
    ):
        # 初始化RAG管道
        self._pipelines: Dict[str, Dict[str, Any]] = {}
        self.llm = HelloAgentsLLM()

        # 创建默认管道
        default_pipeline = create_rag_pipeline(
            qdrant_url=self.qdrant_url,
            qdrant_api_key=self.qdrant_api_key,
            collection_name=self.collection_name,
            rag_namespace=self.rag_namespace
        )
        self._pipelines[self.rag_namespace] = default_pipeline
整个处理流程如下所示:
任意格式文档 → MarkItDown转换 → Markdown文本 → 智能分块 → 向量化 → 存储检索
(1)多模态文档载入
RAG系统的核心优势之一是其强大的多模态文档处理能力。系统使用MarkItDown作为统一的文档转换引擎,支持几乎所有常见的文档格式。MarkItDown是微软开源的通用文档转换工具,它是HelloAgents RAG系统的核心组件,负责将任意格式的文档统一转换为结构化的Markdown文本。无论输入是PDF、Word、Excel、图片还是音频,最终都会转换为标准的Markdown格式,然后进入统一的分块、向量化和存储流程。
def _convert_to_markdown(path: str) -> str:
    """
    Universal document reader using MarkItDown with enhanced PDF processing.
    核心功能:将任意格式文档转换为Markdown文本

    支持格式:
    - 文档:PDF、Word、Excel、PowerPoint
    - 图像:JPG、PNG、GIF(通过OCR)
    - 音频:MP3、WAV、M4A(通过转录)
    - 文本:TXT、CSV、JSON、XML、HTML
    - 代码:Python、JavaScript、Java等
    """
    if not os.path.exists(path):
        return ""

    # 对PDF文件使用增强处理
    ext = (os.path.splitext(path)[1] or '').lower()
    if ext == '.pdf':
        return _enhanced_pdf_processing(path)

    # 其他格式使用MarkItDown统一转换
    md_instance = _get_markitdown_instance()
    if md_instance is None:
        return _fallback_text_reader(path)

    try:
        result = md_instance.convert(path)
        markdown_text = getattr(result, "text_content", None)
        if isinstance(markdown_text, str) and markdown_text.strip():
            print(f"[RAG] MarkItDown转换成功: {path} -> {len(markdown_text)} chars Markdown")
            return markdown_text
        return ""
    except Exception as e:
        print(f"[WARNING] MarkItDown转换失败 {path}: {e}")
        return _fallback_text_reader(path)
(2)智能分块策略
经过MarkItDown转换后,所有文档都统一为标准的Markdown格式。这为后续的智能分块提供了结构化的基础。HelloAgents实现了专门针对Markdown格式的智能分块策略,充分利用Markdown的结构化特性进行精确分割。
Markdown结构感知的分块流程:
标准Markdown文本 → 标题层次解析 → 段落语义分割 → Token计算分块 → 重叠策略优化 → 向量化准备
       ↓                ↓              ↓            ↓           ↓            ↓
   统一格式          #/##/###        语义边界      大小控制     信息连续性    嵌入向量
   结构清晰          层次识别        完整性保证    检索优化     上下文保持    相似度匹配
由于所有文档都已转换为Markdown格式,系统可以利用Markdown的标题结构(#、##、###等)进行精确的语义分割:
def _split_paragraphs_with_headings(text: str) -> List[Dict]:
    """根据标题层次分割段落,保持语义完整性"""
    lines = text.splitlines()
    heading_stack: List[str] = []
    paragraphs: List[Dict] = []
    buf: List[str] = []
    char_pos = 0

    def flush_buf(end_pos: int):
        if not buf:
            return
        content = "\n".join(buf).strip()
        if not content:
            return
        paragraphs.append({
            "content": content,
            "heading_path": " > ".join(heading_stack) if heading_stack else None,
            "start": max(0, end_pos - len(content)),
            "end": end_pos,
        })

    for ln in lines:
        raw = ln
        if raw.strip().startswith("#"):
            # 处理标题行
            flush_buf(char_pos)
            level = len(raw) - len(raw.lstrip('#'))
            title = raw.lstrip('#').strip()

            if level <= 0:
                level = 1
            if level <= len(heading_stack):
                heading_stack = heading_stack[:level-1]
            heading_stack.append(title)

            char_pos += len(raw) + 1
            continue

        # 段落内容累积
        if raw.strip() == "":
            flush_buf(char_pos)
            buf = []
        else:
            buf.append(raw)
        char_pos += len(raw) + 1

    flush_buf(char_pos)

    if not paragraphs:
        paragraphs = [{"content": text, "heading_path": None, "start": 0, "end": len(text)}]

    return paragraphs
在Markdown段落分割的基础上,系统进一步根据Token数量进行智能分块。由于输入已经是结构化的Markdown文本,系统可以更精确地控制分块边界,确保每个分块既适合向量化处理,又保持Markdown结构的完整性:
def _chunk_paragraphs(paragraphs: List[Dict], chunk_tokens: int, overlap_tokens: int) -> List[Dict]:
    """基于Token数量的智能分块"""
    chunks: List[Dict] = []
    cur: List[Dict] = []
    cur_tokens = 0
    i = 0

    while i < len(paragraphs):
        p = paragraphs[i]
        p_tokens = _approx_token_len(p["content"]) or 1

        if cur_tokens + p_tokens <= chunk_tokens or not cur:
            cur.append(p)
            cur_tokens += p_tokens
            i += 1
        else:
            # 生成当前分块
            content = "\n\n".join(x["content"] for x in cur)
            start = cur[0]["start"]
            end = cur[-1]["end"]
            heading_path = next((x["heading_path"] for x in reversed(cur) if x.get("heading_path")), None)

            chunks.append({
                "content": content,
                "start": start,
                "end": end,
                "heading_path": heading_path,
            })

            # 构建重叠部分
            if overlap_tokens > 0 and cur:
                kept: List[Dict] = []
                kept_tokens = 0
                for x in reversed(cur):
                    t = _approx_token_len(x["content"]) or 1
                    if kept_tokens + t > overlap_tokens:
                        break
                    kept.append(x)
                    kept_tokens += t
                cur = list(reversed(kept))
                cur_tokens = kept_tokens
            else:
                cur = []
                cur_tokens = 0

    # 处理最后一个分块
    if cur:
        content = "\n\n".join(x["content"] for x in cur)
        start = cur[0]["start"]
        end = cur[-1]["end"]
        heading_path = next((x["heading_path"] for x in reversed(cur) if x.get("heading_path")), None)

        chunks.append({
            "content": content,
            "start": start,
            "end": end,
            "heading_path": heading_path,
        })

    return chunks
同时为了兼容不同语言,系统实现了针对中英文混合文本的Token估算算法,这对于准确控制分块大小至关重要:
def _approx_token_len(text: str) -> int:
    """近似估计Token长度,支持中英文混合"""
    # CJK字符按1 token计算
    cjk = sum(1 for ch in text if _is_cjk(ch))
    # 其他字符按空白分词计算
    non_cjk_tokens = len([t for t in text.split() if t])
    return cjk + non_cjk_tokens

def _is_cjk(ch: str) -> bool:
    """判断是否为CJK字符"""
    code = ord(ch)
    return (
        0x4E00 <= code <= 0x9FFF or  # CJK统一汉字
        0x3400 <= code <= 0x4DBF or  # CJK扩展A
        0x20000 <= code <= 0x2A6DF or # CJK扩展B
        0x2A700 <= code <= 0x2B73F or # CJK扩展C
        0x2B740 <= code <= 0x2B81F or # CJK扩展D
        0x2B820 <= code <= 0x2CEAF or # CJK扩展E
        0xF900 <= code <= 0xFAFF      # CJK兼容汉字
    )
(3)统一嵌入与向量存储
嵌入模型是RAG系统的核心,它负责将文本转换为高维向量,使得计算机能够理解和比较文本的语义相似性。RAG系统的检索能力很大程度上取决于嵌入模型的质量和向量存储的效率。HelloAgents实现了统一的嵌入接口。在这里为了演示,使用百炼API,如果尚未配置可以切换为本地的all-MiniLM-L6-v2模型,如果两种方案都不支持,也配置了TF-IDF算法来兜底。实际使用可以替换为自己想要的模型或者API,也可以尝试去扩展框架内容~
def index_chunks(
    store = None,
    chunks: List[Dict] = None,
    cache_db: Optional[str] = None,
    batch_size: int = 64,
    rag_namespace: str = "default"
) -> None:
    """
    Index markdown chunks with unified embedding and Qdrant storage.
    Uses百炼 API with fallback to sentence-transformers.
    """
    if not chunks:
        print("[RAG] No chunks to index")
        return

    # 使用统一嵌入模型
    embedder = get_text_embedder()
    dimension = get_dimension(384)

    # 创建默认Qdrant存储
    if store is None:
        store = _create_default_vector_store(dimension)
        print(f"[RAG] Created default Qdrant store with dimension {dimension}")

    # 预处理Markdown文本以获得更好的嵌入质量
    processed_texts = []
    for c in chunks:
        raw_content = c["content"]
        processed_content = _preprocess_markdown_for_embedding(raw_content)
        processed_texts.append(processed_content)

    print(f"[RAG] Embedding start: total_texts={len(processed_texts)} batch_size={batch_size}")

    # 批量编码
    vecs: List[List[float]] = []
    for i in range(0, len(processed_texts), batch_size):
        part = processed_texts[i:i+batch_size]
        try:
            # 使用统一嵌入器(内部处理缓存)
            part_vecs = embedder.encode(part)

            # 标准化为List[List[float]]格式
            if not isinstance(part_vecs, list):
                if hasattr(part_vecs, "tolist"):
                    part_vecs = [part_vecs.tolist()]
                else:
                    part_vecs = [list(part_vecs)]

            # 处理向量格式和维度
            for v in part_vecs:
                try:
                    if hasattr(v, "tolist"):
                        v = v.tolist()
                    v_norm = [float(x) for x in v]

                    # 维度检查和调整
                    if len(v_norm) != dimension:
                        print(f"[WARNING] 向量维度异常: 期望{dimension}, 实际{len(v_norm)}")
                        if len(v_norm) < dimension:
                            v_norm.extend([0.0] * (dimension - len(v_norm)))
                        else:
                            v_norm = v_norm[:dimension]

                    vecs.append(v_norm)
                except Exception as e:
                    print(f"[WARNING] 向量转换失败: {e}, 使用零向量")
                    vecs.append([0.0] * dimension)

        except Exception as e:
            print(f"[WARNING] Batch {i} encoding failed: {e}")
            # 实现重试机制
            # ... 重试逻辑 ...

        print(f"[RAG] Embedding progress: {min(i+batch_size, len(processed_texts))}/{len(processed_texts)}")
8.3.5 高级检索策略
RAG系统的检索能力是其核心竞争力。在实际应用中,用户的查询表述与文档中的实际内容可能存在用词差异,导致相关文档无法被检索到。为了解决这个问题,HelloAgents实现了三种互补的高级检索策略:多查询扩展(MQE)、假设文档嵌入(HyDE)和统一的扩展检索框架。
(1)多查询扩展(MQE)
多查询扩展(Multi-Query Expansion)是一种通过生成语义等价的多样化查询来提高检索召回率的技术。这种方法的核心洞察是:同一个问题可以有多种不同的表述方式,而不同的表述可能匹配到不同的相关文档。例如,"如何学习Python"可以扩展为"Python入门教程"、"Python学习方法"、"Python编程指南"等多个查询。通过并行执行这些扩展查询并合并结果,系统能够覆盖更广泛的相关文档,避免因用词差异而遗漏重要信息。
MQE的优势在于它能够自动理解用户查询的多种可能含义,特别是对于模糊查询或专业术语查询效果显著。系统使用LLM生成扩展查询,确保扩展的多样性和语义相关性:
def _prompt_mqe(query: str, n: int) -> List[str]:
    """使用LLM生成多样化的查询扩展"""
    try:
        from ...core.llm import HelloAgentsLLM
        llm = HelloAgentsLLM()
        prompt = [
            {"role": "system", "content": "你是检索查询扩展助手。生成语义等价或互补的多样化查询。使用中文,简短,避免标点。"},
            {"role": "user", "content": f"原始查询:{query}\n请给出{n}个不同表述的查询,每行一个。"}
        ]
        text = llm.invoke(prompt)
        lines = [ln.strip("- \t") for ln in (text or "").splitlines()]
        outs = [ln for ln in lines if ln]
        return outs[:n] or [query]
    except Exception:
        return [query]
(2)假设文档嵌入(HyDE)
假设文档嵌入(Hypothetical Document Embeddings,HyDE)是一种创新的检索技术,它的核心思想是"用答案找答案"。传统的检索方法是用问题去匹配文档,但问题和答案在语义空间中的分布往往存在差异——问题通常是疑问句,而文档内容是陈述句。HyDE通过让LLM先生成一个假设性的答案段落,然后用这个答案段落去检索真实文档,从而缩小了查询和文档之间的语义鸿沟。
这种方法的优势在于,假设答案与真实答案在语义空间中更加接近,因此能够更准确地匹配到相关文档。即使假设答案的内容不完全正确,它所包含的关键术语、概念和表述风格也能有效引导检索系统找到正确的文档。特别是对于专业领域的查询,HyDE能够生成包含领域术语的假设文档,显著提升检索精度:
def _prompt_hyde(query: str) -> Optional[str]:
    """生成假设性文档用于改善检索"""
    try:
        from ...core.llm import HelloAgentsLLM
        llm = HelloAgentsLLM()
        prompt = [
            {"role": "system", "content": "根据用户问题,先写一段可能的答案性段落,用于向量检索的查询文档(不要分析过程)。"},
            {"role": "user", "content": f"问题:{query}\n请直接写一段中等长度、客观、包含关键术语的段落。"}
        ]
        return llm.invoke(prompt)
    except Exception:
        return None
(3)扩展检索框架
HelloAgents将MQE和HyDE两种策略整合到统一的扩展检索框架中。系统通过enable_mqe和enable_hyde参数让用户可以根据具体场景选择启用哪些策略:对于需要高召回率的场景可以同时启用两种策略,对于性能敏感的场景可以只使用基础检索。
扩展检索的核心机制是"扩展-检索-合并"三步流程。首先,系统根据原始查询生成多个扩展查询(包括MQE生成的多样化查询和HyDE生成的假设文档);然后,对每个扩展查询并行执行向量检索,获取候选文档池;最后,通过去重和分数排序合并所有结果,返回最相关的top-k文档。这种设计的巧妙之处在于,它通过candidate_pool_multiplier参数(默认为4)扩大候选池,确保有足够的候选文档进行筛选,同时通过智能去重避免返回重复内容。
def search_vectors_expanded(
    store = None,
    query: str = "",
    top_k: int = 8,
    rag_namespace: Optional[str] = None,
    only_rag_data: bool = True,
    score_threshold: Optional[float] = None,
    enable_mqe: bool = False,
    mqe_expansions: int = 2,
    enable_hyde: bool = False,
    candidate_pool_multiplier: int = 4,
) -> List[Dict]:
    """
    Search with query expansion using unified embedding and Qdrant.
    """
    if not query:
        return []

    # 创建默认存储
    if store is None:
        store = _create_default_vector_store()

    # 查询扩展
    expansions: List[str] = [query]

    if enable_mqe and mqe_expansions > 0:
        expansions.extend(_prompt_mqe(query, mqe_expansions))
    if enable_hyde:
        hyde_text = _prompt_hyde(query)
        if hyde_text:
            expansions.append(hyde_text)

    # 去重和修剪
    uniq: List[str] = []
    for e in expansions:
        if e and e not in uniq:
            uniq.append(e)
    expansions = uniq[: max(1, len(uniq))]

    # 分配候选池
    pool = max(top_k * candidate_pool_multiplier, 20)
    per = max(1, pool // max(1, len(expansions)))

    # 构建RAG数据过滤器
    where = {"memory_type": "rag_chunk"}
    if only_rag_data:
        where["is_rag_data"] = True
        where["data_source"] = "rag_pipeline"
    if rag_namespace:
        where["rag_namespace"] = rag_namespace

    # 收集所有扩展查询的结果
    agg: Dict[str, Dict] = {}
    for q in expansions:
        qv = embed_query(q)
        hits = store.search_similar(
            query_vector=qv,
            limit=per,
            score_threshold=score_threshold,
            where=where
        )
        for h in hits:
            mid = h.get("metadata", {}).get("memory_id", h.get("id"))
            s = float(h.get("score", 0.0))
            if mid not in agg or s > float(agg[mid].get("score", 0.0)):
                agg[mid] = h

    # 按分数排序返回
    merged = list(agg.values())
    merged.sort(key=lambda x: float(x.get("score", 0.0)), reverse=True)
    return merged[:top_k]
实际应用中,这三种策略的组合使用效果最佳。MQE擅长处理用词多样性问题,HyDE擅长处理语义鸿沟问题,而统一框架则确保了结果的质量和多样性。对于一般查询,建议启用MQE;对于专业领域查询,建议同时启用MQE和HyDE;对于性能敏感场景,可以只使用基础检索或仅启用MQE。
当然还有很多有趣的方法,这里只是为大家适当的扩展介绍,在实际的使用场景里也需要去尝试寻找适合问题的解决方案。